


生成AI
最終更新日:2026/10/16
「Muse Glimmer」というAIモデルの名前を、ニュースやSNSで見かけた方も多いのではないでしょうか。Metaが2026年8月10日に公開した、ローカル実行を想定したAIエージェント向けの新モデルです。無料で商用利用できるのか、専門知識がなくても導入できるのか、気になるところです。
本記事では、Muse Glimmerの基本スペックと料金・ライセンスを整理します。あわせて、DX担当者が自社導入を判断する際のポイントもわかりやすく解説します。
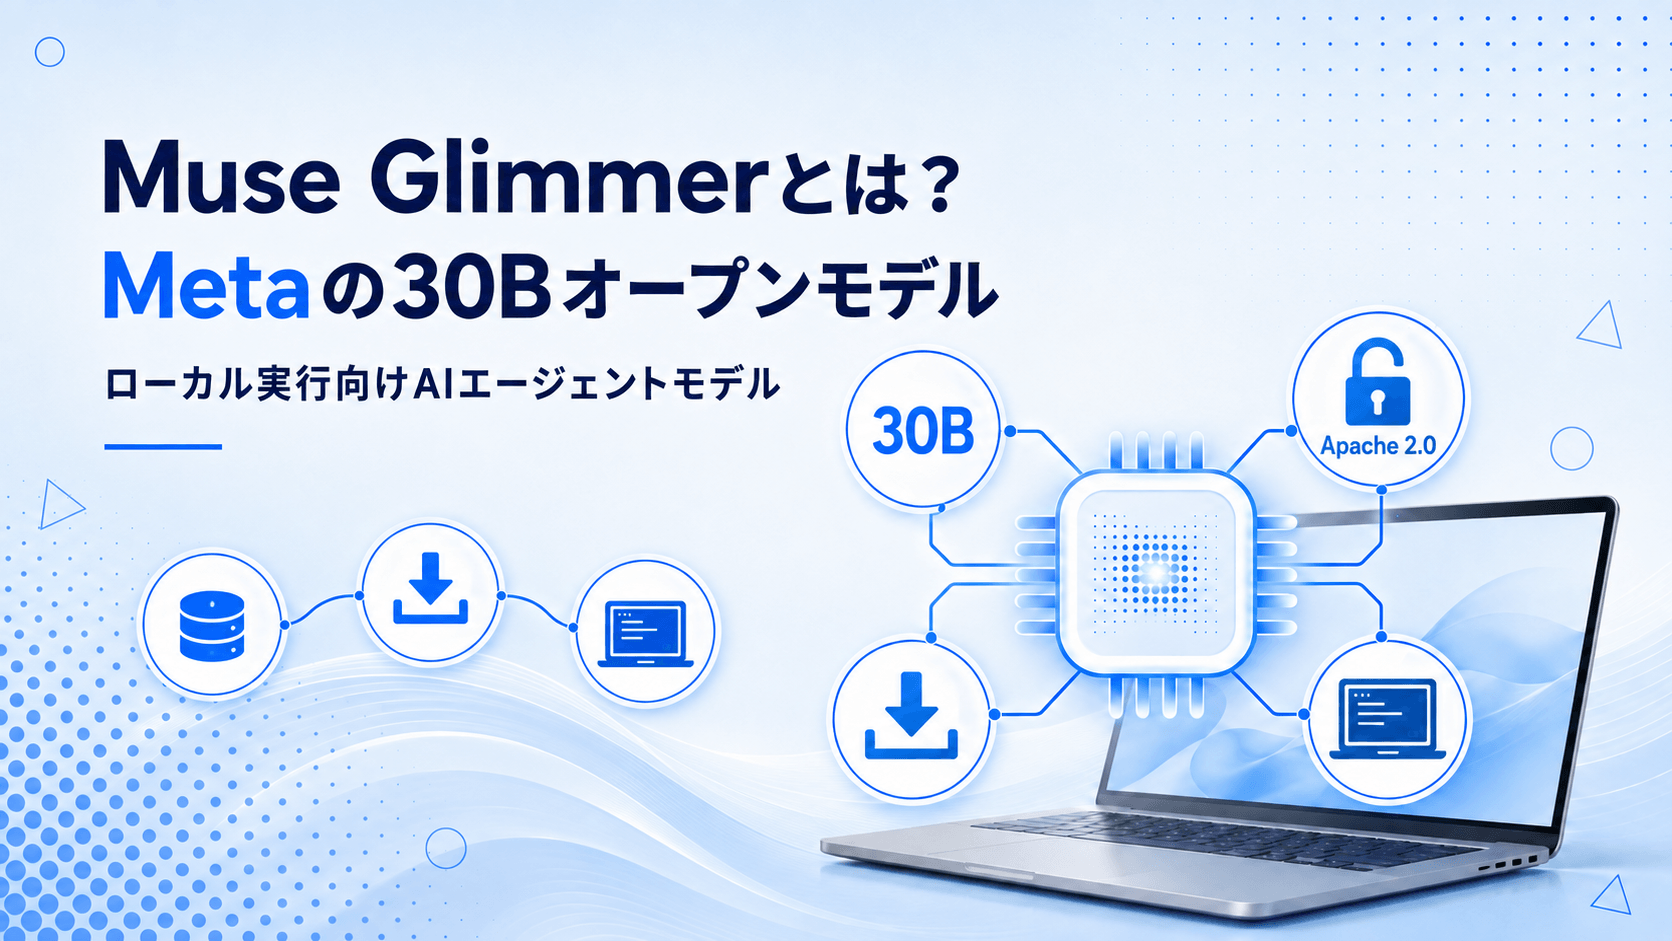
Muse Glimmerとは、Meta Superintelligence Labsが2026年8月10日に公開したAIモデルです。ライセンスはApache 2.0で、総パラメータ数は約29.6B(約296億、丸めると約300億)にのぼります。
オープンウェイトとは、学習済みモデルの「重み」をダウンロードして利用できる公開形態を指します。学習データや開発工程まですべて公開されているとは限らない点は、一般的なオープンソースソフトウェアとの違いです。
ローカル実行を前提に設計されており、クラウドのAPIに接続しなくても、Macや対応GPUを搭載したPCでAIエージェントを動かせます。もっとも、量子化版でも24GBまたは32GBクラスのメモリ環境がターゲットとされているため、一般的な事務用PCでそのまま動くわけではありません。
Muse Glimmerは、Metaの上位モデル「Muse Spark」の出力を利用した蒸留によって学習されたモデルです。
蒸留とは、性能の高い大きなモデル(教師モデル)の出力を、小さなモデルに模倣させて学習させる手法を指します。教師モデルの推論能力や出力傾向を小型モデルへ移すことで、ローカル環境でも実用的な性能を発揮できるように設計されています。
Muse Glimmerは、テキストだけでなく画像も入力できるマルチモーダルモデルです。AIエージェント(人に代わって自律的にタスクをこなすAI)の用途に最適化されています。まずは基本スペックを表で確認していきましょう。
| 項目 | 内容 |
| 開発元 | Meta(Meta Superintelligence Labs) |
| 公開日 | 2026年8月10日 |
| ライセンス | Apache 2.0(商用利用可) |
| 総パラメータ数 | 約296億(うち視覚エンコーダ約18億) |
| アーキテクチャ | Dense(密)構造のTransformer+知覚エンコーダ |
| コンテキスト長 | 131,072トークン以上 |
| 多言語対応 | 100以上の言語を含むデータで学習(すべての言語で性能評価済みではない) |
| 入力/出力 | テキスト+画像 / テキストのみ |
| 知識カットオフ | 2026年1月4日 |
※公式モデルカード(2026年8月時点)に基づきます。
Muse GlimmerはDense(すべてのパラメータを毎回使う方式)のTransformerを採用しています。MoE(複数の専門モデルを切り替えて使う方式)ではない点が、実務上のポイントです。
ただし、必要メモリは量子化後のモデルファイル容量だけでは決まりません。推論時にはKVキャッシュ(会話の文脈を保持する一時領域)や、画像認識用の知覚エンコーダなどもメモリを使用します。
Metaは約4bitの量子化によって言語モデルの重みを20GB未満に圧縮し、KVキャッシュや知覚エンコーダなどを含めて24GBまたは32GBクラスのメモリ環境で動作させる構成を公開しています。
出典:Introducing Muse Glimmer: An Open Agentic Model That Runs on Your Device|Meta AI Research
公式が挙げているMuse Glimmerの主な用途は、次のとおりです。
チャット用途の汎用AIというよりも、ツールを操作しながら仕事を完遂させる「エージェントの司令塔役」として設計されているモデルだといえるでしょう。
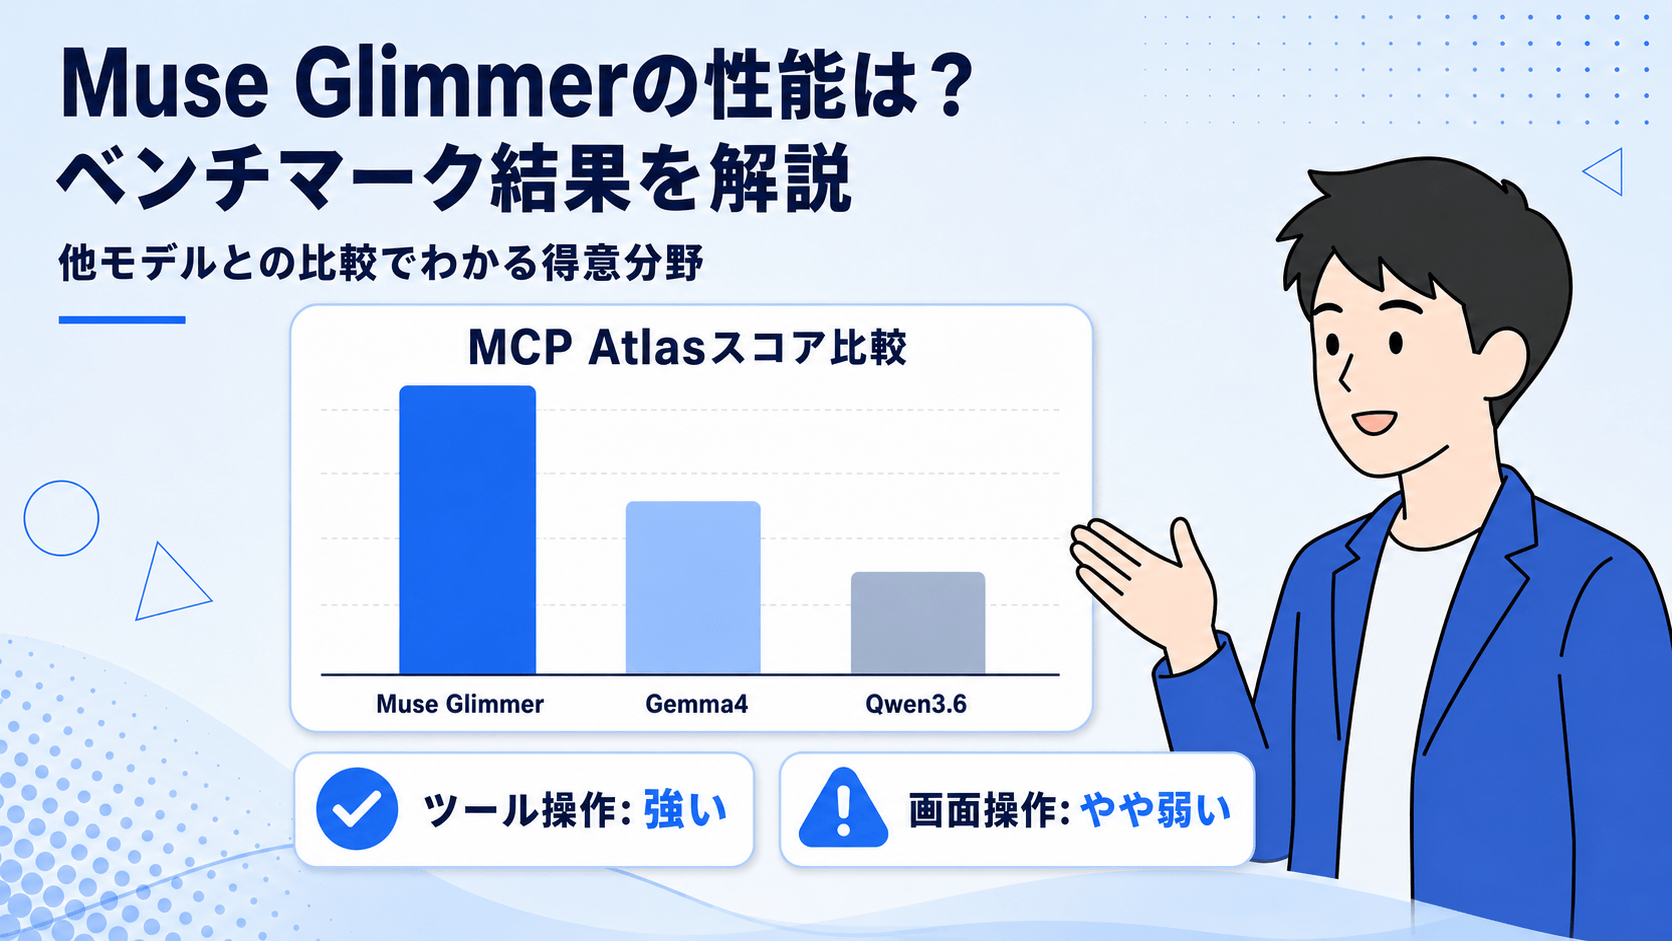
性能面では、同じくローカルで動かせるオープンモデルのGemma4-31BやQwen3.6-27Bと比較したベンチマークが公式に公開されています。
結論からいうと、ツールを使いこなして複数の作業をまとめ上げる領域では強みを見せます。一方で、パソコンの画面操作やターミナル作業の自動化ではやや見劣りするという、得意不得意がはっきりしたモデルです。
| ベンチマーク | 内容 | Muse Glimmer-30B | Gemma4-31B | Qwen3.6-27B |
| MCP Atlas | MCPを利用したエージェントタスク | 75.5 | 54.2 | 62.5 |
| DeepSearch QA | 複数ステップの調査タスク | 74.6 | 61.7 | 71.1 |
| AA-LCR | 長文の読解・要約 | 80.0 | 68.3 | 73.3 |
| AIME 2026 | 数学的推論 | 94.7 | 89.2 | 94.1 |
| SWE-Bench Pro | コードの生成・修正 | 51.2 | 36.9 | 50.2 |
| OSWorld-Verified | 画面操作の自動化 | 65.9 | 58.5 | 75.6 |
| TerminalBench 2.1 | ターミナル上の実務タスク | 51.7 | 43.4 | 60.7 |
※公式モデルカード(2026年8月時点)に基づきます。
MCPを利用するエージェント能力を評価するMCP Atlasでは75.5を記録し、Metaが同条件で比較したGemma4-31Bの54.2、Qwen3.6-27Bの62.5を上回っています。長文の資料を読み込んで判断する場面や、複数のツールを順序立てて操作する場面でも、比較対象の2モデルより高いスコアです。
一方で、画面を見てクリックする操作の自動化(OSWorld-Verified)やターミナル作業の自動化では、Qwen3.6-27Bのほうが高いスコアを示しています。自社での用途が「情報整理・資料分析中心」か「画面操作の自動化中心」かによって、向き不向きが分かれる点を覚えておきましょう。
なお、これらはあくまでMetaが公式に比較したGemma4-31B・Qwen3.6-27Bとの相対評価であり、市場全体を網羅したランキングではありません。
出典:Muse Glimmer Model Card|Hugging Face
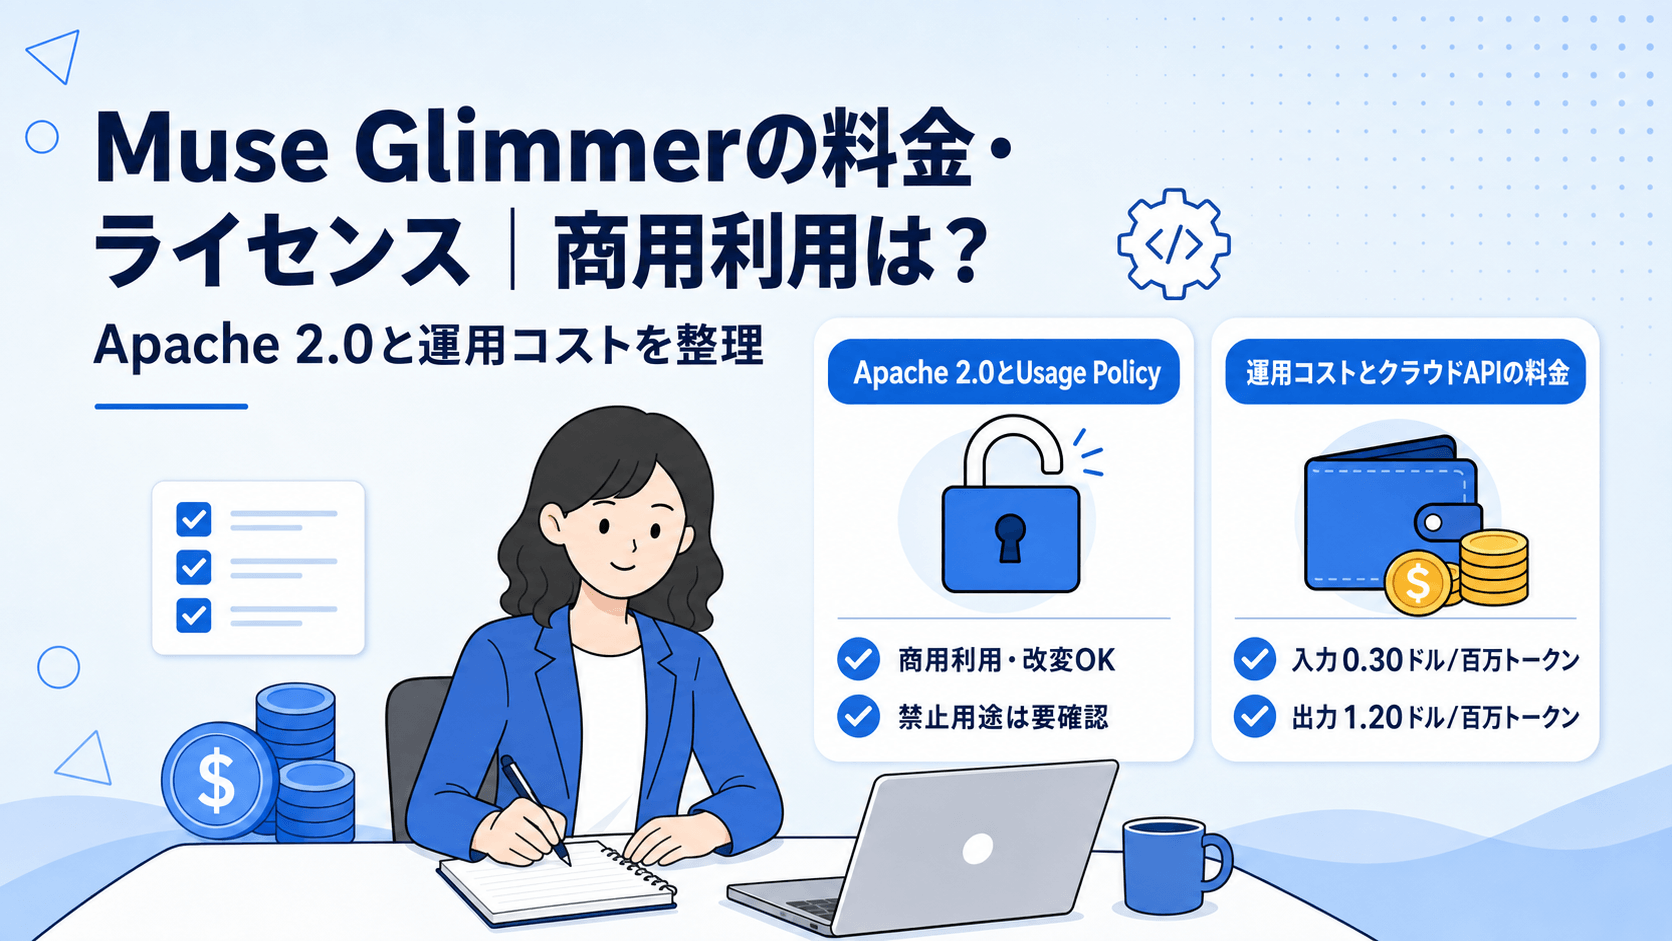
Muse Glimmerのモデル成果物はApache 2.0で公開されており、商用利用・改変・再配布が可能です。
なお、MetaはMuse Glimmer向けに別途「Usage Policy」も公開しており、違法行為や一部の高リスク用途、プライバシー侵害などを禁止しています。企業で利用する場合は、Apache 2.0だけでなくUsage Policyと自社の利用目的をあわせて確認してください。
ローカル実行ではモデル利用そのものに従量課金はありませんが、GPU搭載機器の購入費や電力に加え、構築・保守、監視、アップデート、セキュリティ対策などの運用コストが発生します。クラウドAPIとの比較では、トークン単価だけでなくTCO(総保有コスト)で判断することが重要です。
自社でGPUを用意せず、OpenRouterなどのサードパーティAPI経由で利用する方法もあります。たとえばOpenRouterでは、2026年8月時点でMuse Glimmer 30Bを入力100万トークンあたり0.30ドル、出力100万トークンあたり1.20ドルと表示しています。
なお、Apache 2.0では成果物は「AS IS(現状有姿)」で提供され、明示・黙示の保証はありません。また、利用や再配布が適切かどうかは利用者自身で判断し、それに伴うリスクを負うことが定められています。企業で利用する場合は、Usage Policyや自社の法務・セキュリティ要件もあわせて確認してください。
出典:Apache License 2.0|Apache Software Foundation / Muse Glimmer Usage Policy|Meta Inc. / Muse Glimmer 30B – API Pricing & Providers|OpenRouter
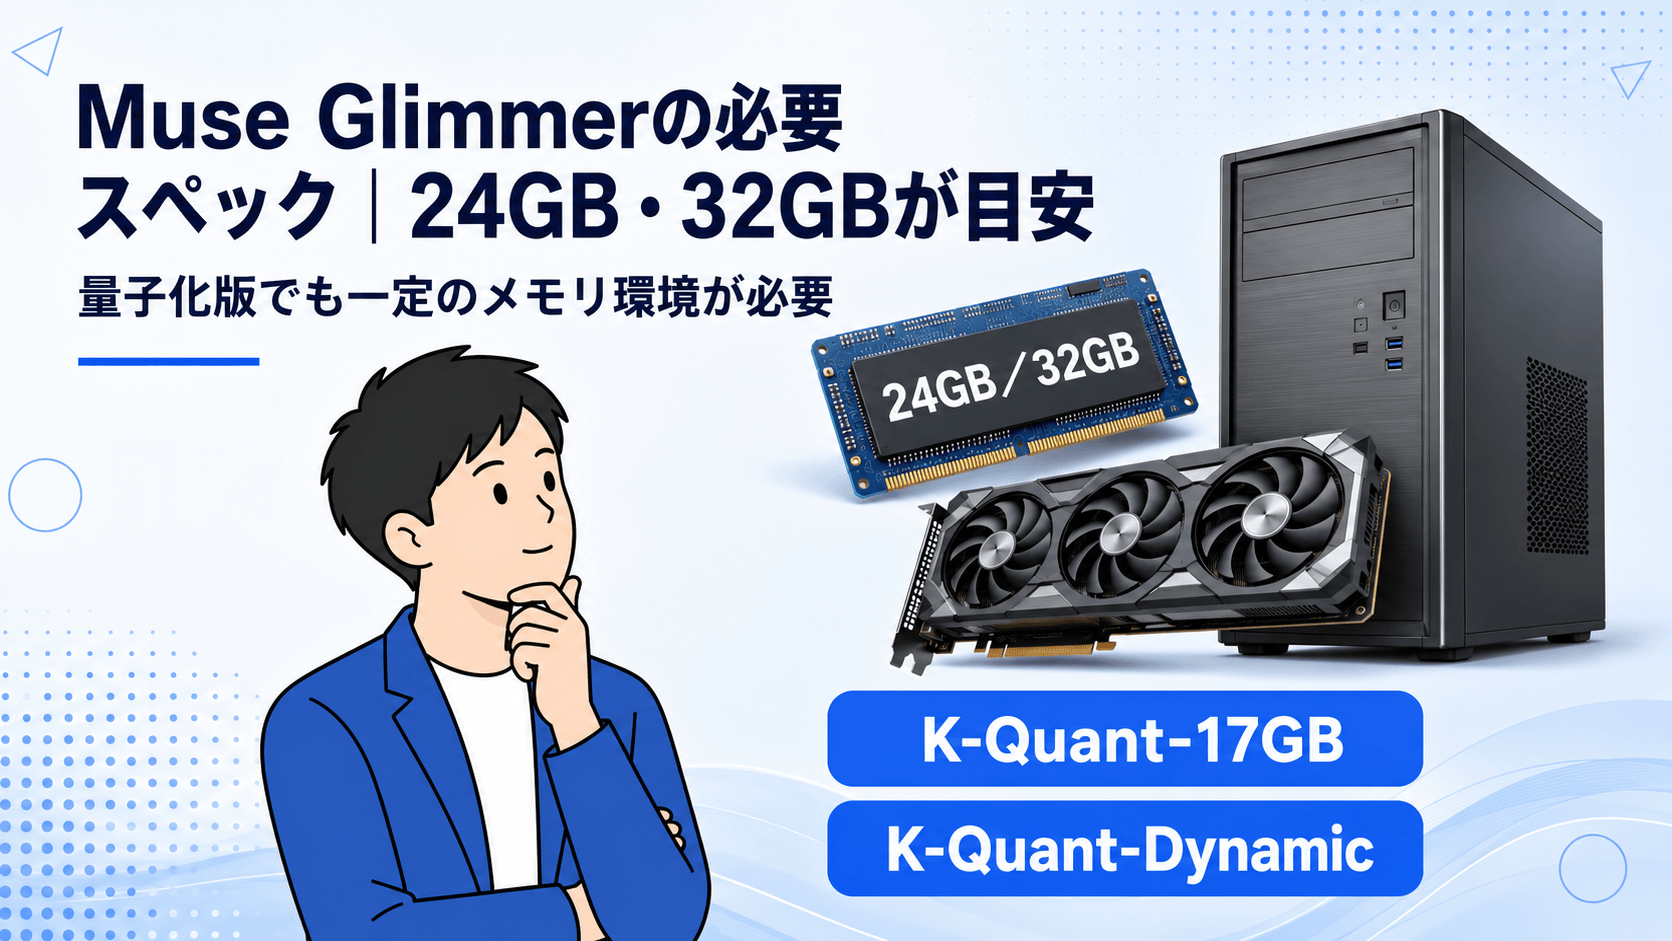
自社のパソコンで動かせるかどうかを判断するうえで、必要スペックは重要な確認ポイントです。
Metaは、Muse Glimmerの4bit量子化版として、24GB環境向けの「K-Quant-17GB」と、32GB環境向けの「K-Quant-Dynamic」を公開しています。フル精度版は64GB VRAMをターゲットとしており、一般的なローカル利用では量子化版が現実的な選択肢です。
前述のとおり、必要メモリはモデルの重みだけで決まるわけではありません。特に長いコンテキストを使う場合はKVキャッシュの容量が増えるため、24GB・32GBはあくまで目安とし、実際の利用条件には余裕を持たせて環境を選定してください。
GUIツールのLM Studioでは、最小構成でも26GB以上のシステムメモリが必要と案内されています。
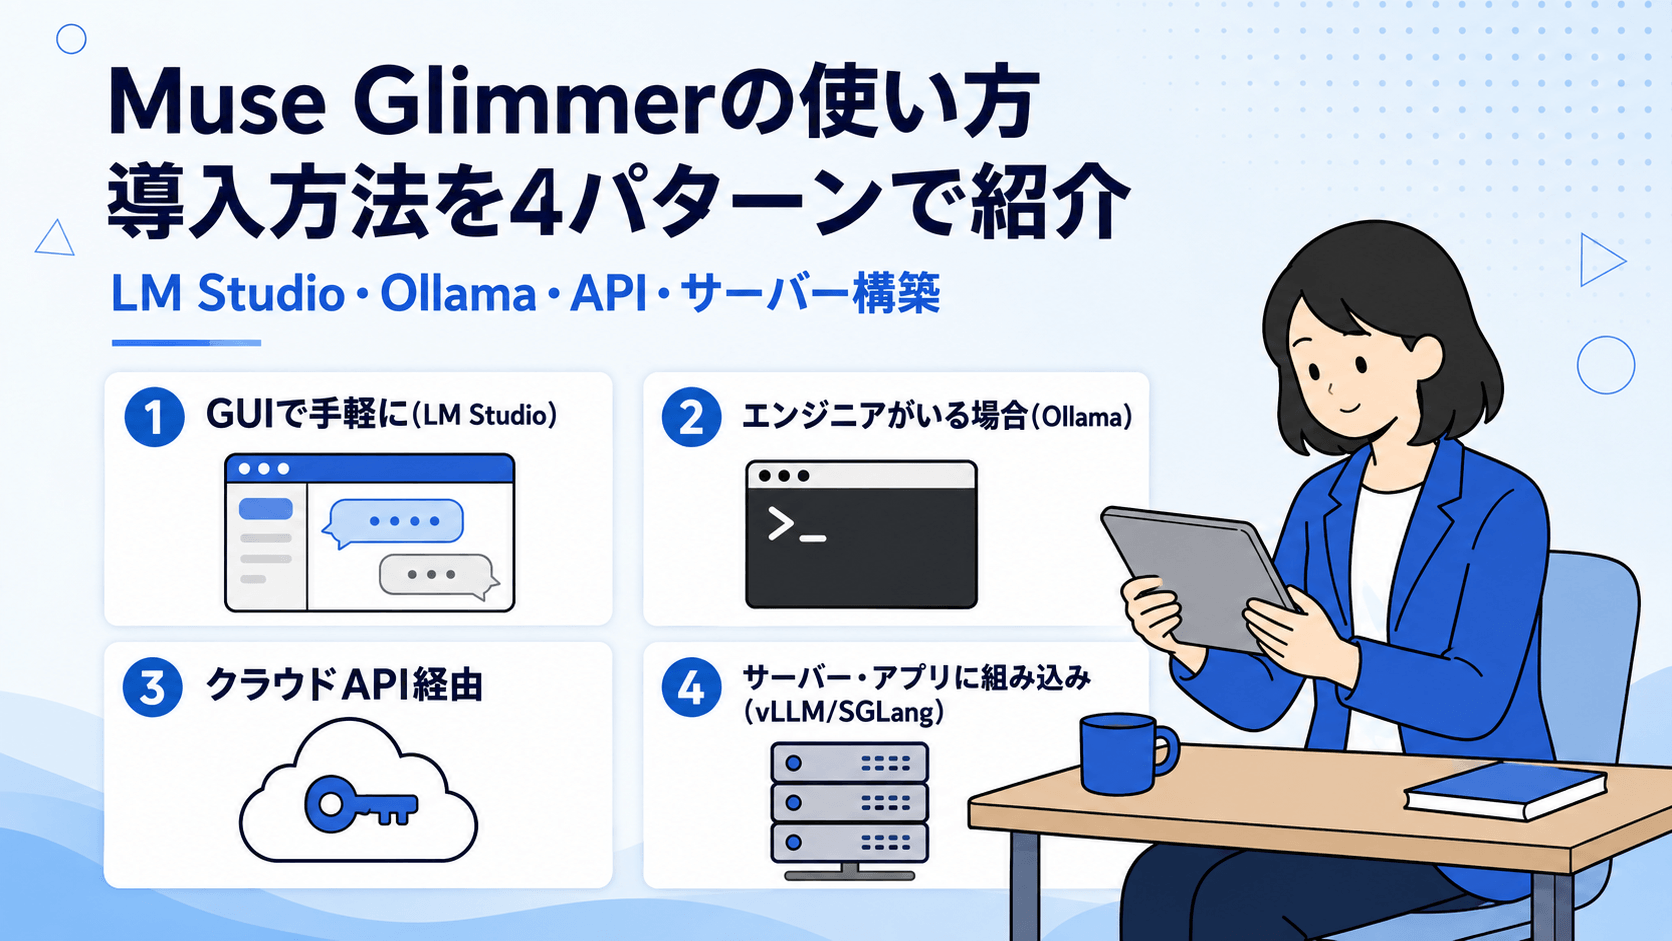
Muse Glimmerの導入経路は、大きく分けて4つあります。社内にエンジニアがいるかどうか、手元にGPUがあるかどうかによって、適した方法が異なります。
コマンド操作に不慣れな方には、GUIベースで動かせる「LM Studio」がおすすめです。公式サイトからアプリをインストールし、アプリ内の検索機能で「Muse Glimmer」を探してダウンロードするだけで、チャット画面からすぐに利用を開始できます。手元のパソコンのメモリ容量に応じて、複数の軽量版(量子化バージョン)から選べます。
前述のとおりLM Studioの利用には最小構成でも26GB以上のシステムメモリが必要です。一般的な事務用PCではメモリ不足になる可能性があるため、ダウンロード前に手元のパソコンのメモリ容量を確認してください。
ローカル環境での本格運用を検討する場合は、「Ollama」というツールを使う方法が一般的です。OllamaではMuse Glimmerをローカル実行できます。Apple Siliconでは専用のMLX版が用意されているほか、Ollama自体は対応するNVIDIA GPUやAMD GPUもサポートしています。
利用できるGPUや必要なドライバは環境によって異なるため、導入前に公式のHardware supportページを確認してください。次のようなコマンドで、モデルのダウンロードから起動まで完了します。
Shell
ollama run muse-glimmerClaude CodeやPiといったコーディングエージェントのバックエンドとして、Muse Glimmerを組み込んで動かす使い方も公式に案内されています。
出典:Muse Glimmer from Meta Superintelligence Labs is now available|Ollama Blog
自社にGPUを用意する予定がない場合は、OpenRouterなどのクラウドAPI経由でMuse Glimmerを試す方法もあります。アカウントを作成してAPIキーを取得すれば、OpenAI互換のインターフェースからそのまま呼び出せるため、ローカル環境を構築せずに性能を確認したい場合の入り口として活用できます。
社内の複数メンバーやシステムから共有で使えるサーバーとして構築したい場合は、vLLMやSGLangといった推論サーバーソフトウェアで動かす方法もあります。いずれもOpenAI互換のAPIを立てられるため、既存の社内システムと連携させやすいのが特徴です。本格的な運用インフラの構築は専門知識を要するため、社内エンジニアやベンダーへの相談を前提に検討するとよいでしょう。
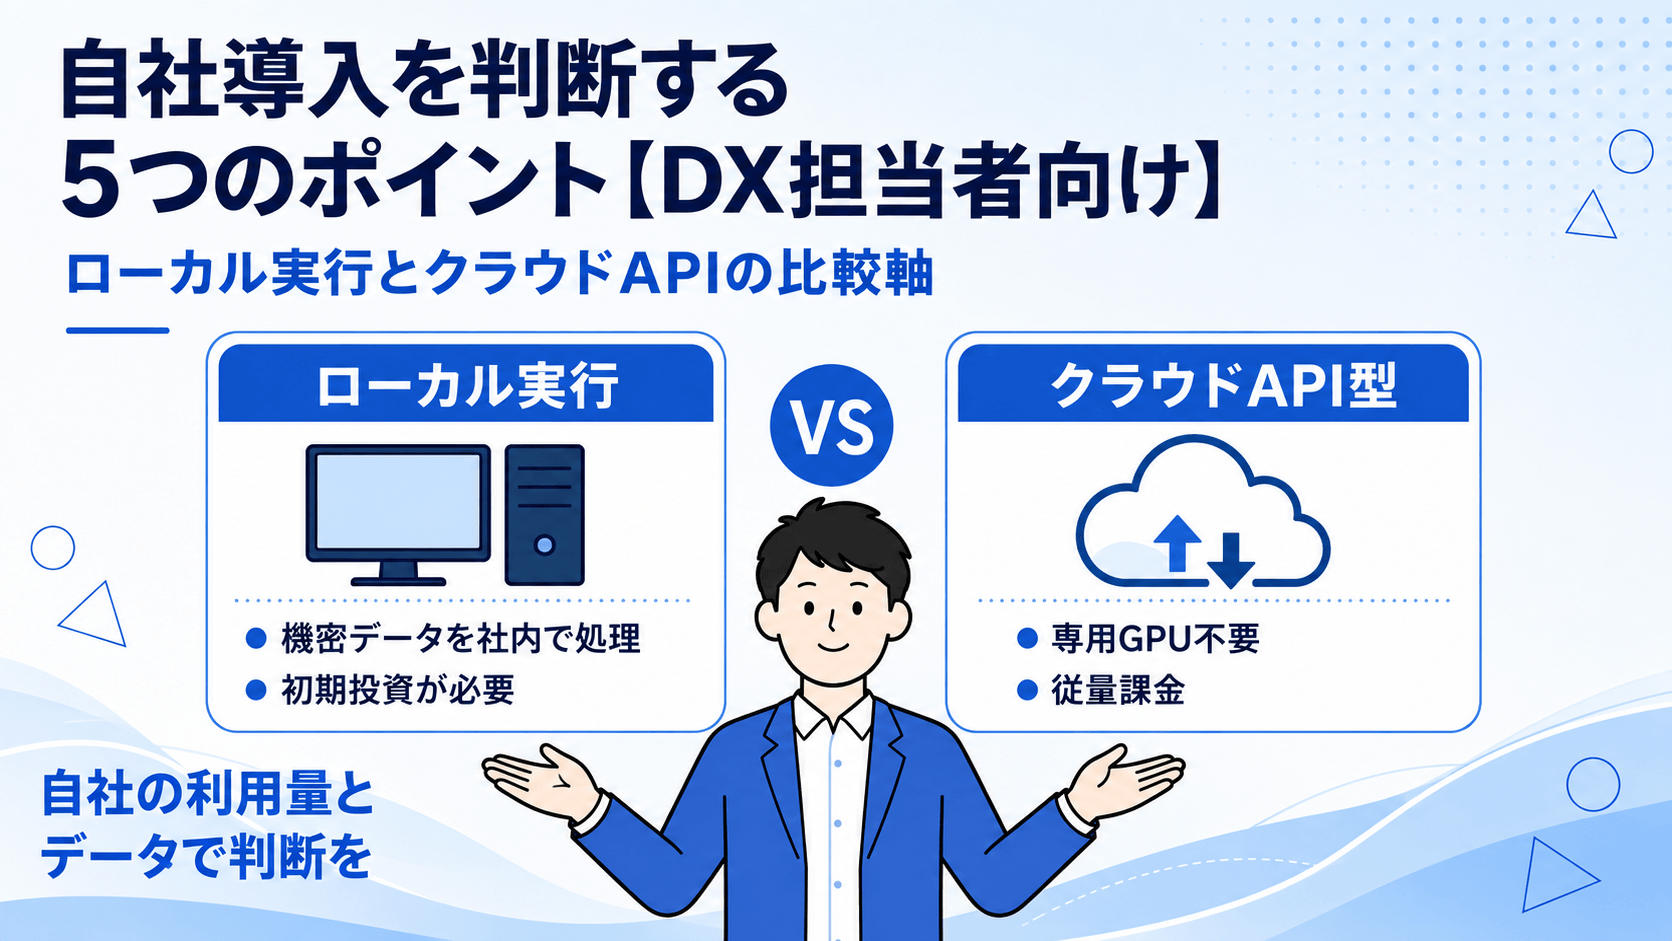
ここまでの技術的な特徴を踏まえて、実際に自社で導入すべきかどうかを判断するポイントを整理します。エンジニアではないDX担当者の方でも、以下の5つのチェック項目に沿って考えれば、導入の方向性を見極めやすくなります。
Muse Glimmerのようなローカル実行型のモデルと、ChatGPTやClaudeのようなクラウドAPI型のAIサービスとでは、判断すべき軸が異なります。大まかな傾向を整理すると、以下のようになります。
| 比較軸 | ローカル実行(Muse Glimmer等) | クラウドAPI型サービス |
| データ処理 | 完全ローカル構成なら自社環境内で処理可能(外部ツールと連携させる場合はその範囲で送信が発生し得る) | 提供事業者のインフラを経由。保存・学習利用等の条件は契約により異なる |
| 初期費用 | GPU搭載機器などのハードウェア投資が必要 | 原則として専用GPUの購入は不要 |
| ランニングコスト | 電力・保守・運用人件費など | トークン従量課金・月額料金など |
| 専門知識の要否 | 構築・更新・監視・セキュリティ管理が必要 | 基盤運用をサービス事業者に任せやすい |
※2026年8月時点の一般的な傾向に基づく比較です。個別サービスの最新の料金・仕様は各社公式サイトをご確認ください。
このように整理すると、「機密データを自社環境内で処理したい」「AIの利用量が多くAPI従量課金を抑えたい」といった企業では、ローカル実行のメリットが大きくなる可能性があります。
一方、「まずは手軽に試したい」「運用にかけられる人的リソースが少ない」企業には、クラウドAPI型のほうが向いているケースが多いといえます。
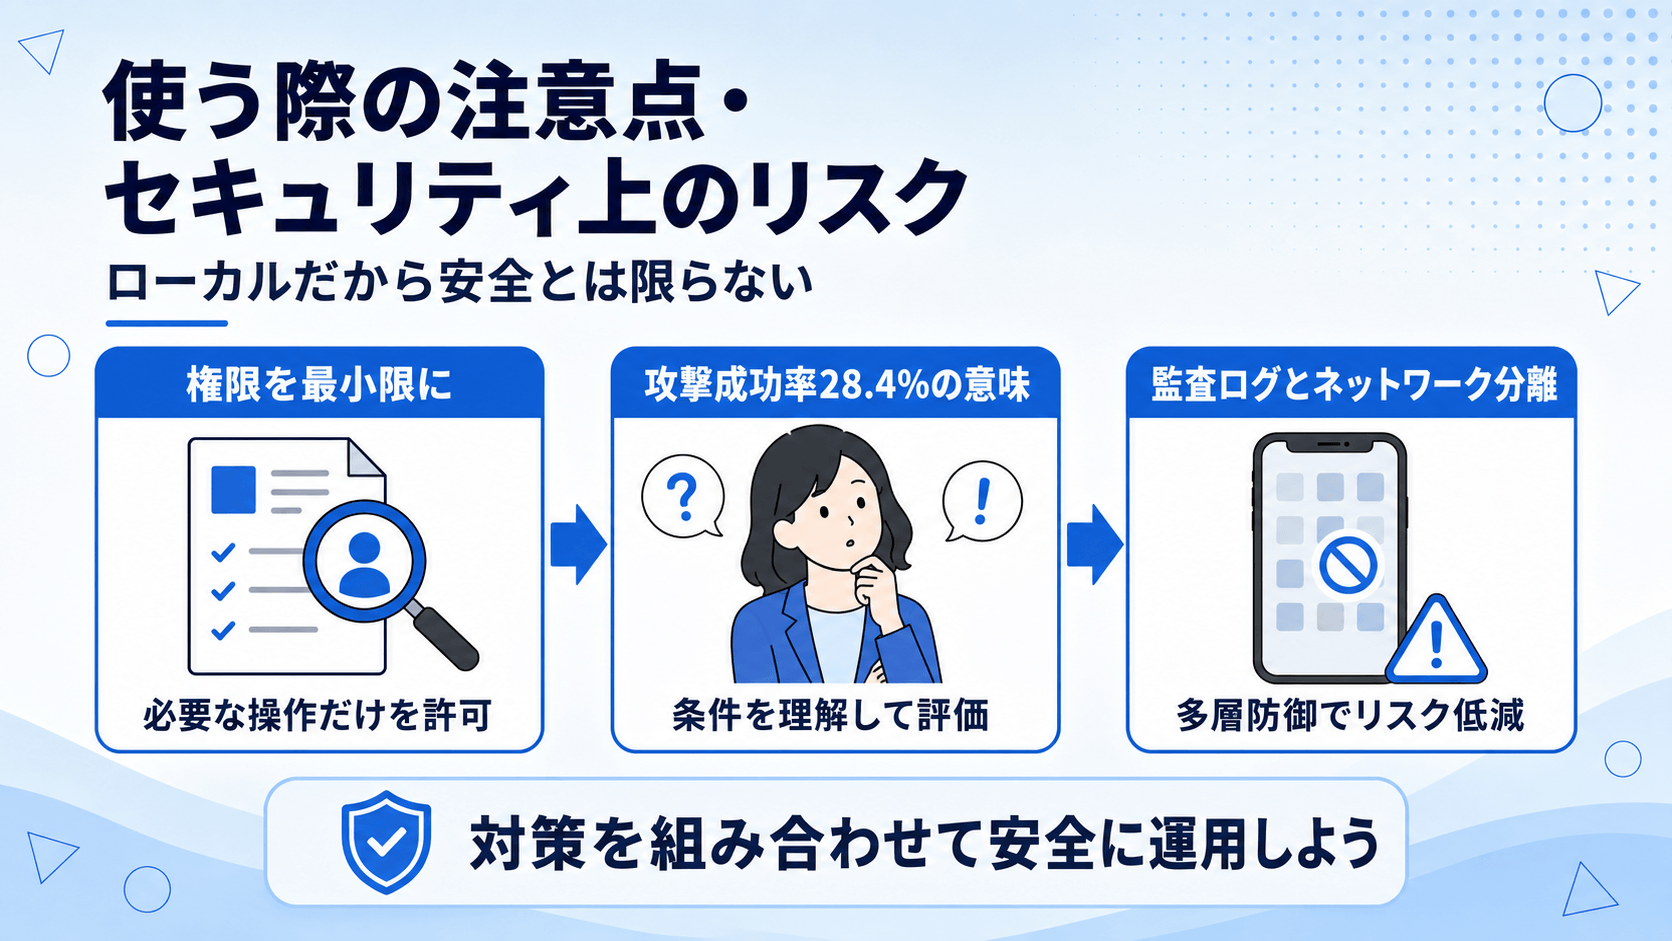
「ローカルで動くから安全」と考えがちですが、それは必ずしも正しくありません。
ローカルで動くAIエージェントは、ファイルシステムや認証情報に直接アクセスできる分、クラウド型のサービスにあるようなログ管理・利用制限・集中的な監視の仕組みが標準では備わっていない場合があります。
Metaのモデルカードでは、プロンプトインジェクション耐性を含む「Siren AgentDojo」という評価において、Muse GlimmerのAttack Success Rate(攻撃成功率)が28.4と報告されています。
とはいえ、これは特定のベンチマーク条件下で測定された値であり、実際の業務で28.4%の確率で攻撃が成功するという意味ではありません。外部コンテンツを読み取ってツールを操作するエージェントでは、モデル単体の安全性に依存せず、権限制御や人による確認などを組み合わせる必要があります。
Metaは、実際の用途に合わせた安全評価と追加のガードレールを実装し、取り消せない操作にはHuman-in-the-loop(人による確認)を設けることを推奨しています。企業で構築する場合は、これに加えて以下のような一般的なセキュリティ対策もあわせて検討するとよいでしょう。
Muse Glimmerのモデル成果物はApache 2.0で公開されており、モデル自体の利用にライセンス料はかかりません。商用利用・改変・再配布も可能です。ただし、Apache 2.0の条件に加えて、Metaが公開しているMuse Glimmer Usage Policyの禁止用途を確認する必要があります。
おおむね合っています。Muse Glimmerの総パラメータ数は約29.6Bです。日本語で表記する場合は約296億、丸めると約300億パラメータに相当します。
GUIベースのLM Studioを使えば、コマンド操作の知識がなくても試すこと自体は可能です。とはいえ、業務での本格運用や社内ネットワークでのセキュリティ設定まで含めると、一定のIT知識を持つ人材、またはベンダーへの委託が現実的です。
Muse Sparkは、Metaの上位モデル系統です。最新版のMuse Spark 1.2は、Muse CodeやMeta Model APIを通じて提供されています。一方のMuse Glimmerは、Muse Sparkの出力を利用した蒸留によって学習された約29.6Bのモデルで、Apache 2.0で重みが公開されています。Metaは、Muse GlimmerをMuse Sparkより概して能力が低いモデルと位置づけていますが、自社環境で運用できる点が大きな違いです。
Muse Glimmerは100以上の言語を含むデータで学習されています。ただし、Metaは学習データに含まれるすべての言語について性能評価を実施したわけではないと説明しており、日本語に特化した公式ベンチマークも確認できません。日本語で業務利用する場合は、実際の社内文書や問い合わせ例を使ってPoC(概念実証)を行い、精度を確認することをおすすめします。
Muse Glimmerは、Apache 2.0で公開された約29.6Bのオープンウェイトモデルで、ローカルのAIエージェント用途に最適化されています。機密性の高いデータを自社環境内で処理したい企業や、継続的なAPI従量課金を抑えたい企業にとって、有力な選択肢になり得ます。
一方で、量子化版でも24GB・32GBクラスのメモリ環境が想定されており、構築・運用・セキュリティ管理も自社側で必要になる点は押さえておきましょう。
自社での導入を判断する際は、以下の5つの観点で整理することをおすすめします。
ベンチマークだけで判断せず、自社の実タスクを使ったPoCで精度・速度・総コストを比較したうえで、本番投入の可否を決めることが大切です。
アイスマイリーでは、生成AI のサービス比較と企業一覧を無料配布しています。課題や目的に応じたサービスを比較検討できますので、ぜひこの機会にお問い合わせください。
業務の課題解決に繋がる最新DX・情報をお届けいたします。
メールマガジンの配信をご希望の方は、下記フォームよりご登録ください。登録無料です。


FOLLOW US
SNSをフォローして、最新情報をチェックできます!


AI製品・ソリューションの掲載を
希望される企業様はこちら