


生成AI
最終更新日:2026/11/16
Claude Sonnet 5.5は、2026年9月28日に発表されたSonnetシリーズの最新モデルです。旧モデルのSonnet 5より出力が30%以上高速になり、1タスクあたりの費用も最大30%抑えられます。ただし、キャッシュ単価などは旧モデルから改定されているため、最新料金の確認が必要です。本記事では、性能・料金・他モデルとの違い・使い方を解説します。
\ AIエージェントの活用事例を、無料でチェック /
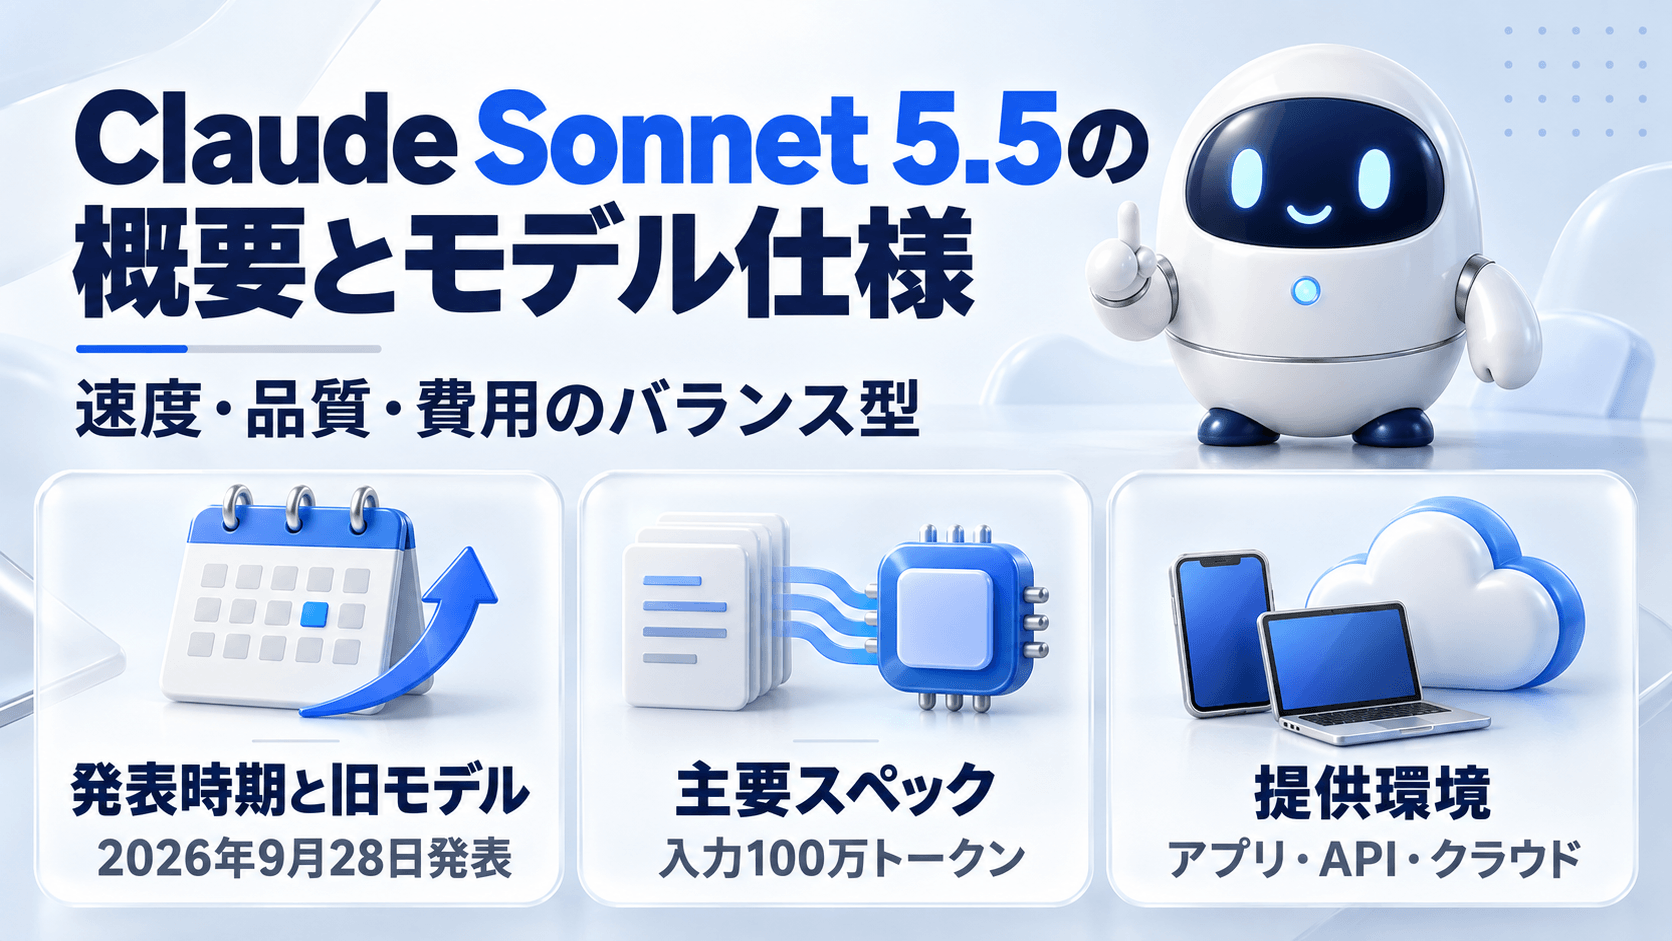
Claude Sonnet 5.5は、応答速度・品質・実行費用のバランスを重視したSonnetシリーズの最新モデルです。Anthropicは同モデルを、速度と知能の両立に最も優れたモデルと位置づけています。
以下では、2026年9月28日の発表内容と、2026年10月時点の提供条件を分けて解説します。
Claude Sonnet 5.5は、2026年9月28日に発表されたClaude 5.5ファミリーの第2弾です。先行したOpus 5.5に続いて登場し、10月7日には軽量版のHaiku 5.5も加わりました。位置づけはClaude Sonnet 5の改良版で、入出力の基本単価はSonnet 5と同額に据え置かれています。
なお、ネット上では「Claude 2 Sonnet」や「Claude 2.5 Sonnet」といった呼称を見かけることがあります。いずれも、公式には存在しないモデル名のため、社内資料などでは、正式名称の「Claude Sonnet 5.5」を使いましょう。APIで指定するモデルIDも「claude-sonnet-5-5」です。
出典:Anthropic|Introducing Claude Sonnet 5.5
Claude Sonnet 5.5は、最大100万トークンの情報を読みこみ、通常12.8万トークンまで出力できます。たとえば、数百ページ規模の仕様書やソースコード一式を1回の依頼で渡し、まとめて分析させる使い方が可能です。入力はテキストと画像、出力はテキストに対応しています。
知識の基準日は2026年6月のため、7月以降のできごとは検索ツールなどで補う必要があります。推論の仕組みには、問題の難度に応じて思考量を変えるAdaptive thinkingが採用され、Claude APIでの既定effortはhighです。ツール利用やPDF読み取り、Batch APIなどの機能にも対応しています。
| 項目 | Claude Sonnet 5.5 |
| 提供開始 | 2026年9月28日 |
| Claude APIモデルID | claude-sonnet-5-5 |
| コンテキスト | 100万トークン |
| 最大出力(通常) | 12.8万トークン |
| 最大出力(Batch API・ベータ) | 30万トークン |
| 知識の基準日 | 2026年6月 |
| 入力/出力 | テキスト・画像/テキスト |
| 推論(Claude API) | Adaptive thinking、既定effort=high |
出典:Anthropic|Claude Sonnet 5.5/Anthropic|What’s new in Claude Sonnet 5.5
Claude Sonnet 5.5は、ClaudeのWeb・デスクトップ・モバイルアプリと、開発者向けのAPIの両方で利用できます。API経由では、Claude APIのほか、Amazon Bedrock、Claude Platform on AWS、Google Cloud、Microsoft Foundryで提供されています。
Google Cloudでは、2026年10月22日に「Claude Models on Google Cloud(Anthropic managed)」の一般提供が始まりました。現在は、従来のGoogle管理版と、Anthropicが運営するAnthropic管理版の2つの方式から選べます。
ただし、使用条件や課金の管理主体は提供経路ごとに異なります。Amazon BedrockやGoogle Cloudでは、クラウド事業者から請求が届きます。Google Cloudでは、Google管理版とAnthropic管理版のどちらもGoogle Cloud経由の請求です。
出典:Anthropic|The full Claude Platform, available on Google Cloud/Google Cloud|Expanding Claude availability and deployment choice on Google Cloud
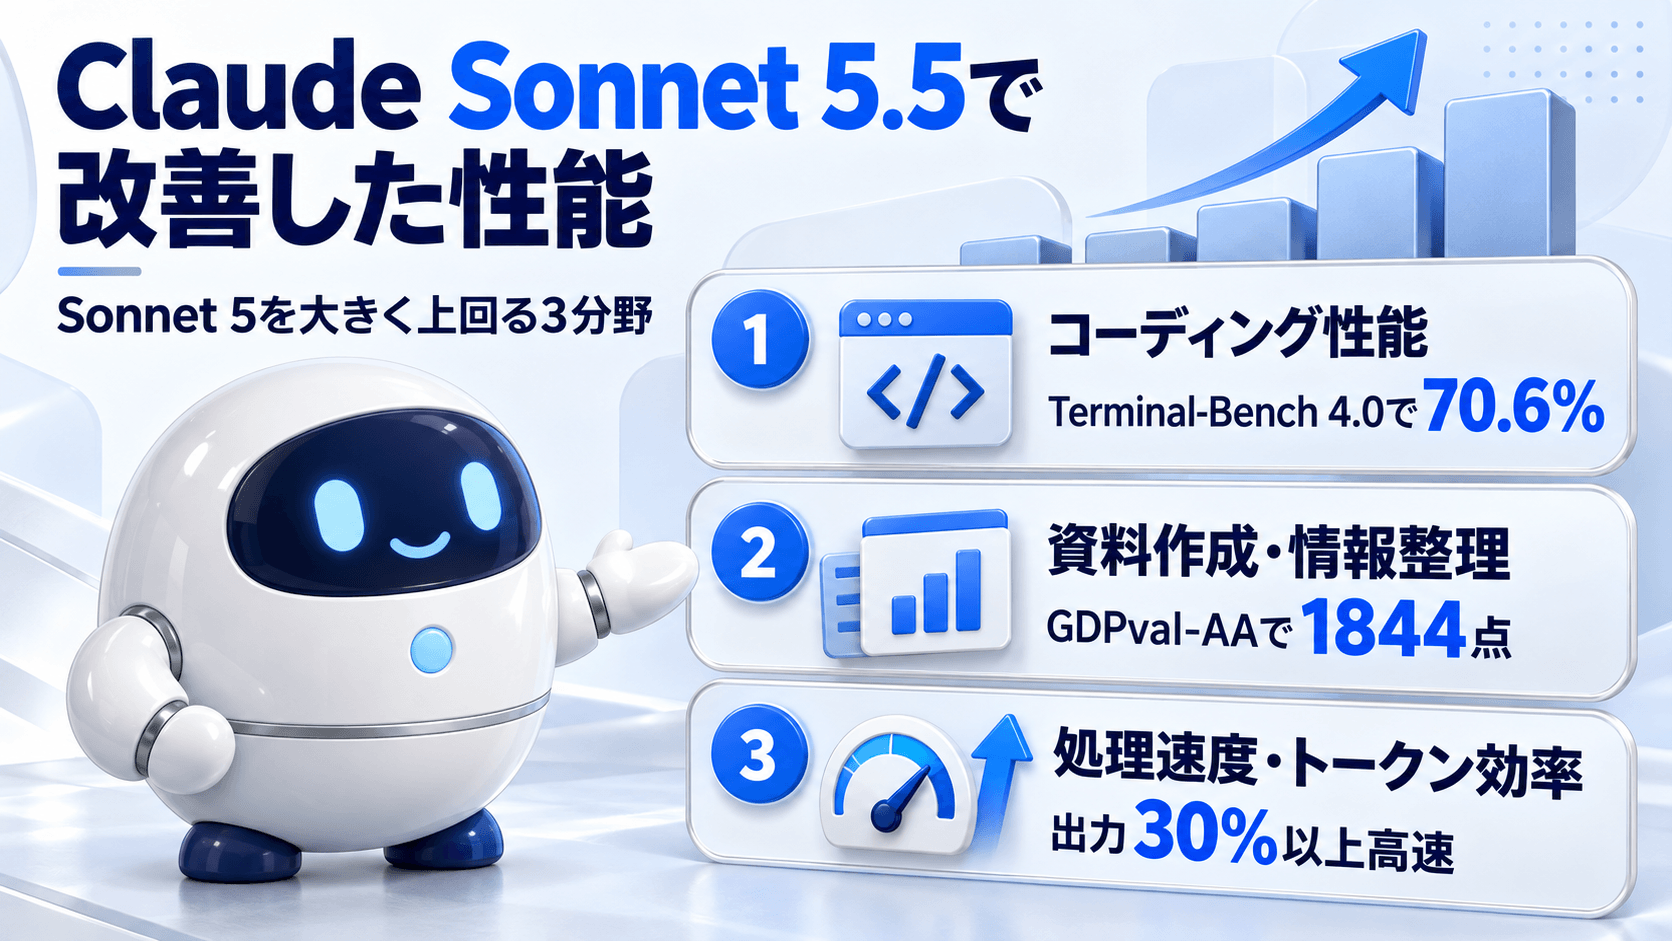
Sonnet 5.5は、コーディング・資料作成・処理速度の3分野でSonnet 5を大幅に上回ります。ただし、ベンチマークは決められた試験条件での測定結果であり、すべての業務の精度を保証するものではありません。
以下では、ベンチマークの結果と処理速度の改善を分けて説明します。
出典:Anthropic|Introducing Claude Sonnet 5.5
公式発表によると、エージェント型のコーディング評価「Terminal-Bench 4.0」で、Sonnet 5.5は70.6%を記録しました。Sonnet 5の10.3%から大幅に伸び、xhigh設定のOpus 5.5(66.4%)も上回っています。Terminal-Bench 4.0は、コマンドライン上で複数の手順を踏む開発作業をやりとげられるかを測る評価です。
実際のCursorの作業から作られたCursorBench 4.0でも55.5%を記録し、Opus 5.5との差は約2ポイントでした。とはいえ、既存コードの調査やバグ修正をまかせる場合も、テストの実行と人によるレビューは欠かせません。
資料作成や情報整理の分野でも、Sonnet 5.5はOpus 5.5に迫る評価を得ています。44職種・9業界の実務タスクを測る「GDPval-AA」では1844点となり、Sonnet 5の1449点を約400点上回りました。
長時間の知識労働を測る「AA-Briefcase」でも、1359点から1811点へ伸びています。
Anthropicの社内テストでは、決算資料、決算説明会の書き起こし、テンプレートをもとに10枚のスライドを作らせ、専門家2名が初稿を送付可能と評価しました。一方で、数値の転記ミスや元資料外の推測がまじる可能性は残ります。社外へ出す前に、出典との突合や体裁の最終確認を人がおこないましょう。
Sonnet 5.5の出力速度はSonnet 5より30%以上高速で、Anthropicの試験では1タスクあたりの費用が最大30%下がりました。入出力の基本単価は旧モデルと同額のため、費用の削減は主に処理に要するトークン数の減少によるものです。
たとえば、1件の回答に出力1万トークンを要した作業が7,000トークンで済めば、出力費用は$0.10から$0.07へ下がります。公式発表によると、一部のベンチマークでは、lowやmediumの設定でもSonnet 5の最高スコアを上回りました。その際の1タスクあたりの費用は、約10分の1です。
同じ単価でも、1件あたりの実費は使い方次第で変わる点を押さえておきましょう。
日常業務にはSonnet 5.5、複雑な判断にはOpus 5.5、大量処理にはHaiku 5.5という使い分けが基本です。モデルを比較する際は、測定環境・推論の度合い(effort)・単価の前提をそろえる必要があります。また、Anthropic内のモデル同士の比較と、ChatGPTなど他社サービスとの比較では、判断の基準も変わります。
出典:Anthropic|Introducing Claude Sonnet 5.5
Sonnet 5.5は速度と性能でSonnet 5を上回り、1件あたりの費用も最大30%下がりますが、API仕様には互換性に影響する変更があります。
入出力の基本単価は同じで、トークナイザーも共通のため、同じ文章のトークン数は変わりません。一方、キャッシュ読み取りの単価はSonnet 5の$0.20に対して$0.10と半額です。
API面では、互換性に影響する変更が5項目あります。思考をオフにする設定、強制ツール利用、思考ブロックの扱い、コンピューター操作ツール、advisorツールの組み合わせです。具体的な対応方法は「APIから呼び出す使い方」で解説します。
Opus 5.5は長時間かつ複雑な判断を伴う仕事に、Sonnet 5.5は範囲の明確な作業と迅速な反復に向いています。公式発表でも、ベンチマーク上はSonnet 5.5がOpus 5.5に迫る一方、持続的な判断を要する作業ではOpus 5.5が明確に上回るとしています。
標準API単価は、Sonnet 5.5が入力$2・出力$10、Opus 5.5が入力$4・出力$20(各100万トークン)です。たとえば、システム全体の設計方針をOpus 5.5で固め、個別の実装をSonnet 5.5へまかせる分担が考えられます。なお、APIの既定effortはOpus 5.5がmedium、Sonnet 5.5がhighと異なります。
Haiku 5.5は、分類・抽出・振り分けといった大量の定型処理に向く軽量モデルです。2026年10月7日に提供が始まり、Claude 5.5ファミリーで最も高速に応答します。一方、Sonnet 5.5は文書作成やバグ修正など、品質を求める日常業務を重視した位置づけです。
Haiku 5.5のAPI単価は、入力が10万トークン以下の場合は入力$0.10・出力$0.50ですが、10万トークンを超えると入力$0.50・出力$2.50に上がります。長文を扱う業務では単価が5倍になるため、固定単価だけで比較せず、実際の入力トークン数で試算しましょう。既定effortもHaiku 5.5はmediumで、Sonnet 5.5とは異なります。
| モデル | 向く業務 | 選定時の確認点 |
| Claude Haiku 5.5 | 分類・抽出など大量の定型処理 | 入力トークン数によりAPI単価が変わる |
| Claude Sonnet 5.5 | 文書作成、バグ修正、日常の開発 | 品質と1件あたりの実費を検証 |
| Claude Opus 5.5 | 複雑な判断・長時間の知識労働 | 必要品質と追加コストを比較 |
ChatGPT系モデルと比較する際は、対象モデル名と検証日を明記し、自社の同じ業務で評価することが大切です。各社のモデル名は番号が似ているため、「Claude Sonnet 5.5」と「GPT-5.5」のように数字がそろっていても、同世代や同等性能を意味するわけではありません。
Anthropicの発表資料にはOpenAIのGPT-6 Solとの比較も掲載されていますが、一部スコアは相手側の不具合修正前の値である可能性も注記されています。企業が公表したベンチマークだけで優劣を断定せず、応答品質・生成物・運用環境・権限管理・料金の5つの観点で比べましょう。たとえば、同じ問い合わせ50件を両方のモデルに回答させ、修正にかかった時間を記録する方法が有効です。
関連記事:ClaudeとChatGPTの比較|料金・機能の違いを解説
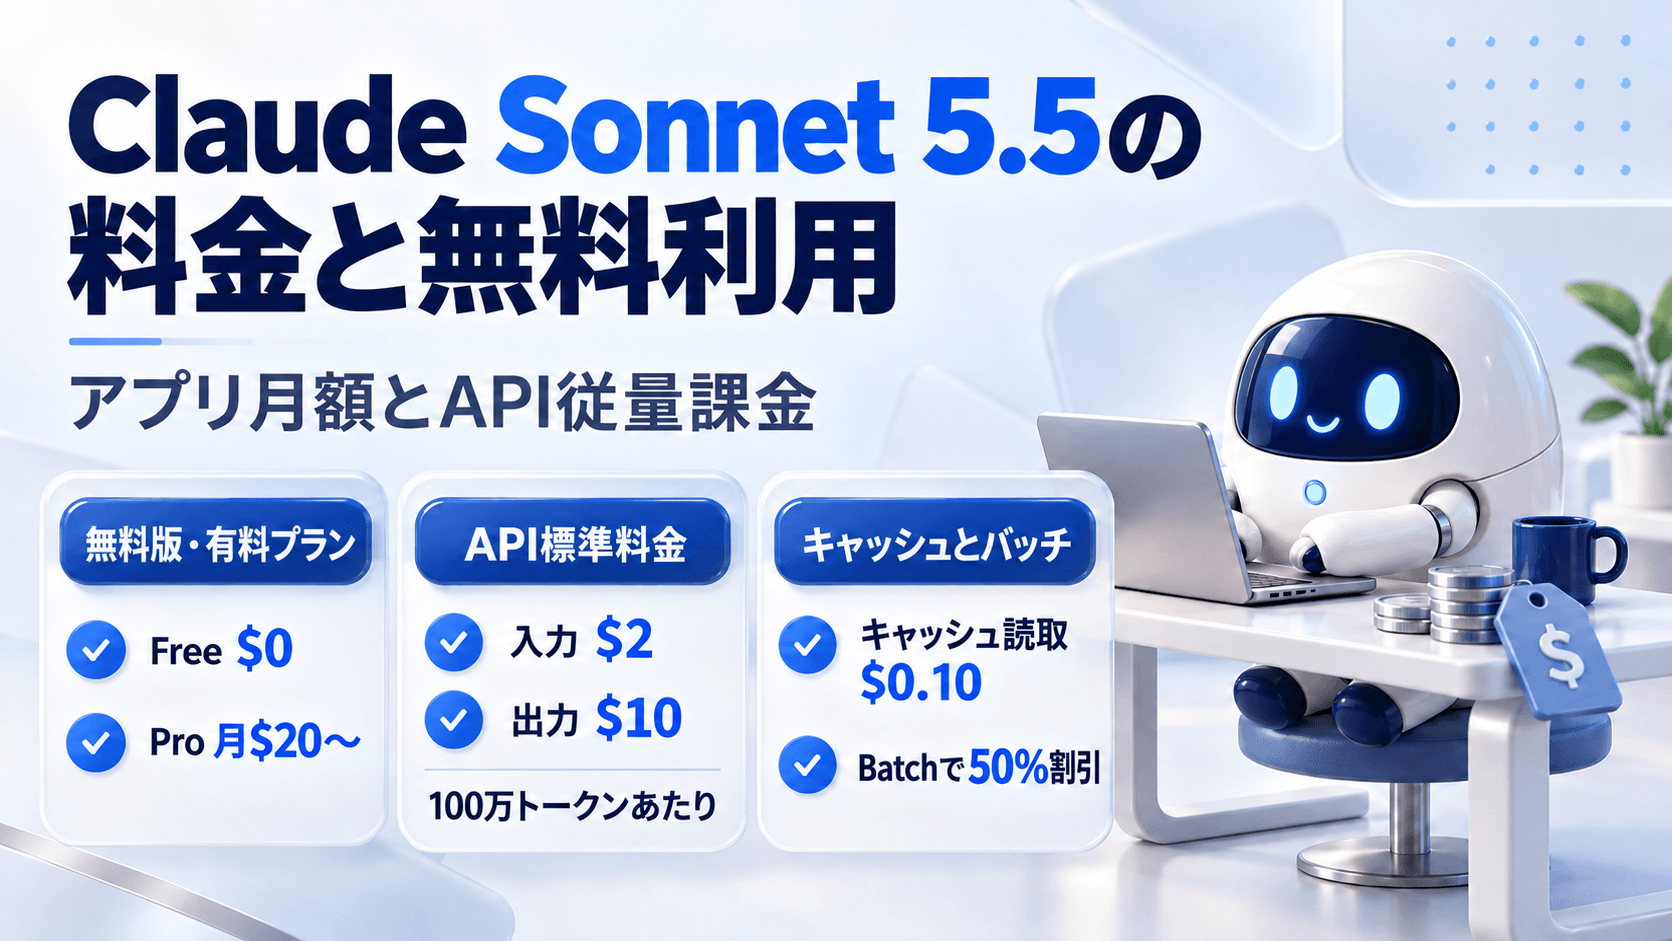
Claude Sonnet 5.5の料金は、アプリで使う月額サブスクリプションと、APIで使うトークン従量課金の2本立てです。両者は別の制度で、有料プランに加入してもAPI利用料は原則として別に発生します(MaxとTeamには一定のAPIクレジットが付属)。本章の料金は2026年10月に確認した米ドル表記(税抜)で、今後変わる可能性があります。
Sonnet系モデルは無料のFreeプランでも選べますが、ClaudeのプランでClaude Codeを使うにはPro以上の有料プランが必要です。
個人向けのProは月払いで$20、年払いなら月換算$17(年額$200)です。Maxは利用量がProの5倍の「Max 5x」が$100、20倍の「Max 20x」が$200です。利用枠は5時間ごとに回復し、有料プランには週ごとの上限もあります。
法人向けのTeamは2~150席が対象で、標準シートは年払い$20・月払い$25、Premiumシートは年払い$100・月払い$125です。Enterpriseは年払いで1席あたり月$20に加え、API単価にもとづく利用量課金が発生します(20席から)。
| Claudeプラン | 月額料金(米ドル・税抜) | Claude Code |
| Free | $0 | 利用不可 |
| Pro | $20(月払い)/年払いは月換算$17 | 利用可能 |
| Max 5x | $100 | 利用可能 |
| Max 20x | $200 | 利用可能 |
| Team(2~150席) | 標準:$20(年払い)/$25(月払い)、Premium:$100(年払い)/$125(月払い)※1席あたりの月額 | 利用可能 |
| Enterprise(20席~) | $20/席・月(年払い)+API単価にもとづく利用量課金 | 利用可能 |
Claude Sonnet 5.5のAPI標準単価は、100万トークンあたり入力$2・出力$10です。上位のOpus 5.5(入力$4・出力$20)の半額にあたり、旧モデルのSonnet 5とは同額です。最軽量のHaiku 5.5は入力$0.10からと割安ですが、入力が10万トークンを超えると単価が5倍になります。
たとえば、入力5万トークン・出力1万トークンの依頼を1,000件処理する場合、Sonnet 5.5では入力$100と出力$100で計$200です。同じ条件をOpus 5.5で処理すると計$400となり、費用は2倍になります。ちなみに、米国内のみで推論する設定を選ぶと、単価は1.1倍になります。
| モデル | 入力/100万トークン | 出力/100万トークン |
| Claude Sonnet 5.5 | $2.00 | $10.00 |
| Claude Opus 5.5 | $4.00 | $20.00 |
| Claude Haiku 5.5 | $0.10(10万以下)/$0.50(10万超) | $0.50(10万以下)/$2.50(10万超) |
出典:Anthropic|Claude Sonnet 5.5/Anthropic|Pricing
関連記事:Claude(クロード)のAPIとは?使い方からかかる料金まで詳しく解説
プロンプトキャッシュとBatch APIを活用すると、標準単価より大幅に費用を抑えられます。キャッシュは、繰り返し送る指示文や資料を一時保存し、2回目以降の読みこみを割安にする仕組みです。保存期間は5分と1時間の2種類があり、期間によって書きこみ単価が変わります。
Sonnet 5.5のキャッシュ読み取り単価は、2026年10月7日に$0.20から$0.10へ値下げされ、現在はSonnet 5($0.20)の半額です。Batch APIは、即時応答が不要な処理を対象に入出力単価を半額にする制度です。両者の割引は併用できます。
Sonnet 5.5のキャッシュ単価は、100万トークンあたり5分書きこみ$2.50、1時間書きこみ$4、読み取り$0.10です。読み取りは通常入力$2の5%にあたるため、同じ定型指示を何度も送るほど費用の差が広がります。
たとえば、5万トークンの社内マニュアルを毎回参照するチャットボットでは、2回目以降の入力費用が1件あたり$0.10から$0.005まで下がります。なお、キャッシュの対象になるのは512トークン以上のプロンプトで、保存期間内に再利用した場合に限られます。
| 項目 | Sonnet 5.5の単価/100万トークン |
| 通常入力 | $2.00 |
| キャッシュ書きこみ(5分) | $2.50 |
| キャッシュ書きこみ(1時間) | $4.00 |
| キャッシュ読み取り | $0.10 |
| 通常出力 | $10.00 |
出典:Anthropic|Claude Sonnet 5.5
Batch APIを使うと、Sonnet 5.5の入出力単価が50%割引となり、100万トークンあたり入力$1・出力$5で処理できます。Batch APIは多数のリクエストをまとめて送り、非同期で結果を受け取る方式です。
結果の返却まで時間がかかる場合があるため、夜間の大量分類や過去文書の一括要約など、即時応答が不要な定型処理に向いています。一方、利用者と対話するチャットや、待ち時間が業務に直結する処理には向きません。
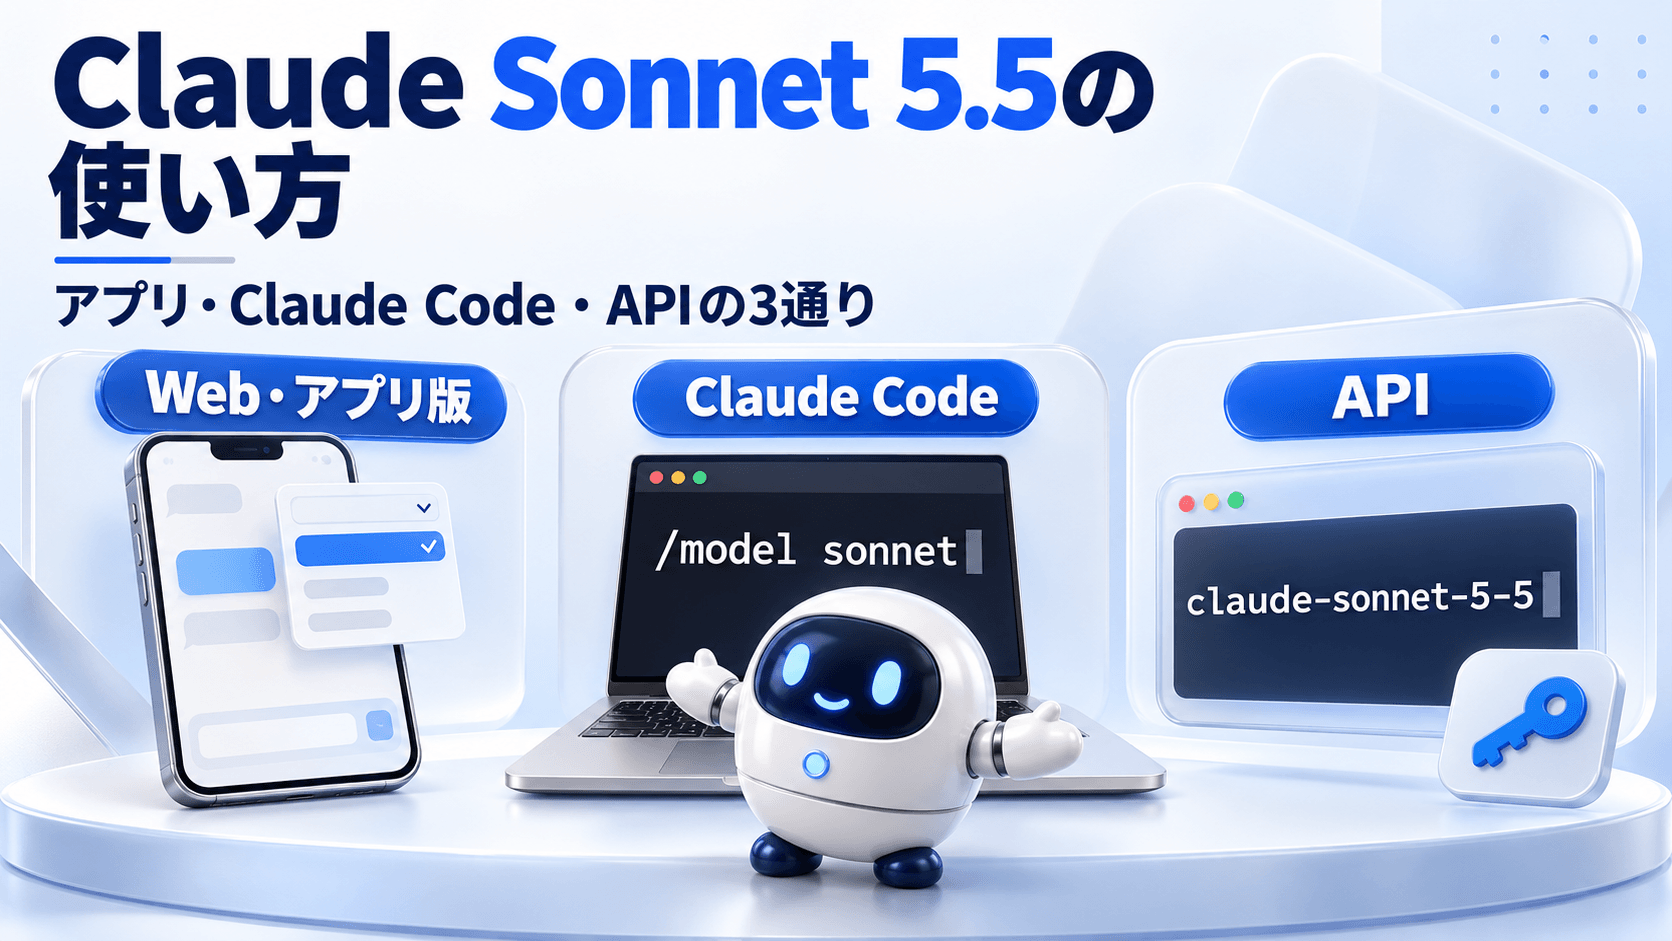
Claude Sonnet 5.5は、アプリでは画面上のモデル選択から、開発環境ではモデルIDの指定で利用します。利用する入口によって手順が異なるため、目的に合う方法を選びましょう。
Web・アプリ版では、Claudeにログインし、モデル一覧から「Sonnet 5.5」を選ぶだけで利用を始められます。依頼の際は、目的・入力資料・出力条件の3点を明記すると、意図に沿った回答を得られます。たとえば「添付の議事録をもとに、部長向けの報告メールを300字で作成」と指定します。
Sonnet系モデルはFreeプランでも選べますが、Proでは利用枠がFreeの5倍以上に広がり、Maxではさらに増えます。モデル一覧でSonnet 5.5を選べず困った際は、ログイン中のアカウントと契約プランを確認しましょう。Enterpriseでは、管理者が組織内で使えるモデルを制限している可能性もあります。
Claude Codeでは、セッション中に「/model sonnet」と入力すると、Claude API経由の環境ではSonnet 5.5へ切りかわります。引数なしで「/model」を実行すれば、一覧からモデルとeffortを選べます。Sonnet 5.5の利用にはClaude Code v2.1.284以降が必要なため、旧バージョンでは「claude update」で更新しましょう。
Amazon BedrockやGoogle Cloud経由では、sonnetの別名が旧モデルを指すため、完全なモデルIDの指定が必要です。利用対象は、Pro以上のプラン契約者と、APIキーやクラウド経由の利用者です。編集後は差分を確認し、テストを実行してから取りこみましょう。
関連記事:Claude Code入門ガイド|インストールから基本操作・活用方法まで解説
API経由では、Claude ConsoleでAPIキーを発行し、Messages APIの「model」に「claude-sonnet-5-5」を指定します。Pythonなどの公式SDKを使えば、モデル名と入力文、最大出力トークン数を渡すだけで応答を受け取れます。Sonnet 5から移行する場合は、モデルIDの書きかえに加えて互換性の確認が必要です。
特に、思考をオフにする「disabled」は400エラーになるため、「between_tools」へ置きかえます。between_toolsはeffortがlow・medium・highのときだけ使えます。xhighやmaxと組み合わせるとエラーになるため、その場合は思考設定を省略してください。強制ツール利用の「any」「tool」も使えず、「auto」と厳格なツール利用(strict)の組み合わせへの変更が必要です。
また、Sonnet 4.6以前のモデルから移行する場合は、temperatureなどのサンプリング設定を送るとエラーになる点にも注意しましょう。
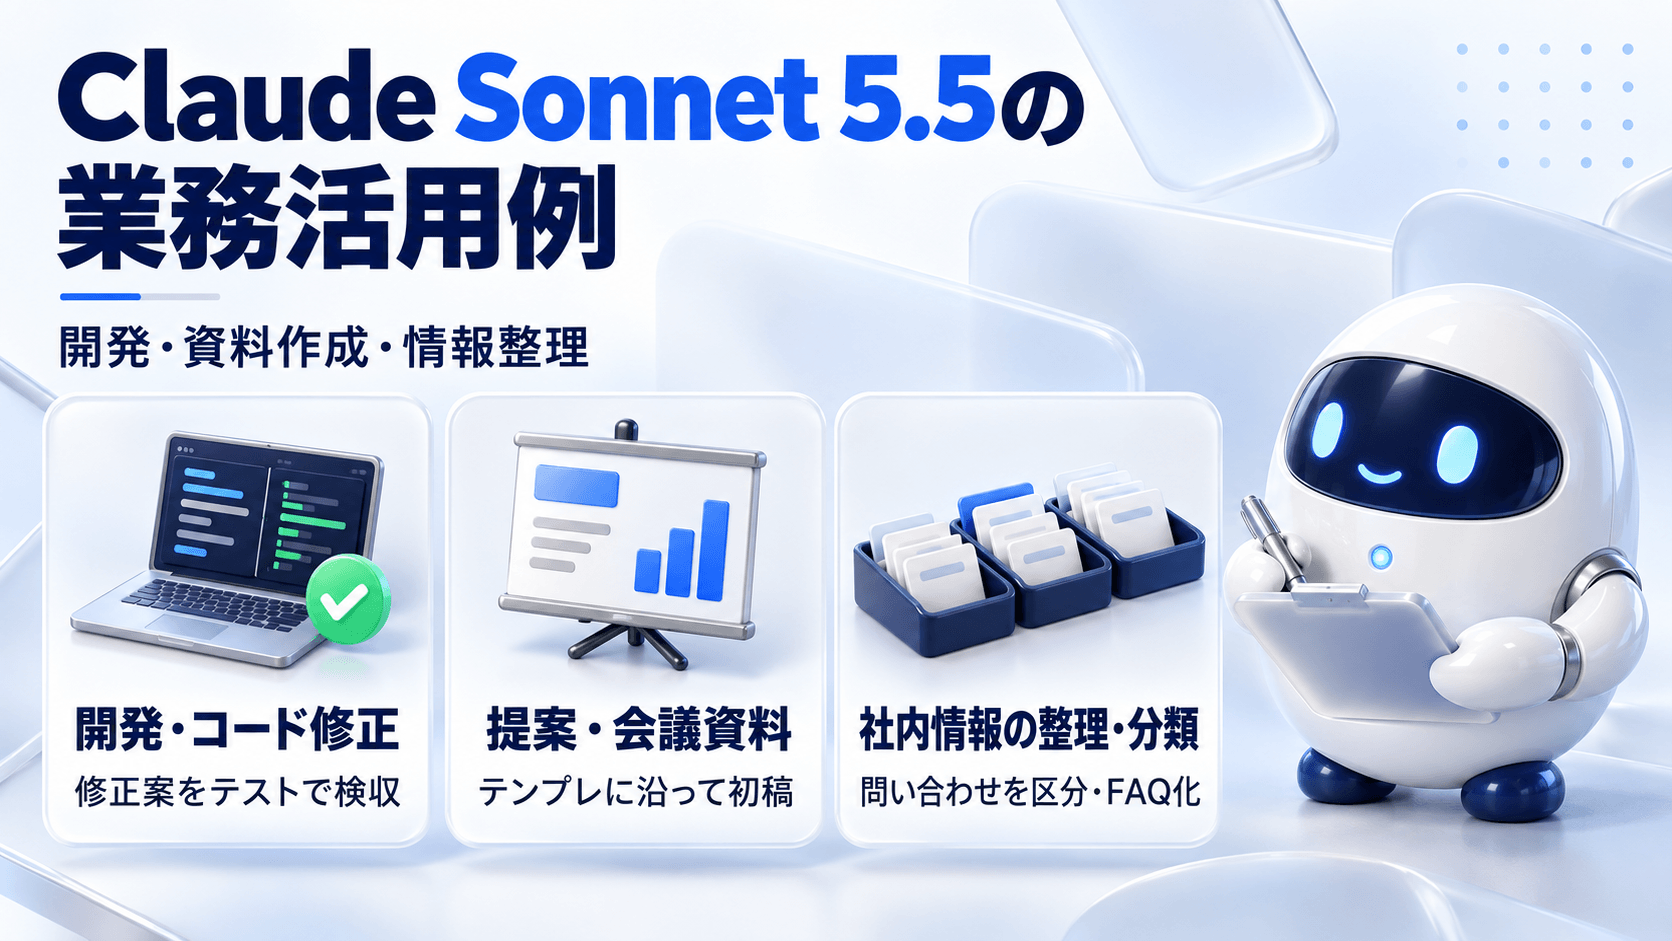
Sonnet 5.5を業務で活かすには、入力資料と成果物を具体的に指定し、成功条件と確認担当者を決めて運用することが重要です。成果物の品質は、入力データの質やアクセス権限、人による確認体制に左右されます。発表時の評価値は品質の保証ではないため、自社業務での検証結果をもとに判断しましょう。
開発業務では、不具合の再現手順、対象リポジトリ、期待するテスト結果をそろえて、Sonnet 5.5に修正案を作らせる使い方が有効です。たとえば「ログイン後に一覧画面が空白になる」不具合なら、エラーログと関連ファイル、再現条件を渡します。AIが出した修正差分は、既存のテストと新たに追加したテストの両方で検収しましょう。
公式発表で紹介されたUnityの評価では、実行時に動作を確認できた作業だけを完了と数えています。Sonnet 5.5の作業の過半数が同基準を満たしたと報告されています。AIの「完了」という報告をうのみにせず、人のレビューやCIで動作を確かめる運用が欠かせません。
資料作成では、社内資料や既存テンプレートを渡し、報告書・スライド・表計算の初稿を作らせる使い方が効果的です。たとえば、社内の調査結果と会社指定のスライド形式を渡し、経営会議向けの報告資料をまとめさせる方法があります。Sonnet 5.5はデザイン面の仕上げも得意とし、テンプレートに沿ったスライドを作れると評価されています。
ただし、元資料外の数値や推測がまじる可能性は残ります。採用前に、数値・固有名詞・出典の3項目を元資料と1つずつ突き合わせましょう。
社内マニュアルや表データをもとに、要約・分類・FAQの下書きを作る業務にも活用できます。たとえば、問い合わせ履歴1,000件を「請求」「契約」「障害」などの区分に分け、頻出の質問からFAQ案を作る使い方です。まずは数十件の少量データでSonnet 5.5の分類精度を確かめ、例外の扱い方をルール化しましょう。
件数が数万件規模に増える場合は、割安なHaiku 5.5も評価候補に入れると費用を抑えられます。Haiku 5.5は分類や抽出を主な用途として設計されたモデルです。品質が基準に届くかを両モデルで比べてから、本番で使用するモデルを決めましょう。
| 業務 | 入力例 | 確認する成果物 |
| システム開発 | バグのログと対象ファイル | 修正差分・テスト結果 |
| 提案書作成 | 社内資料・既存テンプレ | 説明の正確性・体裁・元資料との整合 |
| 情報分類 | FAQ元データ・分類条件 | 分類精度・例外処理・人手修正 |
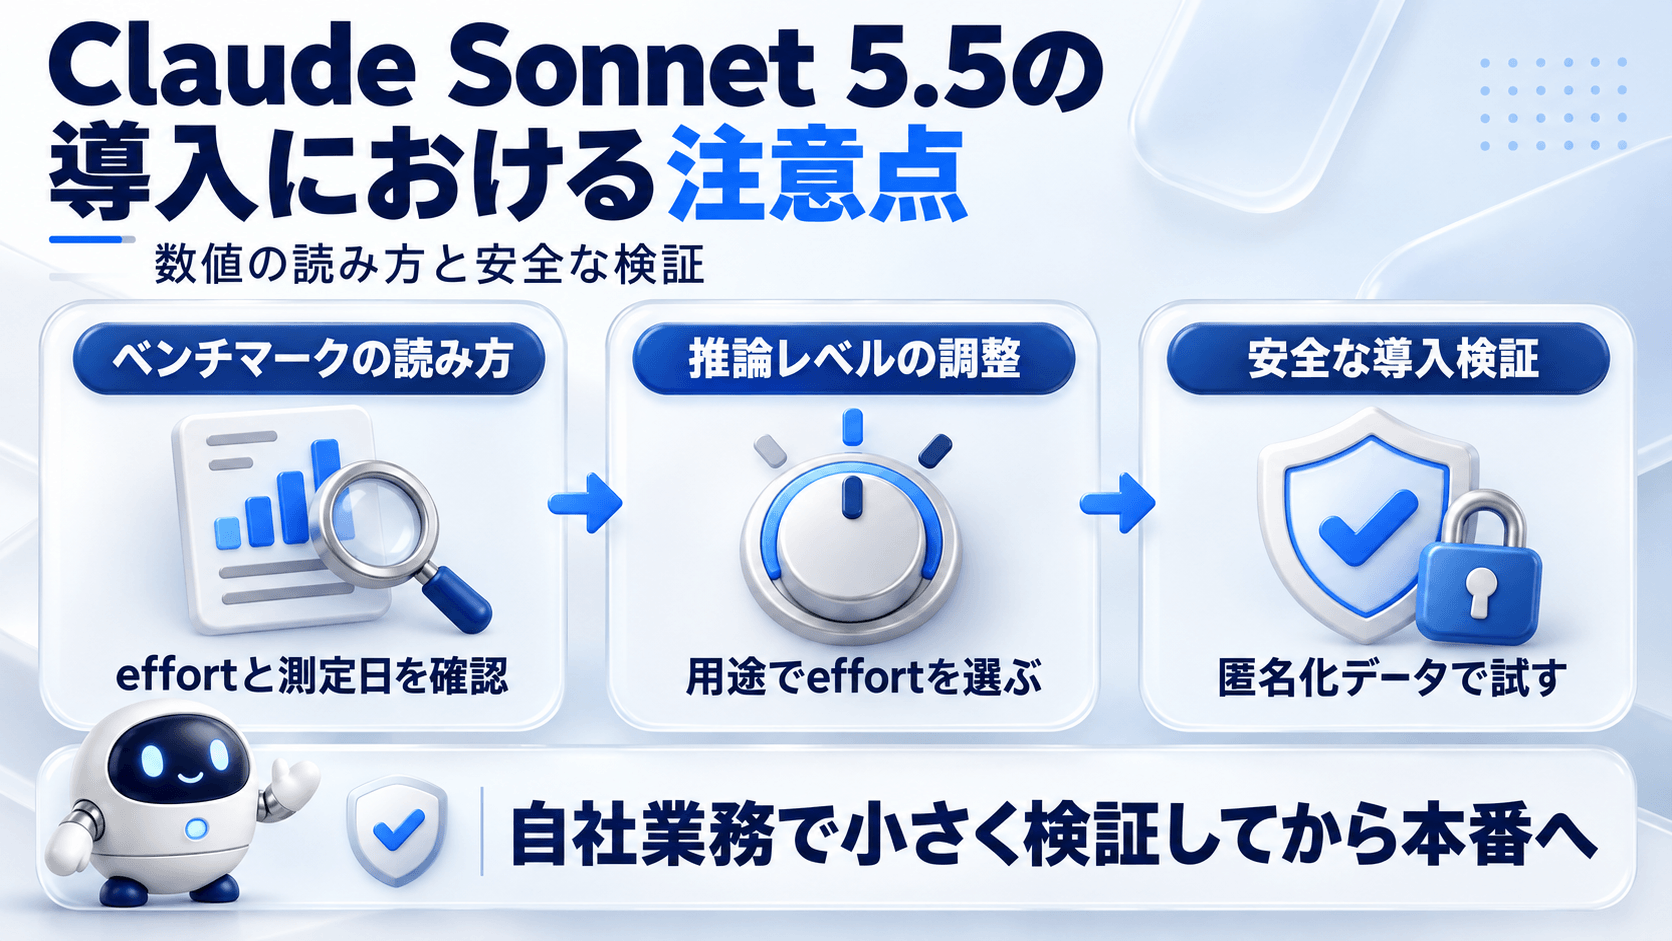
導入前に、公開ベンチマークと自社業務の実測値との差を見極め、機密情報の扱いを確認することが重要です。公開スコアが高水準でも、自社業務の完了率・修正負荷・費用が同じ水準になるとは限りません。機密情報を扱う場合は、契約条件、データの共有範囲、外部ツール連携の設定を事前に確認しましょう。
企業が公表するベンチマークの数値は、評価の設定やeffortの水準によって大幅に変わります。たとえばFrontierCodeでは、Sonnet 5.5のスコアがxhighで52.1%、maxで46.2%となり、上位の設定ほど高得点とは限りません。公式発表では、max設定で作業範囲外の編集やタイムアウトが起き、評価が下がったと説明されています。
また、他社モデルとの比較では、測定時期や不具合修正の有無といった条件の差が注記される場合もあります。数値を引用する際は、モデル名・effort・測定日をあわせて記載しましょう。
effortは、品質・待ち時間・トークン使用量を調整する主要な設定です。Claude APIではSonnet 5.5の既定がhighである一方、ClaudeアプリやClaude Codeではmediumが既定です。公式ドキュメントでは、明確な開発作業や複数ツールの操作はmediumから始め、困難な作業や長時間の作業ではhighへ上げる方法をすすめています。
チャットなど応答速度を重視する用途では、mediumかlowが出発点です。xhighやmaxは、自社の評価で品質向上を確認できた場合に限って使います。Sonnet 5とはeffortの基準が調整し直されているため、旧モデルの設定を引き継がず測り直しましょう。
| 使い方 | effortの出発点 | 調整方針 |
| APIの一般的な複合タスク | high(既定) | 実測で品質が保てれば下げる |
| 明確な開発・複数ツール操作 | medium | 長時間・高難度の作業はhighを検討 |
| 反復的な対話・短文の回答 | medium/low | 応答待ち時間と誤答を比較 |
検証では、実データを模した匿名化データを用意し、正確性・再現性・トークン消費量・人手修正時間を記録します。たとえば、過去の問い合わせ100件に含まれる個人名や連絡先を伏せ字にし、Sonnet 5.5の回答と担当者の回答を比較する方法です。外部ツールの操作や機密資料の取り扱いでは、AIに与える権限を最小限にとどめ、重要な操作の前に人の承認をはさみましょう。
Sonnet 5.5はサイバーセキュリティ面の安全対策が強化されており、高リスクと判断された依頼は拒否(refusal)として返されます。自動でSonnet 5に切りかわるわけではありません。
Claude APIなどでは、ベータ版の「サーバー側フォールバック」を設定すれば、サイバー関連で拒否された依頼をSonnet 5で再試行できます。セキュリティ関連の業務で検証する際は、拒否とフォールバックの発生頻度も記録しておくと安心です。
| 検証項目 | 記録する内容 | 合格判定の例 |
| 正確性 | 業務タスク別の正答率・要修正件数 | 人手検収で基準を満たす |
| 速度 | 実タスク完了までの時間 | 既存の作業方法より短縮 |
| 費用 | 入力・出力・キャッシュの使用量 | 許容する1件あたり原価以内 |
| 運用・安全 | アクセス権、誤操作、機密情報の扱い | 人の確認と監査が可能 |
Claude Sonnet 5.5は、Sonnet 5と同じ基本単価のまま、コーディング・資料作成・処理速度の各分野で大幅な性能向上を果たしたモデルです。API単価はOpus 5.5の半額で、キャッシュ読み取りはSonnet 5の半額に設定されています。
一方で、思考設定やツール指定などAPI仕様の変更点があり、移行時の点検は欠かせません。ベンチマークの数値はあくまで参考とし、匿名化データを使った小規模な検証で、品質・費用・運用の安全性を確かめましょう。
日常業務の主力にSonnet 5.5を置き、複雑な判断はOpus 5.5、大量処理はHaiku 5.5と使い分けることで、用途に応じた品質とコストのバランスを図れます。
アイスマイリーでは、生成AI のサービス比較と企業一覧を無料配布しています。課題や目的に応じたサービスを比較検討できますので、ぜひこの機会にお問い合わせください。
\ AIエージェントの活用事例を、無料でチェック /
業務の課題解決に繋がる最新DX・情報をお届けいたします。
メールマガジンの配信をご希望の方は、下記フォームよりご登録ください。登録無料です。


FOLLOW US
SNSをフォローして、最新情報をチェックできます!


AI製品・ソリューションの掲載を
希望される企業様はこちら