


生成AI
最終更新日:2026/10/20
社内文書を活用したRAG構築において、回答精度が頭打ちになりプロジェクトが停滞するケースは少なくありません。その打開策として現在注目を集めているのが「Agentic RAG」です。
とはいえ、「最新技術だからと全面リニューアルすべきか」「既存RAGのチューニングで十分なのでは」と、自社に合った適切な投資判断に迷う方も多いのではないでしょうか。
本記事では従来のRAGとの仕組みの違いやAgentic RAGが真価を発揮する質問の条件、具体的な構築手段を網羅的に解説します。自社のAI開発における「次の一手」を迷わず判断するためのガイドとしてご活用ください。
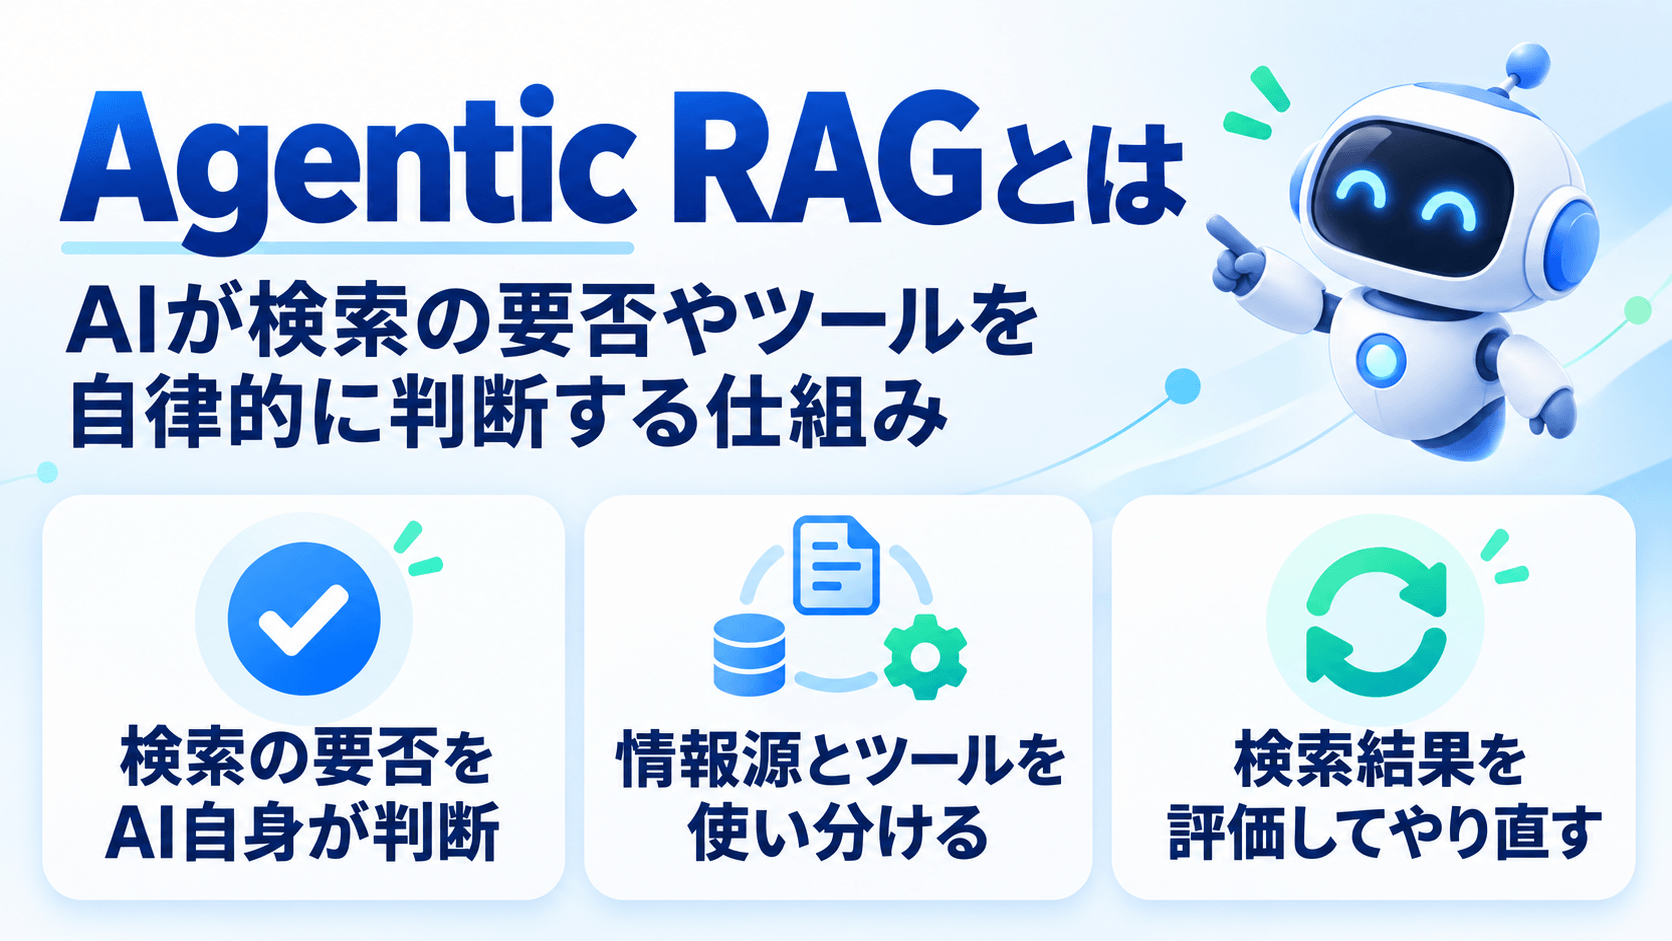 Agentic RAGは、AIエージェントをRAGの処理に組み込み、検索の要否や回数、使う情報源をAI自身が判断しながら回答を組み立てる仕組みです。2025年1月に初版が公開されたサーベイ論文「Agentic Retrieval-Augmented Generation: A Survey on Agentic RAG」ではAgentic RAGの考え方が体系的に整理されました。
この論文では、AIエージェントをRAGのパイプラインに組み込み、自己評価(reflection)・計画・ツール利用・複数エージェントの協調といった設計パターンを活用する構成が示されています。
RAGそのものの仕組みについてはRAG(検索拡張生成)とは?でも解説しているため、ここでは従来のRAGから増えた要素を中心に見ていきます。
従来の「一度だけ検索する構成」では、どんな質問に対しても必ず外部検索が実行されていました。一方Agentic RAGでは、AIモデル自身が「この質問に外部情報の参照が必要か」を事前に推論し、不要な場合は検索をスキップして直接回答します。
この事前判断が組み込まれることで、挨拶や一般常識といった検索不要な質問に対して、無駄な処理時間やAPIコストを削減できます。もちろん検索が必要な場合は、取得した結果を評価しながら検索を繰り返す柔軟な構成も可能です。
社内文書のベクトル検索だけでなく、データベースへの問い合わせ、Web検索、業務システムのAPIなど、複数の手段を質問に応じて選び分けます。
たとえば「先月の受注実績と、受注時の見積作成ルール」を聞かれた場合、数値は基幹システムから、ルールは社内規程から取得します。検索先を固定した構成では、このような使い分けができません。
取得した文書が質問に答えるのに十分な内容を含んでいるかを、AI自身が判定します。足りなければ検索の言葉を変えて取得し直すため、最初の検索が外れてもそこで打ち切らずに済みます。
取得結果を見て検索をやり直せる点が、従来の1回検索型との大きな違いです。
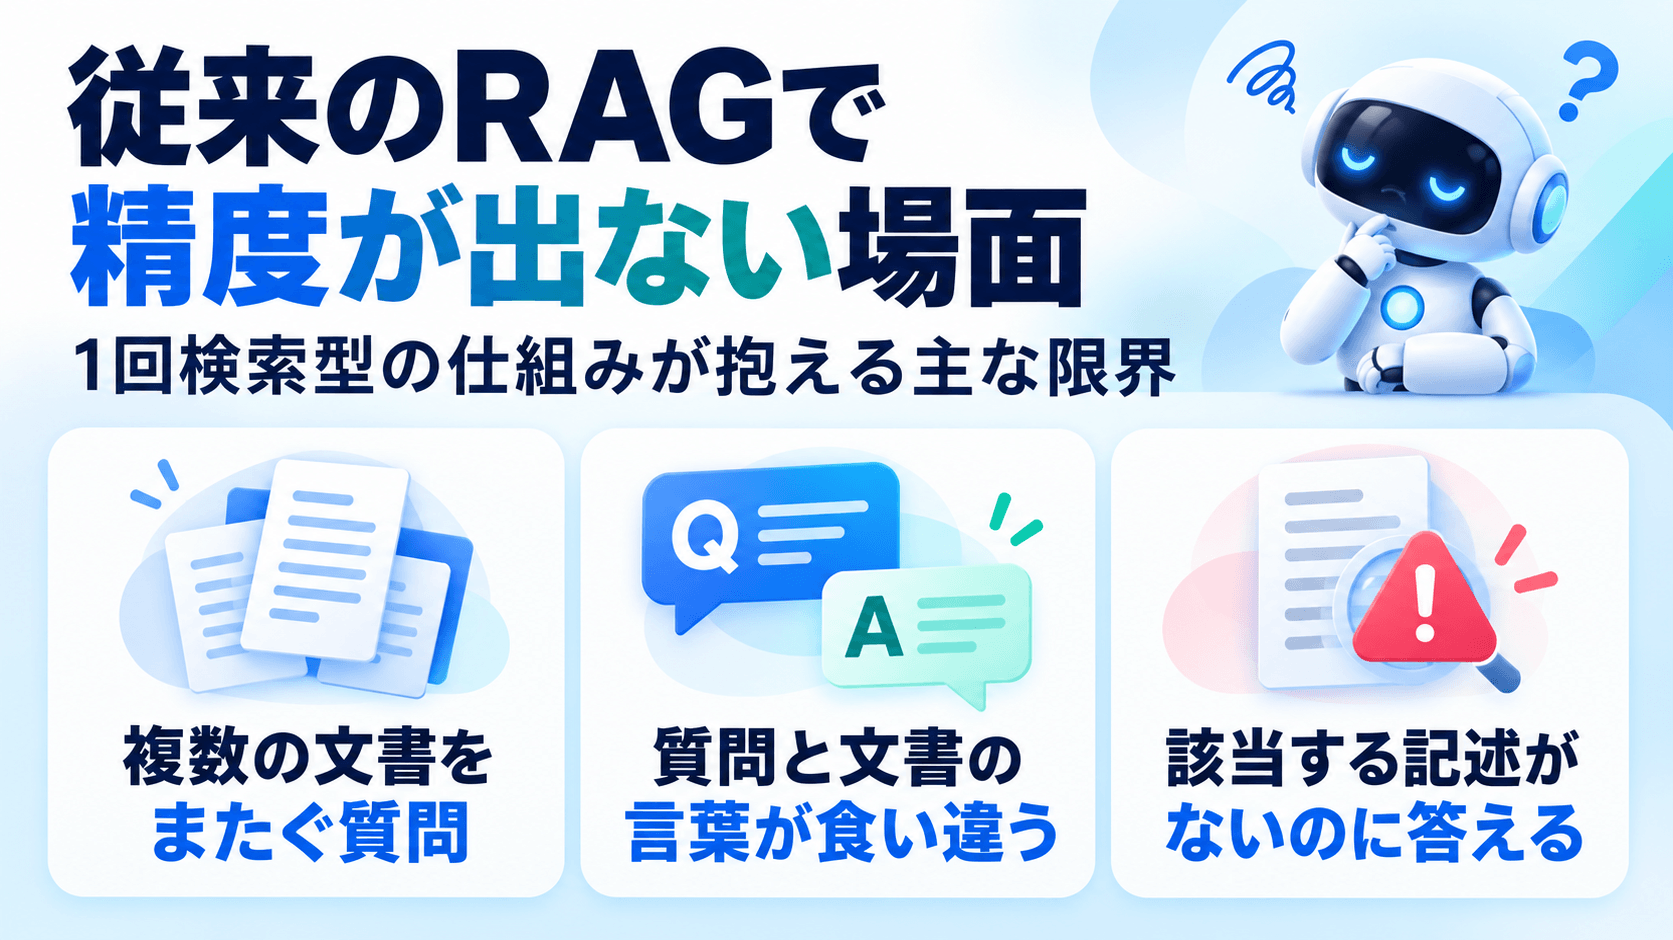
本記事における「従来のRAG」とは、質問に対して1回だけ検索を実行し、その結果から回答を生成する構成を指します。
回答精度が伸びないとき、まず候補になるのは埋め込みモデルの差し替えやチャンク(文書の分割単位)の幅の調整です。ただ、質問の型によっては、検索から生成までを一度で通す仕組みのままでは対応できません。
どこで失敗しているかを確認すると、検索設定の調整で済むのか、仕組みそのものを変えるべきかを判断しやすくなります。ただし失敗の型は、返ってきた回答を眺めるだけでは分かりません。
回答と社内の文書を突き合わせ、どこで拾えていないのかを確かめる作業が必要になります。
「A部署の経費規程とB部署の運用ルールで、出張費の扱いが違うか」といった質問は、複数の文書を突き合わせないと答えが出ません。
一度だけ検索するRAGでは、設定した検索方式で関連する文書やチャンクを取得し、その結果をもとに回答を生成します。片方の規程だけが上位に来て、もう片方を拾えないまま回答が組み立てられ、比較しているようで片側しか見ていない結果になりかねません。
取得する文書の件数を増やせば拾えることもありますが、そのぶん無関係な文書が混ざり、かえって精度が落ちる場合もあります。
現場で使われている言い回しと、文書に書かれている正式名称がずれているケースです。「立替精算のやり方」と聞かれても、規程側の見出しが「一時立替金の取扱い」であれば、検索の一致度が下がります。
言い換えて検索し直す動きがないと、該当する文書があるのに拾えないまま終わります。
類似度の閾値や「回答できない」と判断する仕組みがない構成では、社内に該当する規程がなくても関連度が上位の文書が検索結果として返ることがあります。そこに答えが書かれていなければ、LLMがその文書をもとにもっともらしい文章を生成することがあります。
読み手からは、根拠のある回答と区別がつきません。業務で使ううえで見過ごせない振る舞いです。「該当する記述がない」と返すには、取得した文書が質問に答えているかどうかを判定する仕組みが別に要ります。一度だけ検索してそのまま回答を作る構成では、この判定処理は別途追加する必要があります。
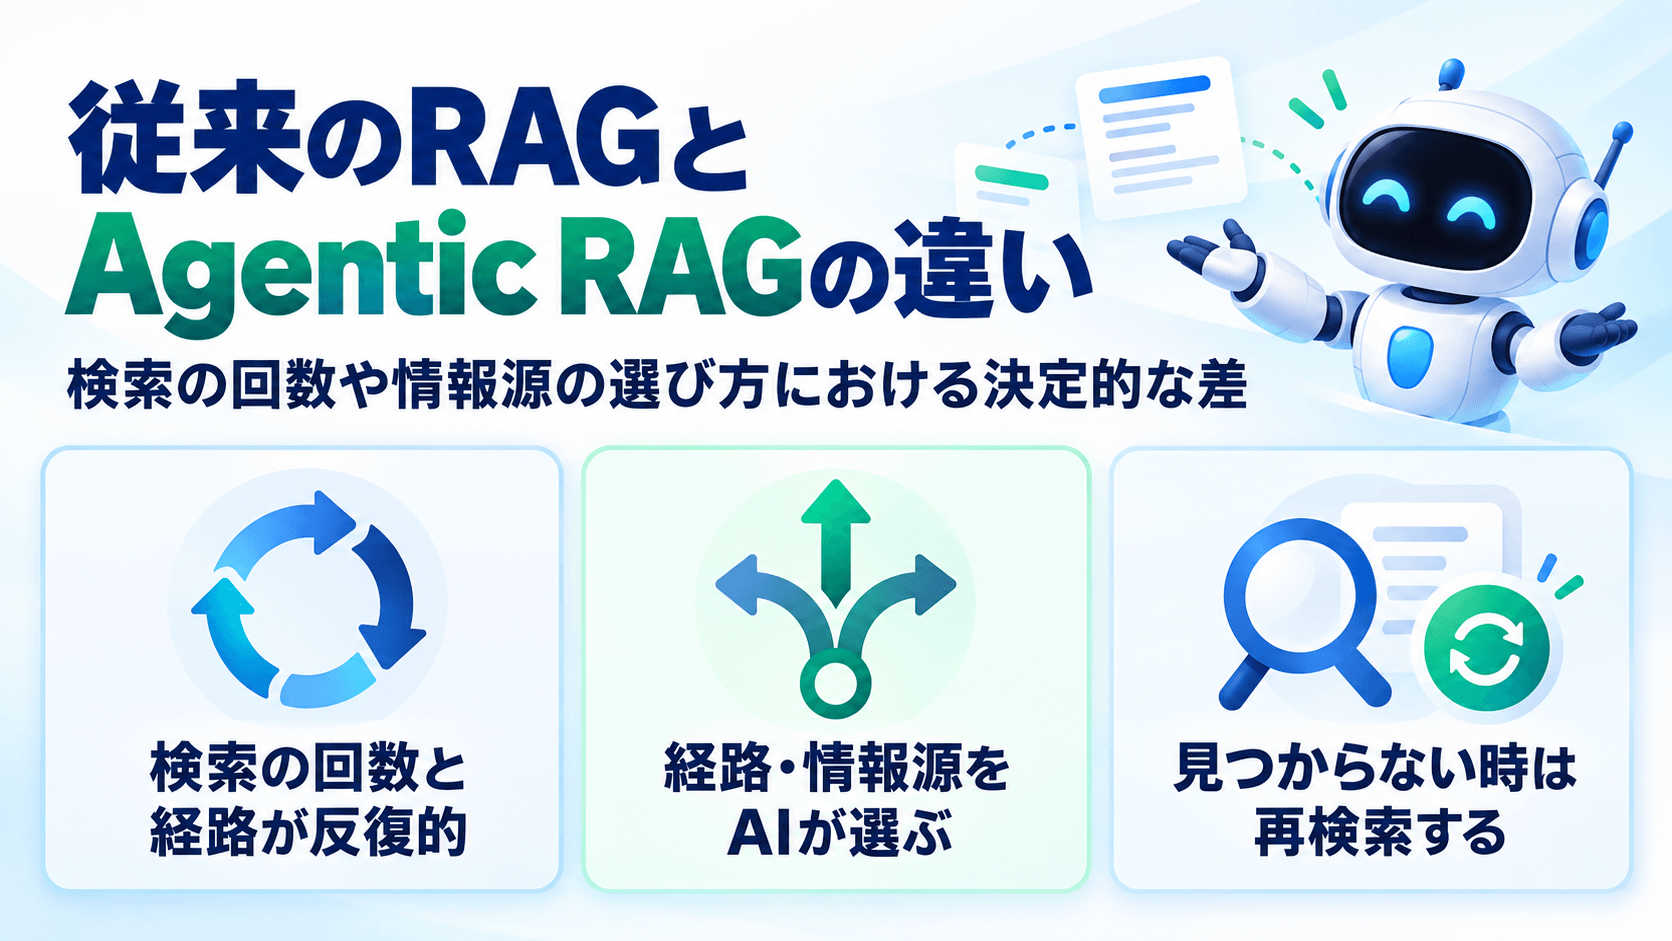
両者の違いは、検索から生成までを一度で通す処理か、必要なだけ繰り返す処理かに集約されます。この差が、扱える質問の幅と、応答時間・コストの両方に効いてきます。
| 観点 | 従来のRAG(1回検索型) | Agentic RAG |
|---|---|---|
| 検索の回数 | 1回 | 必要な回数だけ繰り返す |
| 検索経路の決め方 | あらかじめ固定 | 質問に応じてAIが判断 |
| 検索経路・情報源 | あらかじめ設定した経路・情報源を使う | 質問や途中結果に応じて経路・情報源を選び分ける |
| 見つからないときの挙動 | 関連度が上位の文書で回答を生成 | 検索し直す、または回答できないと返す |
| 応答時間 | 検索1回分で完結する | 処理を繰り返すぶん長くなる |
| コスト | 1問あたり1回分の呼び出し | 判定と再検索のたびに呼び出しが増える |
| 向いている質問 | 単一の文書で答えが完結するもの | 複数文書の突き合わせ、条件つきの絞り込み |
分かれ目になるのは、社内で実際に飛んでくる質問に対し、1回の検索で回答に必要な根拠が揃うかどうかです。問い合わせの大半が定型的なものであれば、従来のRAGのほうが速く、費用も抑えられます。
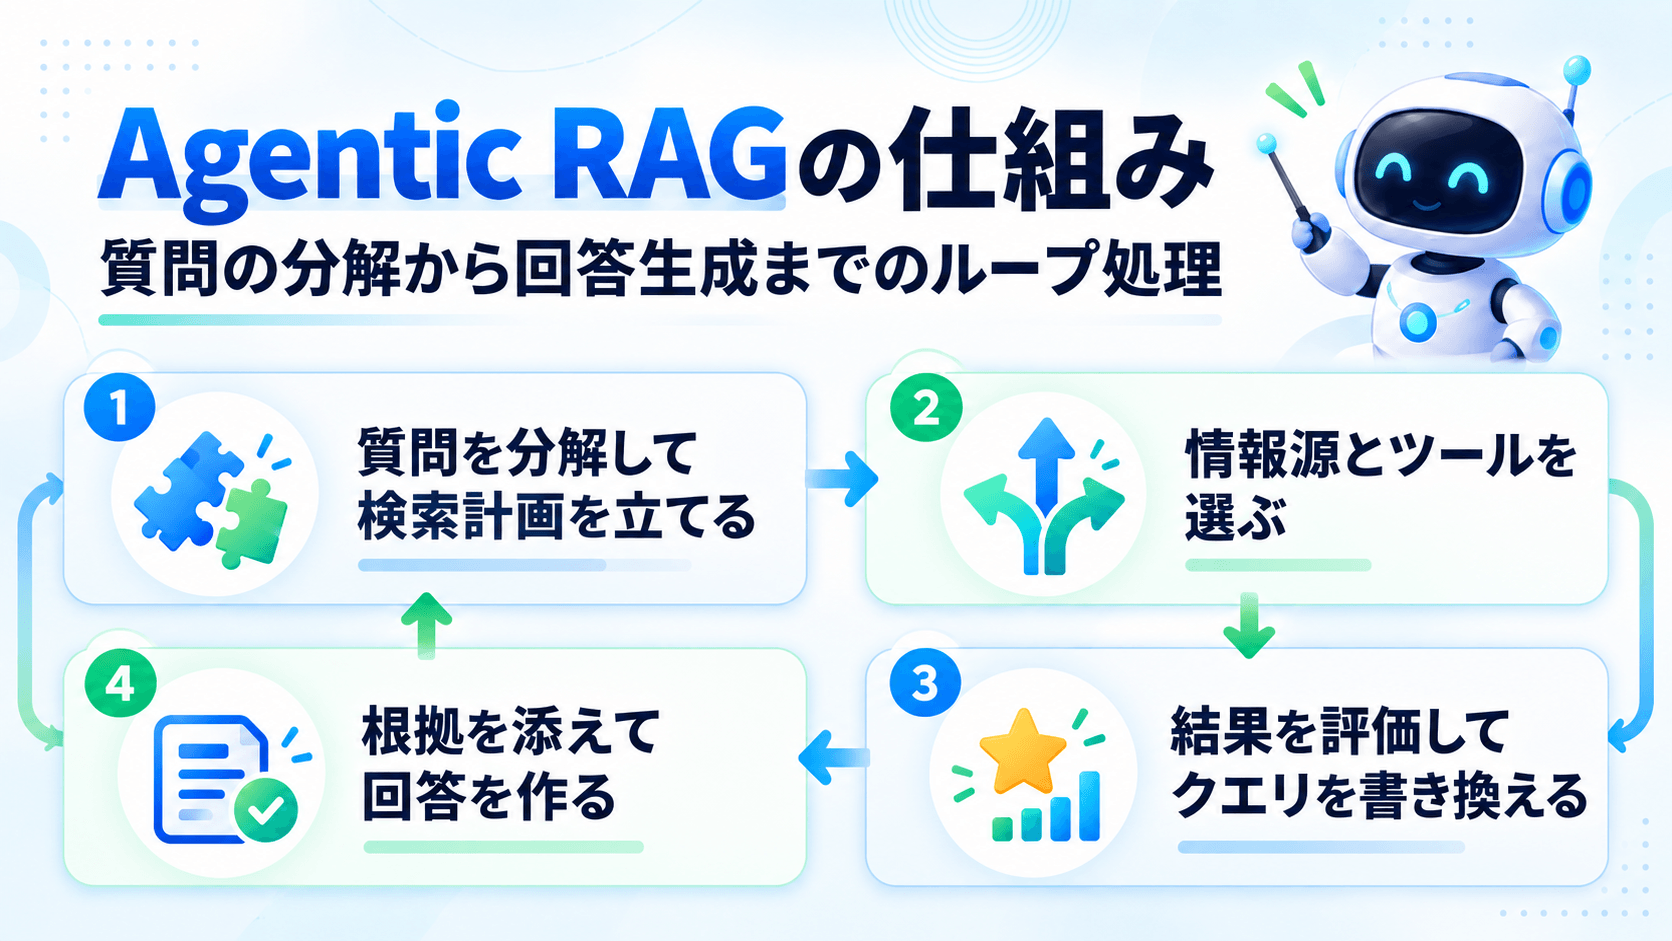
実装によって仕組みは異なりますが、共通する処理があります。ここでは代表的な流れを4つに分けて説明します。
LangGraphの公式チュートリアルで示されているのは、検索するか直接答えるかの判断・取得・関連性の評価・質問の書き換え・回答生成という5つの処理でループを組む例です。
受け取った質問に対して、外部文書が必要か判定します。必要と判断した場合、質問が複数の要素を含んでいれば、答えるために何を調べる必要があるかに分けます。
「出張費の上限と、承認が必要な金額」であれば、上限額と承認基準の2つを別々に調べる形になります。
分解の精度は、質問の書かれ方に左右される点に注意が必要です。利用者が一度に複数のことを尋ねる運用であれば、この段での取りこぼしが起きやすくなります。
分解した要素ごとに、どこを見るかを決めます。社内規程はベクトル検索、数値は業務システムのAPI、最新の法令はWeb検索、といった振り分けです。
情報源を複数つないでおくほど対応できる質問は広がりますが、そのぶん選択を誤る余地も増えます。接続先を絞って始めるほうが、動きを追いやすくなります。
取得した文書が質問に十分答えているか判定し、不足があれば検索キーワードを変えて再取得します。
「立替精算」で見つからなければ「一時立替金」に言い換える、といった動きです。この繰り返しに上限を設けておかないと、処理が終わらなくなります。
集めた文書をもとに回答を生成します。どの文書を参照したかを併せて示すかどうかは、設計次第です。
業務で使う場合、参照元を表示するかどうかで運用の負荷が変わります。回答が正しいかを人が確かめる際、参照元がなければ結局すべて探し直すことになるためです。
参照元は、後から原因を切り分けるときにも使えます。どの文書を見て答えたかが残っていれば、誤りが検索の段で起きたのか、回答を作る段で起きたのかを判別できます。
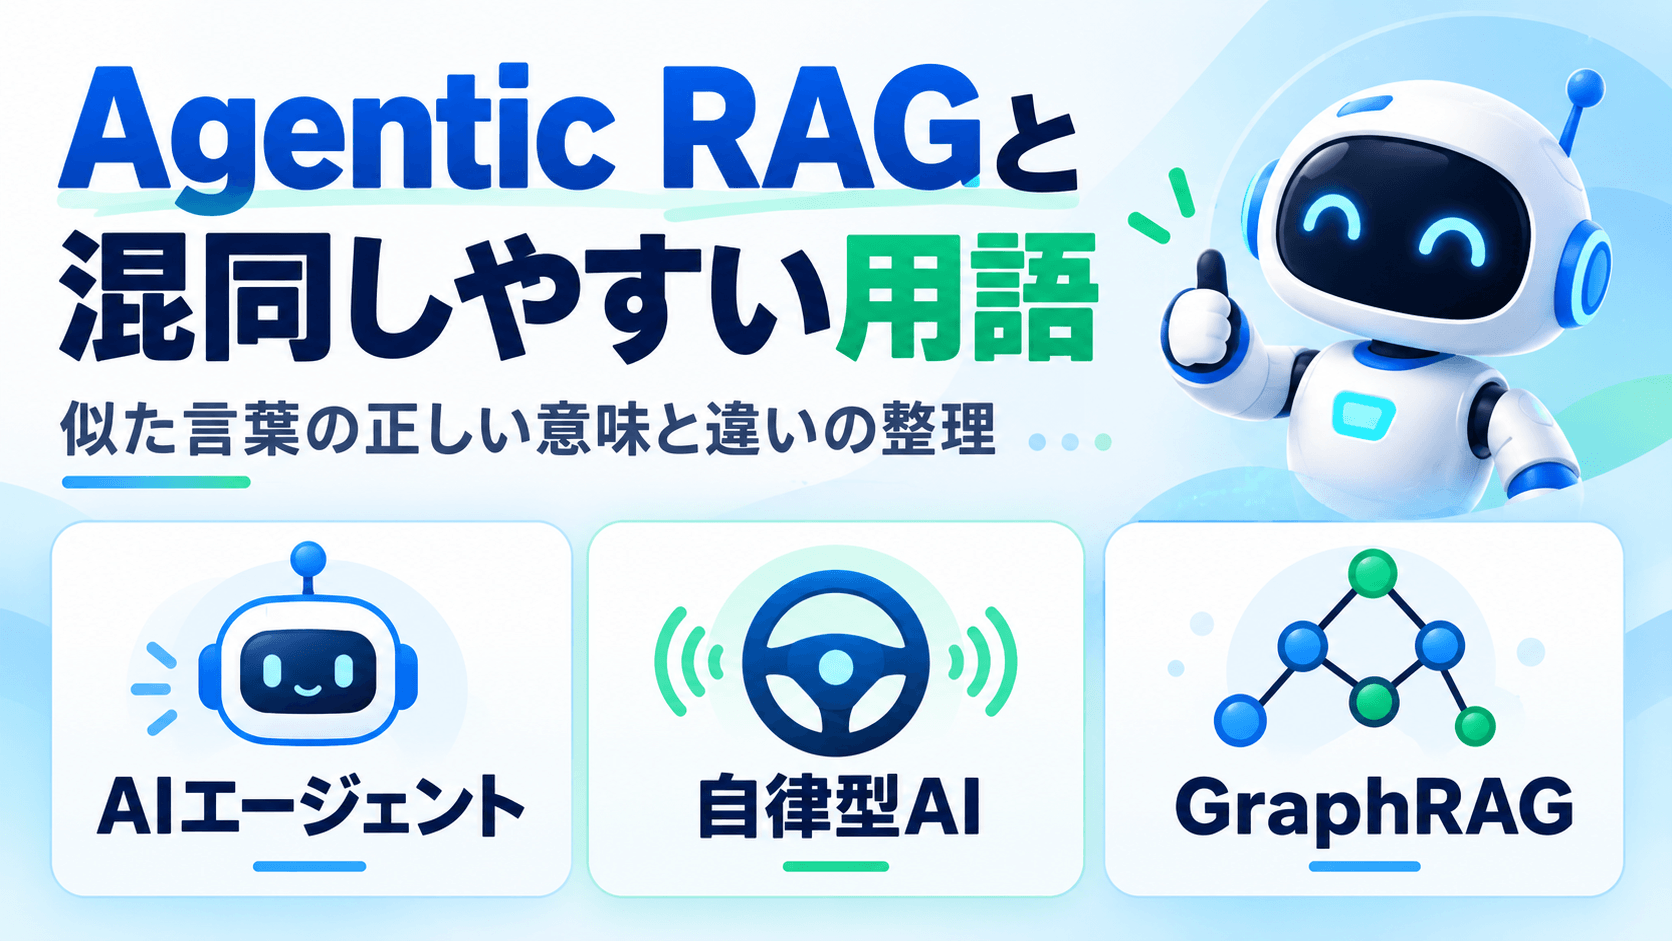 「エージェント」を冠する言葉が増え、指す範囲が重なっています。社内で検討する際に注意したいのは、同じ言葉を別の意味で使うと話が噛み合わなくなる点です。
ここまでの説明を踏まえ、それぞれの違いを以下にまとめました。
| 用語 | 何を指すか | Agentic RAGとの関係 |
|---|---|---|
| AIエージェント | 目標を与えると手順を自分で決めて実行するAIの総称 | Agentic RAGはこれを検索に使った形。Agenticは「エージェントのように動く」を表す形容詞 |
| 自律型AI | 人の指示を都度受けずに判断して動くAIの考え方 | AIエージェントに近い概念ですが、同義ではありません |
| Advanced RAG・モジュラーRAG | RAGの設計の分け方。検索の前後を高度にする工夫や、機能を部品に分ける設計 | 作り替える前の改善策。この範囲で足りることもある |
| GraphRAG | 文書に含まれる情報や関係性をグラフの形で持たせる手法 | 情報の持ち方を変えるもので、Agentic RAGと併用できる |
Agentic Searchとも呼ばれますが、こちらは検索・取得の側から見た呼び名です。Agentic RAGの検索部分に使われるもので、常に同じものを指すとは限りません。
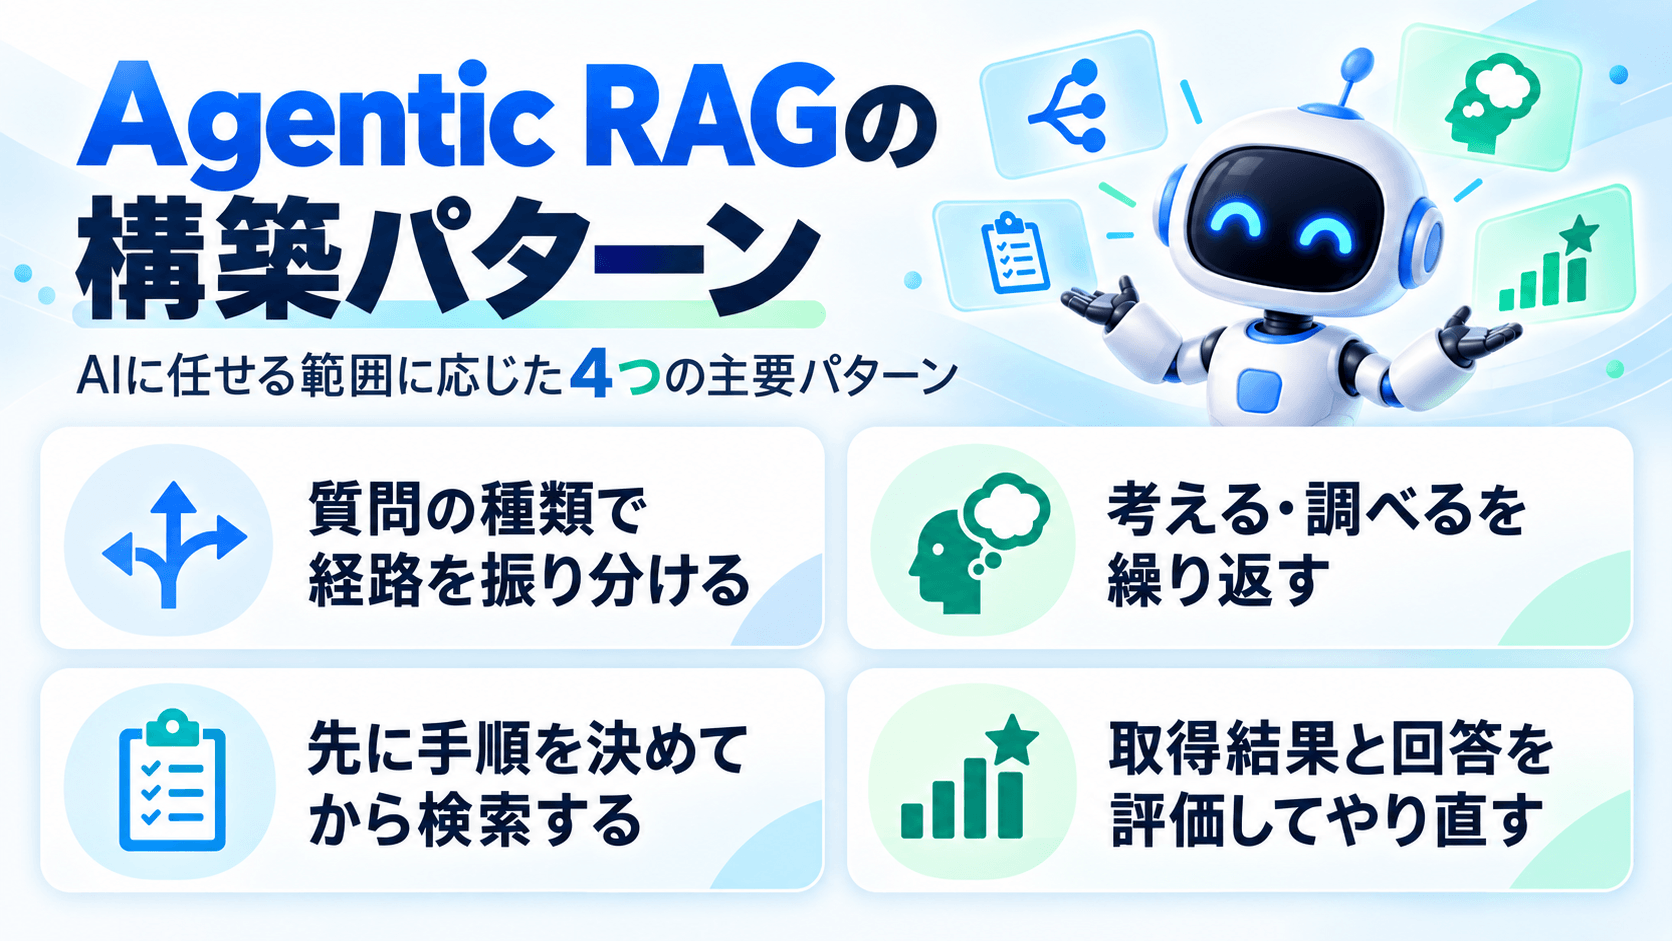
Agentic RAGは、 エージェントにどこまで任せるかによって、いくつかのパターンに分かれます。ただし、それぞれが排他的なわけではなく、複数を組み合わせる構成も可能です。
以下は、エージェントに任せる範囲が狭いものから順に並べています。任せる範囲が広がるほど答えられる質問は増えますが、処理時間とコストは構成によって変わります。
受け取った質問を最初に分類し、最適な検索経路へ割り当てる構成です。定型的な質問は従来どおり1回の検索で素早く返し、複雑な質問のみをAgentic RAGの繰り返し処理に回します。 分類基準としては、「対象データ(人事規程か、製品仕様か)」による振り分けと、「複雑さ(単一文書で完結するか、複数文書の突き合わせが必要か)」による振り分けが一般的です。
エージェントに任せる範囲が限定されるため、既存のRAGシステムに追加しやすいのが最大のメリットです。現在稼働中のRAGがあり、特定の複雑な質問だけ精度を改善したい場合、このパターンから始めると影響範囲とコストを最小限に抑えられます。 ただし、振り分けの精度が低いと、高度な処理が必要な質問が従来の経路に流れてしまいます。回答そのものの精度だけでなく、「正しい経路へ分類できているか」も継続的な評価が必要です。
「次に何を調べるべきか」を推論(Reasoning)し、検索を実行(Acting)し、その結果を見て再び考える……というループを繰り返す構成です。エージェントの自律的な動きとして最も広く使われている手法です。 事前に手順を決めず、状況に応じて柔軟に動くため、調べてみないと次に必要な情報が分からない探索的な質問(例:原因究明や抽象的な調査依頼)に適しています。
一方で、求める答えが出るまでループが続くため、応答時間やAPIコストの見積もりが立てにくい点がデメリットです。実運用では「最大〇回まで」といった上限設定(Max Iterations)が不可欠です。
質問を受けた直後に「調べるべき項目」をすべて洗い出し、計画を立ててから順に実行する構成です。 ReActとの最大の違いは、手順を最初に確定させる点です。実行前に全体像が決まっているため、処理時間やコストの見積もりが立てやすく、途中経過も追いやすくなります。定期的なレポート作成など、確認項目が毎回決まっている業務と非常に相性が良いパターンです。 その反面、実行途中で想定外の結果が返ってきた際、計画を柔軟に立て直せるかどうかは実装に依存します。
取得した文書や生成した回答をAI自身が評価(採点)し、基準に満たなければ検索や生成をやり直す構成です。 代表例として、取得の要否と生成内容の両方を評価する「Self-RAG」や、主に取得した文書の品質を評価する「Corrective RAG(CRAG)」があります。評価の軸は「参照文書に沿っているか(ハルシネーションがないか)」と「質問に的確に答えているか」の2点が基本です。 回答の品質を一定以上に保てる強力な手法ですが、1回の質問に対して評価プロセスが複数回走るため、処理時間とコストは増加します。顧客対応チャットボットのように即時性が求められる場面では、採点基準や再検索の回数を絞るチューニングが求められます。
「検索を担当するエージェント」「結果を分析するエージェント」「最終回答をまとめるエージェント」といったように、役割を分担して協調させる構成です。複数の調査を並行して実行させることもできます。 対象のデータが人事・法務・技術などで分かれており、領域ごとに異なる検索手法が必要な場面で真価を発揮します。
ただし、システム構成が複雑になるため、誤った回答が出た際の原因特定(デバッグ)が難しくなるのが難点です。まずはルーティングやReActなど他のシンプルなパターンを試し、要件を満たせない場合の最終手段として検討するのが賢明です。
読者が自社の課題と照らし合わせて「どれを選ぶべきか」を即座に判断できるよう、各パターンのメリット(向いている業務)とデメリット(運用上の注意点やコスト)のコントラストを明確にし、流し読みでも要点が掴めるよう太字でメリハリをつけました。ルーティング末尾にあった「。。」などの細かなタイピングミスや、冗長な言い回しもあわせて整えています。
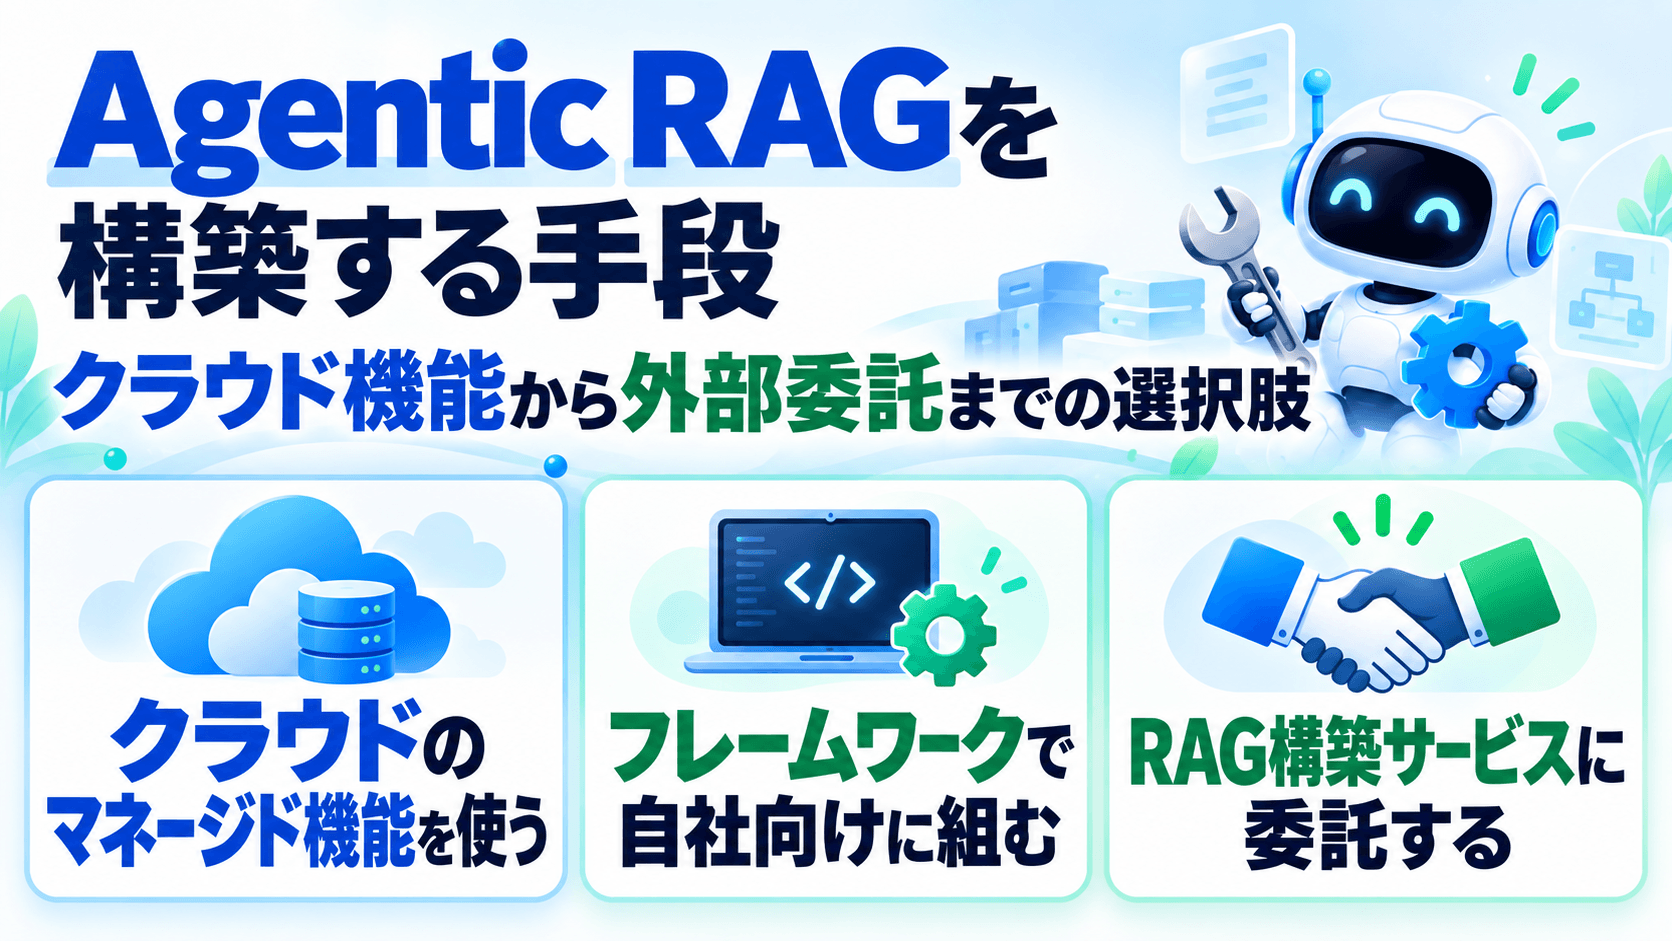
どのパターンで作るかとは別に、「どこまで自前で用意するか」という選択があります。2026年に入って主要クラウドでマネージド機能の一般提供や拡充が進んだため、エージェントを一から組む以外の道が増えました。
| 手段 | 代表例 | 向いているケース | 自社側に必要なもの |
|---|---|---|---|
| クラウドのマネージド機能 | Azure AI Search、Amazon Bedrock、Google Cloud | すでに該当クラウドを使っている | 文書の整備と設定 |
| フレームワークで組む | LangGraph、LlamaIndex、Dify | 独自の判定ルールを入れたい | 開発者と運用体制 |
| 構築サービスに委託 | RAG構築の提供事業者 | 社内に開発リソースがない | 要件の洗い出しと予算 |
主要クラウドは、複数回の検索や検索計画の作成を、サービス側の機能として提供しています。2026年9月時点の状況は次のとおりです。
| クラウド | 機能名 | できること | 提供状況 |
|---|---|---|---|
| Microsoft Azure | エージェント検索(agentic retrieval)(Azure AI Search) | 複雑な質問をサブクエリに分割し、並列で検索してセマンティック ランカーで再ランク付けする | 2026-04-01 REST APIではナレッジベースから根拠情報を取得する最小構成の機能が一般提供。LLMによるクエリ計画・回答合成・推論量の調整などはプレビューAzure portal/Microsoft Foundry portalでのフル機能利用もプレビュー |
| AWS | Managed Knowledge BaseのAgentic Retriever(Amazon Bedrock) | 複雑なクエリを段階的な検索計画に分解し、複数のナレッジベースをまたいで検索する | 2026年6月17日に一般提供。東京リージョンを含む |
| Google Cloud | Agent Searchのagentic retrieval | 計画を立てて順に検索を実行し、前段の結果を次の検索に使う | 一般提供だが、対象は選定された顧客に限られる |
自社が使用しているクラウドで提供されていれば、まずこの機能で試すのが手数として少なくて済みます。ただし同じ「エージェント検索」でも、一般提供の範囲とプレビューの範囲が分かれている点には注意が必要です。判定のロジックを細かく制御したい場合や、複数のクラウドにデータが分かれている場合は、フレームワークによる構築が候補になります。
判定の基準や繰り返しの上限を自社の業務に合わせて決めたい場合は、フレームワークを使って組みます。処理の流れをグラフとして定義できるLangGraph、検索まわりの部品が揃ったLlamaIndex、GUI上でワークフローを構成できるDifyなどが候補です。
外部システムとの接続を標準化するMCP(Model Context Protocol)に対応した実装も出ています。自前で組まず既製のエージェントを探す場合は、AIエージェントのサービス比較から候補を確認できます。
社内に開発リソースがない場合は、構築を請け負う事業者に依頼する形になります。文書の前処理から検索の調整、評価の仕組みまで含めて任せられるかは事業者によって幅があるため、範囲を確認したうえで比較しましょう。
候補を横並びで見たい場合は、生成AI(RAG構築)サービスの比較と企業一覧から資料請求できます。
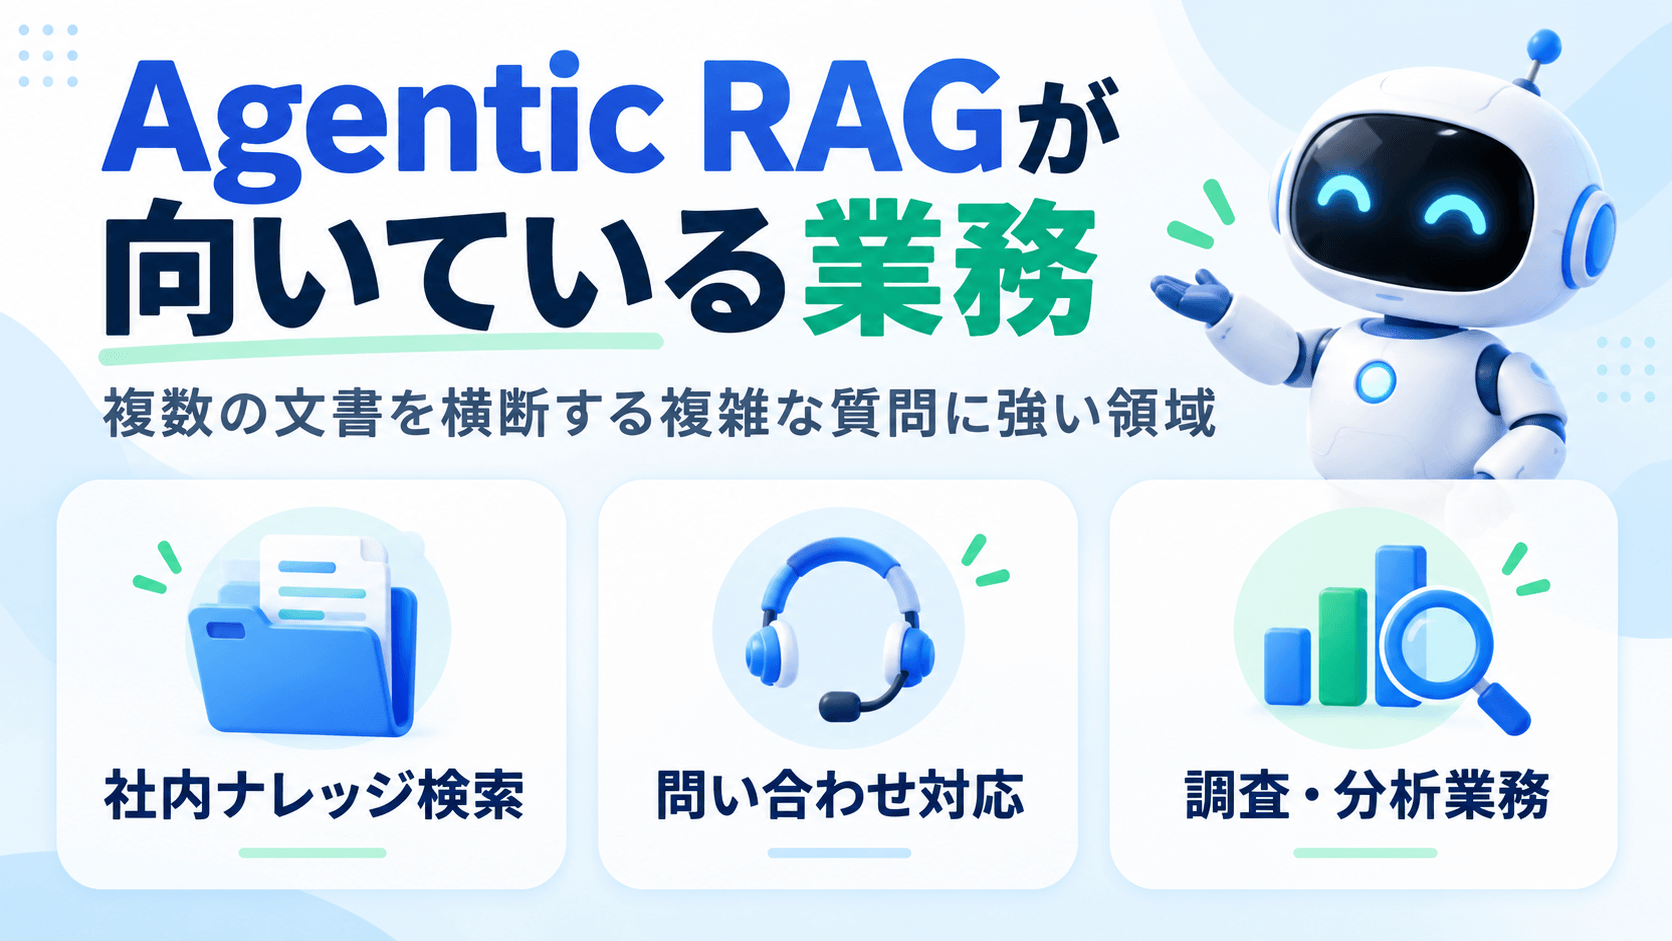
繰り返しの検索が効いてくるのは、質問が一定の型に収まらない業務です。質問の幅が広いほど、あらかじめ検索経路を決めておくことが難しくなるためです。
同じ社内向けの検索でも、定型的な質問が中心なら従来のRAGで足りる場合があります。
規程・マニュアル・稟議書といった、性質の違う文書が別々の場所に置かれている状態で使う検索です。
「この案件と似た条件で過去に承認が下りた例はあるか」のような質問は、稟議書と規程の両方を閲覧しなければ回答が出ません。文書の種類ごとに探し方を変えられる点が効いてきます。
導入の前提として、どの文書をどこまで参照させるかを決めておく必要があります。横断して探せるということは、権限のない文書に届く経路も増えるためです。文書の保管場所が部門ごとに分かれている場合は、まず所在を把握するところから始めることになります。
顧客や社内からの問い合わせに対して、一次回答を返す用途です。特に違いが出やすいのは、契約内容と製品仕様のように参照先が分かれる質問でしょう。
回答できないと判断したときに、無理に答えを作らず有人対応へ渡せる点も違いになります。一度の検索結果をそのまま回答作成に渡す構成では、十分な根拠がなくても回答を生成する場合があるためです。有人対応へ切り替えるには、関連度や回答可能性を判定する条件を別途設ける必要があります。
市場調査や技術調査のように、社内資料と外部の情報を両方見ながら進める業務です。調べた結果を見て次に何を調べるかが決まるため、あらかじめ検索経路を固定できません。
契約書や社内規程を条件と突き合わせる作業も、複数の文書を横断する例として同じ形です。外部の情報を参照させる場合は、取得元と取得日を回答に残す設計にしておくと、後から根拠を確認できます。
業務ごとの活用の広がりはAIエージェントおすすめ13選でも紹介しています。
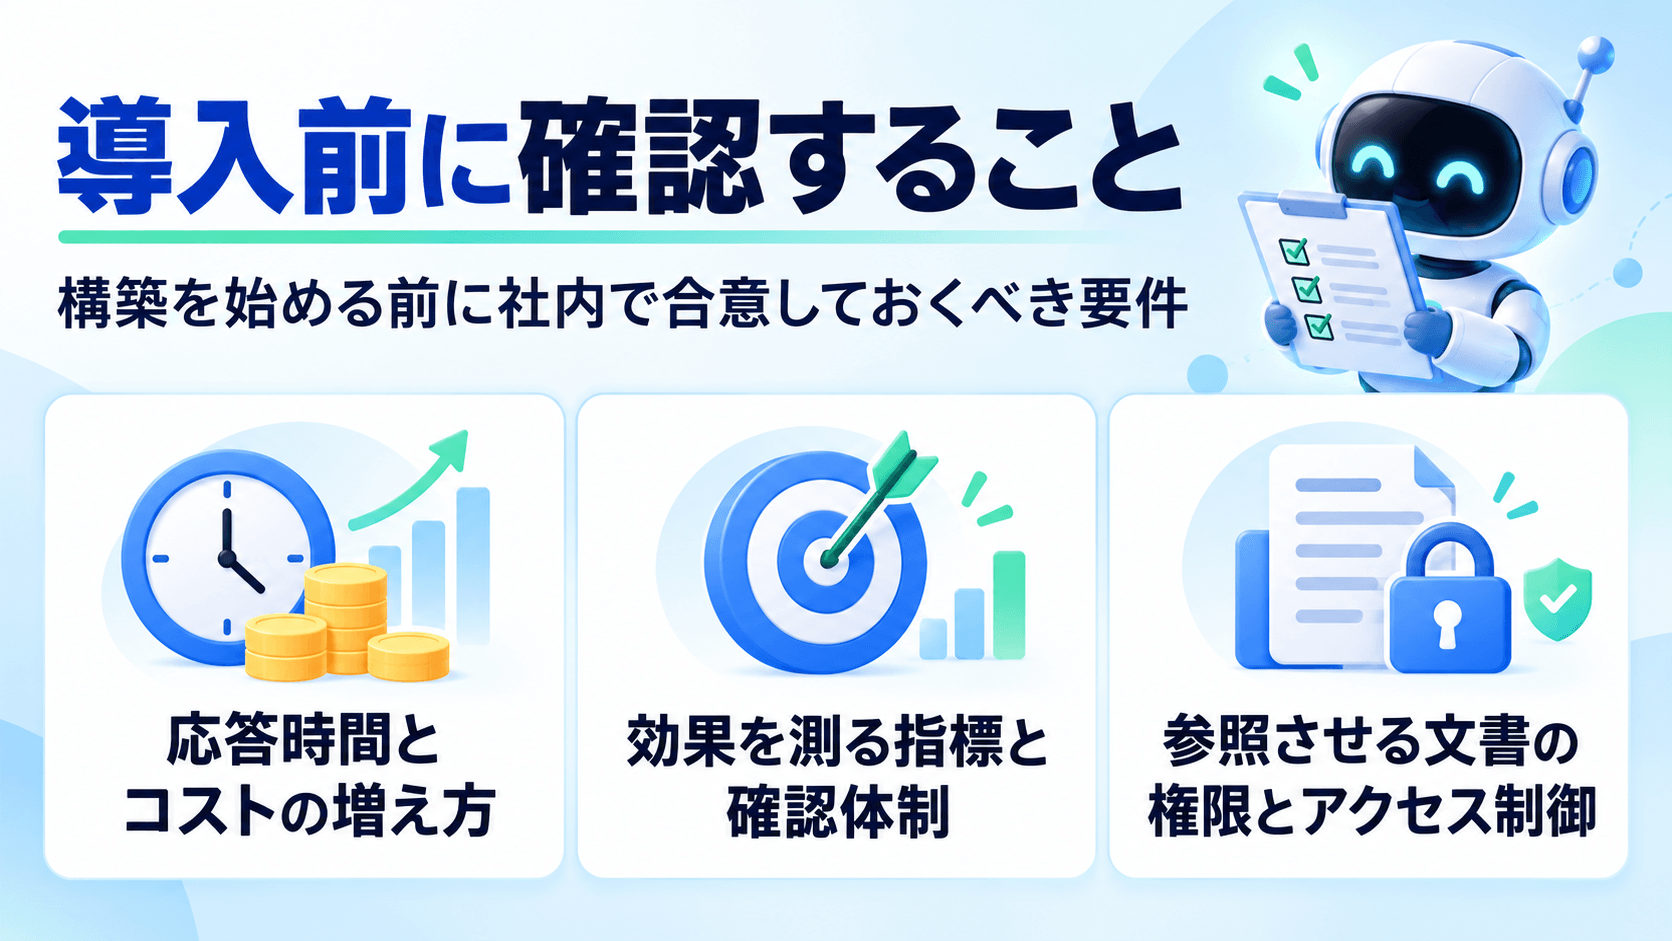
技術面だけでなく、運用の条件も先に決めておく必要があります。以下の3点は、構築を始める前に社内で合意しておく項目です。
判定と再検索を繰り返す分、LLMの呼び出し回数が増えます。呼び出しは、検索が必要かどうかの判定、取得した文書の評価、回答の生成のそれぞれで発生します。1回の質問で何回呼び出すかは構成によって変わるため、想定される質問でおおよその回数を測ってから見積もっておきましょう。
利用者の側から見ると、応答が返るまでの時間も伸びます。社内検索なら待てても、顧客対応の画面では許容されない場合があるため、用途ごとに待てる時間の上限を先に決めておくことが重要です。
改善効果を正しく評価するために、事前に測定指標(観点)を定めておく必要があります。回答が参照した文書に沿っているか、質問に答えられているか、答えに必要な文書を拾えているか、の3点が基本です。いずれも、質問と正しい回答の組をあらかじめ用意しておかないと測れません。
あわせて、誤った回答が出たときに誰が気づき、誰が直すのかも決めておきましょう。
複数の情報源をまたいで検索できるということは、本来見せてはいけない文書に届く経路も増えるということです。
利用者の権限に応じて参照範囲を絞る仕組みは、構築の段階で入れておきましょう。後から追加すると、検索の対象から作り直しになる場合があります。クラウドのマネージド機能を使う場合も、既存の権限設定とどこまで連携できるかは事前の確認が要ります。
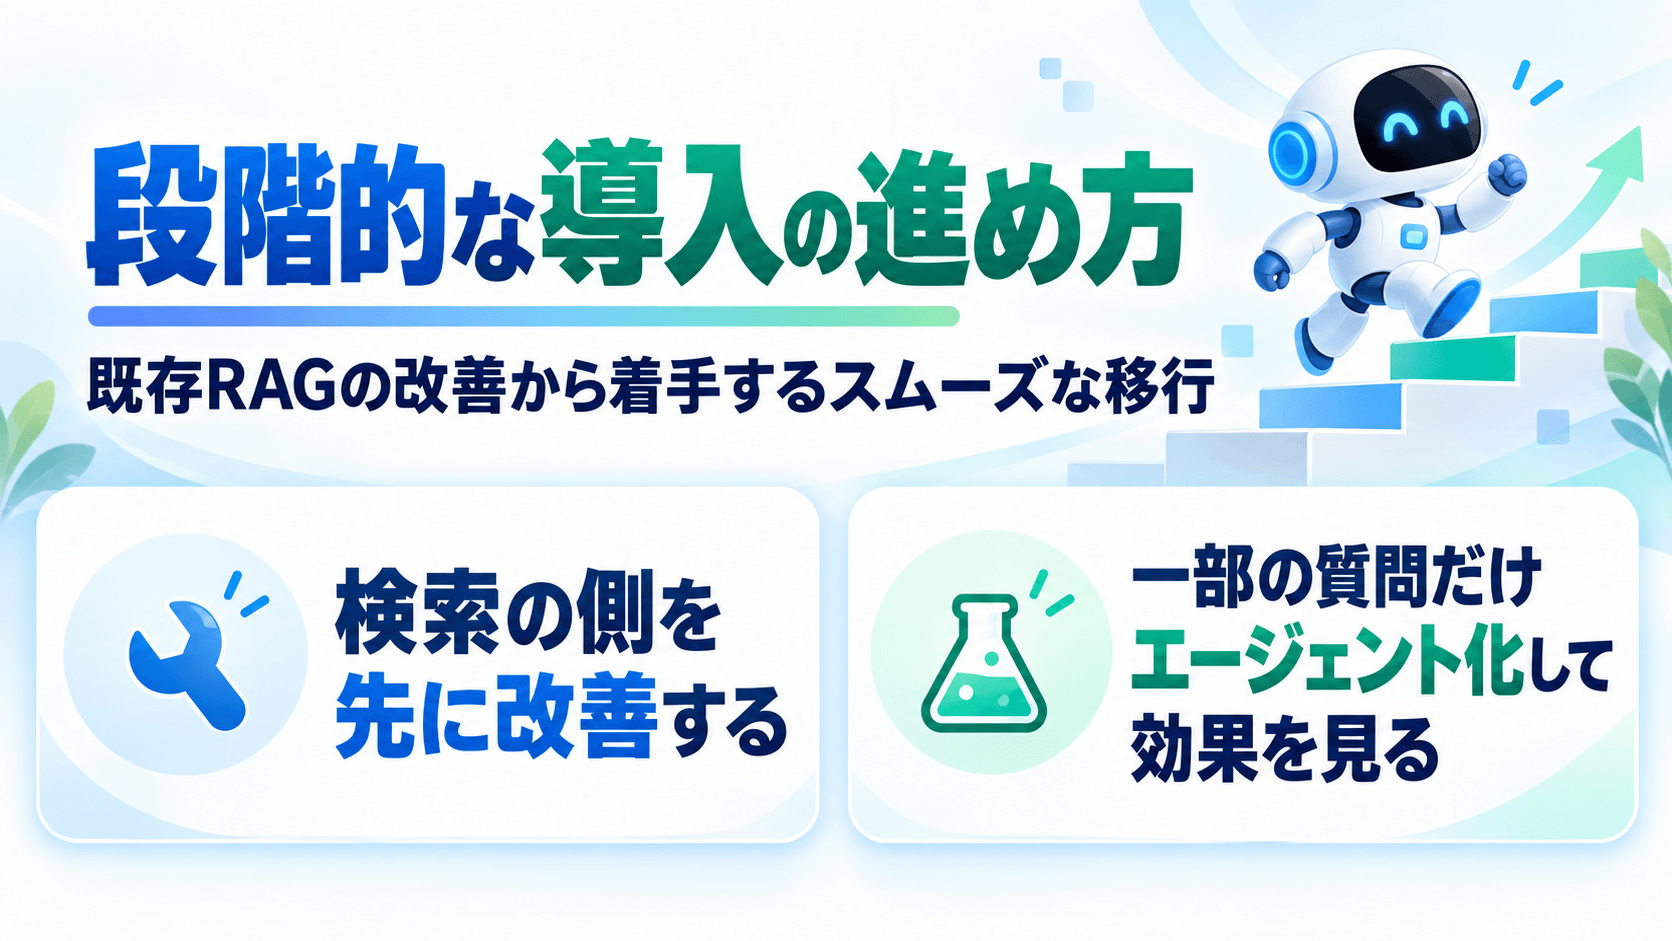
作り替えの前に、まず現在のRAGが答えられていない質問を書き出した上で型ごとに分類。部分的な改善で足りるのか、繰り返し検索まで必要なのかを見極める流れです。元の検索精度が低いまま全体をエージェント化しても、同じような検索結果を何度も取得するだけになりかねません。
キーワード検索とベクトル検索を組み合わせるハイブリッド検索、取得した文書を並べ替えるリランキング、質問を言い換えるクエリ書き換えは、いずれも従来のRAGに追加できます。先に挙げた「質問の言葉と文書の言葉が食い違う質問」であれば、この段階の改善だけで解決できるケースもあるでしょう。それでも答えられない質問が、Agentic RAGを検討する主な対象です。
残った質問のなかから、複数文書の突き合わせが必要なものに絞って、繰り返し検索を試します。対象を選ぶ基準は、件数の多さではなく、答えられていないかどうかです。全体に適用する前に対象を絞れば、応答時間とコストの増え方も測れます。効果と負荷の両方を確認してから、範囲を広げましょう。
Agentic RAGを検討するときは、まず現在のRAGで答えられていない質問を集め、原因を分けて確認します。
効果が出るのは、複数の文書をまたぐ質問や、条件によって参照先が変わる質問です。定型的な問い合わせが中心であれば、従来のRAGのほうが速く、費用も抑えられます。
検討を始めるときは、いまのRAGが答えられていない質問を書き出すところからです。言葉のずれで拾えていないなら検索の調整、複数の文書をまたぐ質問が多いなら繰り返しの検索、そもそも社内に文書がないなら整備が先になります。
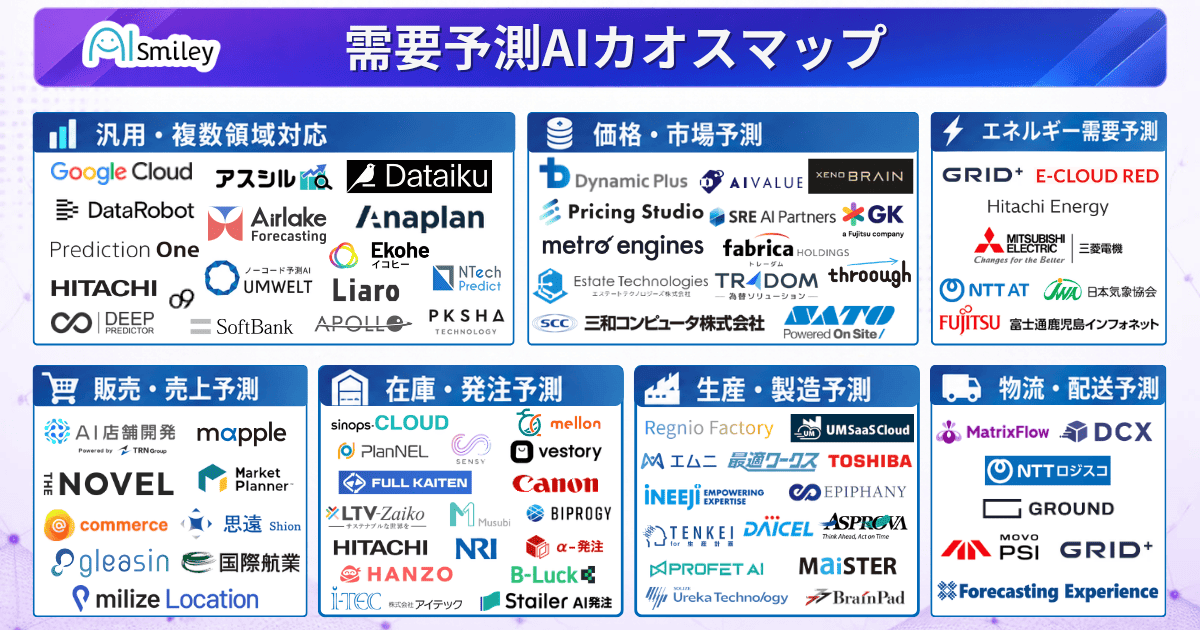
複数の事業者を比較したい場合は、RAGソリューションカオスマップで80製品以上を用途別に確認できます。
アイスマイリーでは、生成AIのサービス比較と企業一覧を無料配布しています。課題や目的に応じたサービスを比較検討できますので、ぜひこの機会にお問い合わせください。
同じものを指します。日本語で書くか英字のまま書くかの違いで、IBMなど一部のベンダーは「エージェント型RAG」、技術系の記事では「Agentic RAG」や「エージェンティックRAG」と表記しています。 社内資料では表記を一つに決めておくと、検索や共有の際に取り違えを防げます。
用途によっては、従来のRAGのほうが適しています。1回の検索で回答に必要な根拠が揃うのであれば、繰り返し検索を行う必要はなく、そのほうが応答も速く費用を抑えやすいでしょう。質問の種類に応じて経路を振り分け、定型的なものだけ従来のRAGで処理する構成も選べます。そのため、Agentic RAGへ切り替えるかどうかは、システム全体ではなく質問の種類ごとに考えるのが適切です。
上がるとは限りません。検索そのものの質が低い状態でエージェント化すると、繰り返し取りに行っても同じように的外れな文書が返ってきます。 そもそも文書に書かれていない内容は、何度検索しても出てきません。文書の整備や検索の調整で改善できる範囲を先に確認し、それでも残る質問に適用するほうが、費用に対する効果は見込めます。
業務の課題解決に繋がる最新DX・情報をお届けいたします。
メールマガジンの配信をご希望の方は、下記フォームよりご登録ください。登録無料です。


FOLLOW US
SNSをフォローして、最新情報をチェックできます!


AI製品・ソリューションの掲載を
希望される企業様はこちら