


生成AI
最終更新日:2026/10/19
「社内FAQをRAGで自動化したい」——そう考えて構成を検討し始めると、突き当たるのが「ベクトルデータベース(Vector DB)」の選定です。
しかし、いざ調べると「Pineconeなどの専用製品を新規契約すべきか」「運用中のPostgreSQL(pgvector)やOpenSearchで十分なのか」で頭を悩ませる担当者が後を絶ちません。
本記事では、ベクトルDBの基礎的な仕組みから既存DBとの違い、RAGでの活用法、主要製品の比較、そして導入後に後悔しないための「選定基準と運用の落とし穴」までを網羅して解説します。自社の要件に最もコストパフォーマンス良くフィットする構成が明確になります。
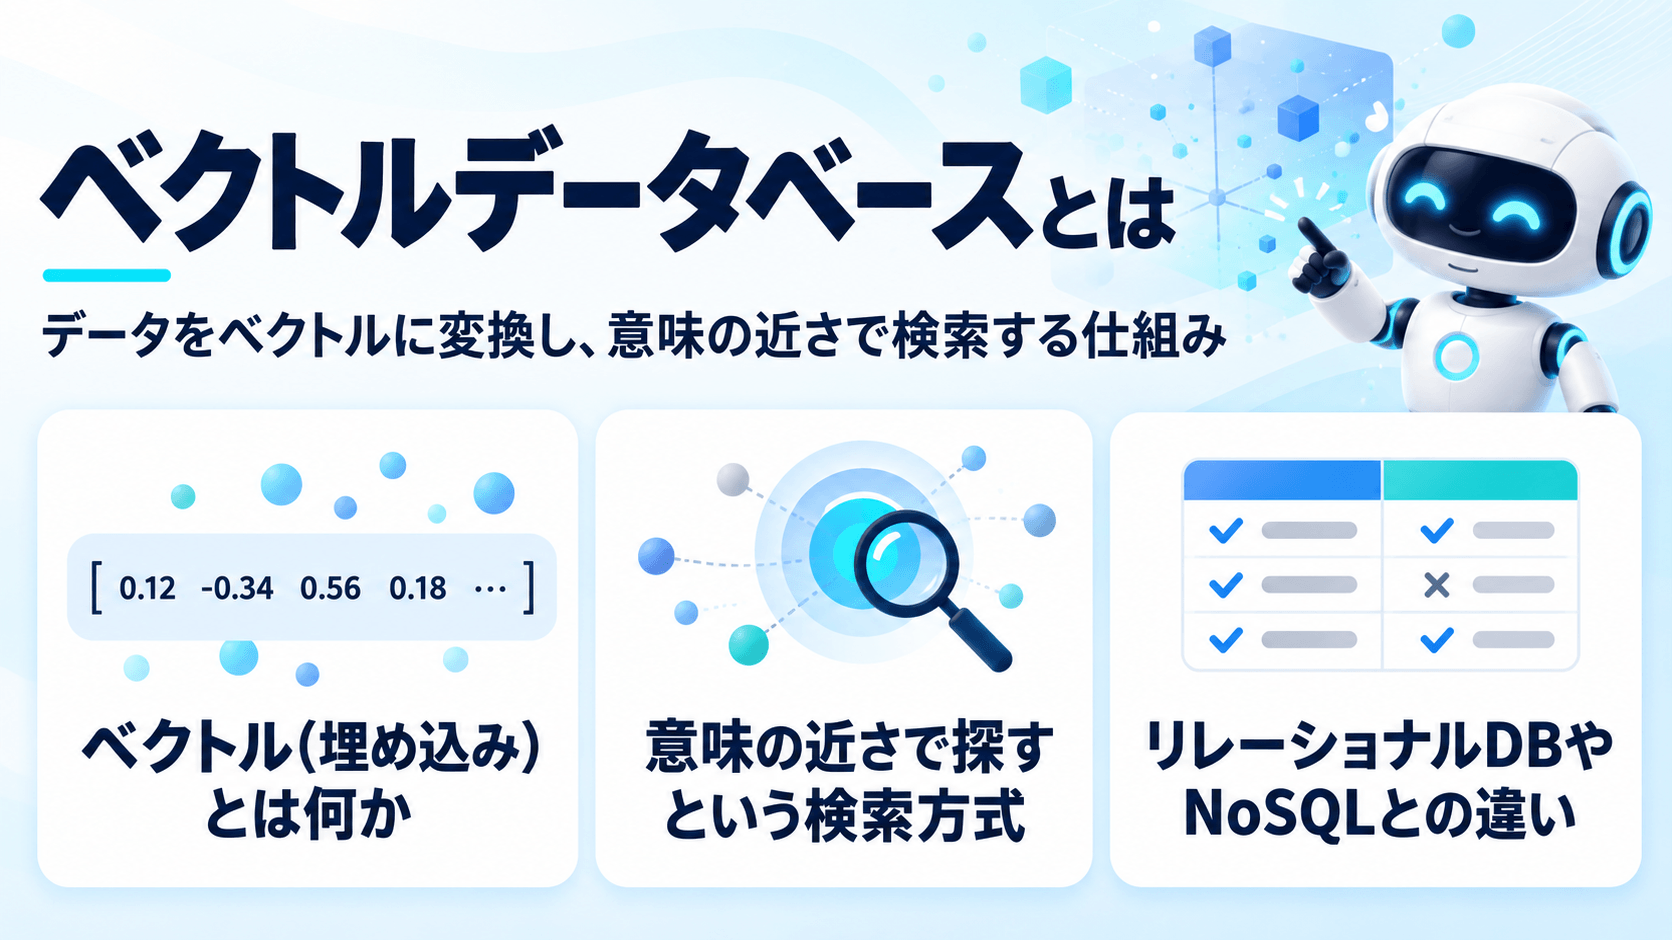
ベクトルデータベースは、テキスト・画像・音声などのデータを「ベクトル」と呼ばれる数値の並びに変換して保存し、意味の近いものを高速に探せるようにしたデータベースです。
生成AIの普及に伴い注目されていますが、技術自体は推薦システムや画像検索で以前から使われています。
従来のデータベースが「条件に一致するデータ」を返すのに対し、ベクトルデータベースは「問い合わせたデータに近いものを、近い順に」返します。返し方の違いが、扱えるデータの種類と用途を分けています。
ここでいうベクトルとは、データの意味的な特徴を数値の並びで表したものです。文章や画像を埋め込みモデル(Embeddingモデル)に通すと、その内容を表す数百から数千個の数値が出力されます。
たとえばOpenAIのtext-embedding-3-smallは既定で1536個、text-embedding-3-largeは3072個です(APIの指定で短縮もできます)(OpenAI公式ドキュメント)。
出力された数値の並びは、そのデータが置かれた位置を示す座標として働きます。似た意味を持つ文章同士は、同じ空間の中でも近い位置に配置されるという考え方です。
埋め込みの種類や作り方については、Embedding(埋め込み表現)とは?意味や種類・LLMやRAGでの必要性・活用事例を紹介で詳しく解説しています。
ベクトル検索は、キーワードが一致するかどうかをチェックしません。検索したい文章もベクトルに変換し、保存済みのベクトルとの距離を計算して、近い順に返します。
この方式なら、「有給休暇の申請方法」という質問に対して、「年次休暇の届出手順」と書かれた文書を返せます。同じ単語が使われていなくても、意味が近ければ結果に含まれるためです。
表記ゆれ・言い換え・略語に強く、質問文をそのまま投げられる点がキーワード検索と大きく異なります。
同じデータベースでも、保存するものと問い合わせ方が異なります。
| リレーショナルデータベース | NoSQL | ベクトルデータベース | |
|---|---|---|---|
| 保存するもの | 行と列の構造化データ | JSONなど柔軟な形式のデータ | 数値の並び(ベクトル)とメタデータ |
| 問い合わせ方 | SQLで条件を指定 | キーやドキュメント単位で取得 | ベクトルを渡して近いものを要求 |
| 返ってくる結果 | 条件に一致した行 | 一致したドキュメント | 近い順に並んだ上位数件 |
| 得意なこと | 集計・整合性の担保 | 大量データの柔軟な格納 | 非構造化データの類似検索 |
使い分けの基準は、結果の返し方です。リレーショナルデータベースは条件に合う行がなければ0件を返しますが、ベクトルデータベースは合致するものがなくても近い順に候補を返します。
無関係な内容が上位に並ぶこともあるため、類似度のスコアで足切りする設計が必要になります。
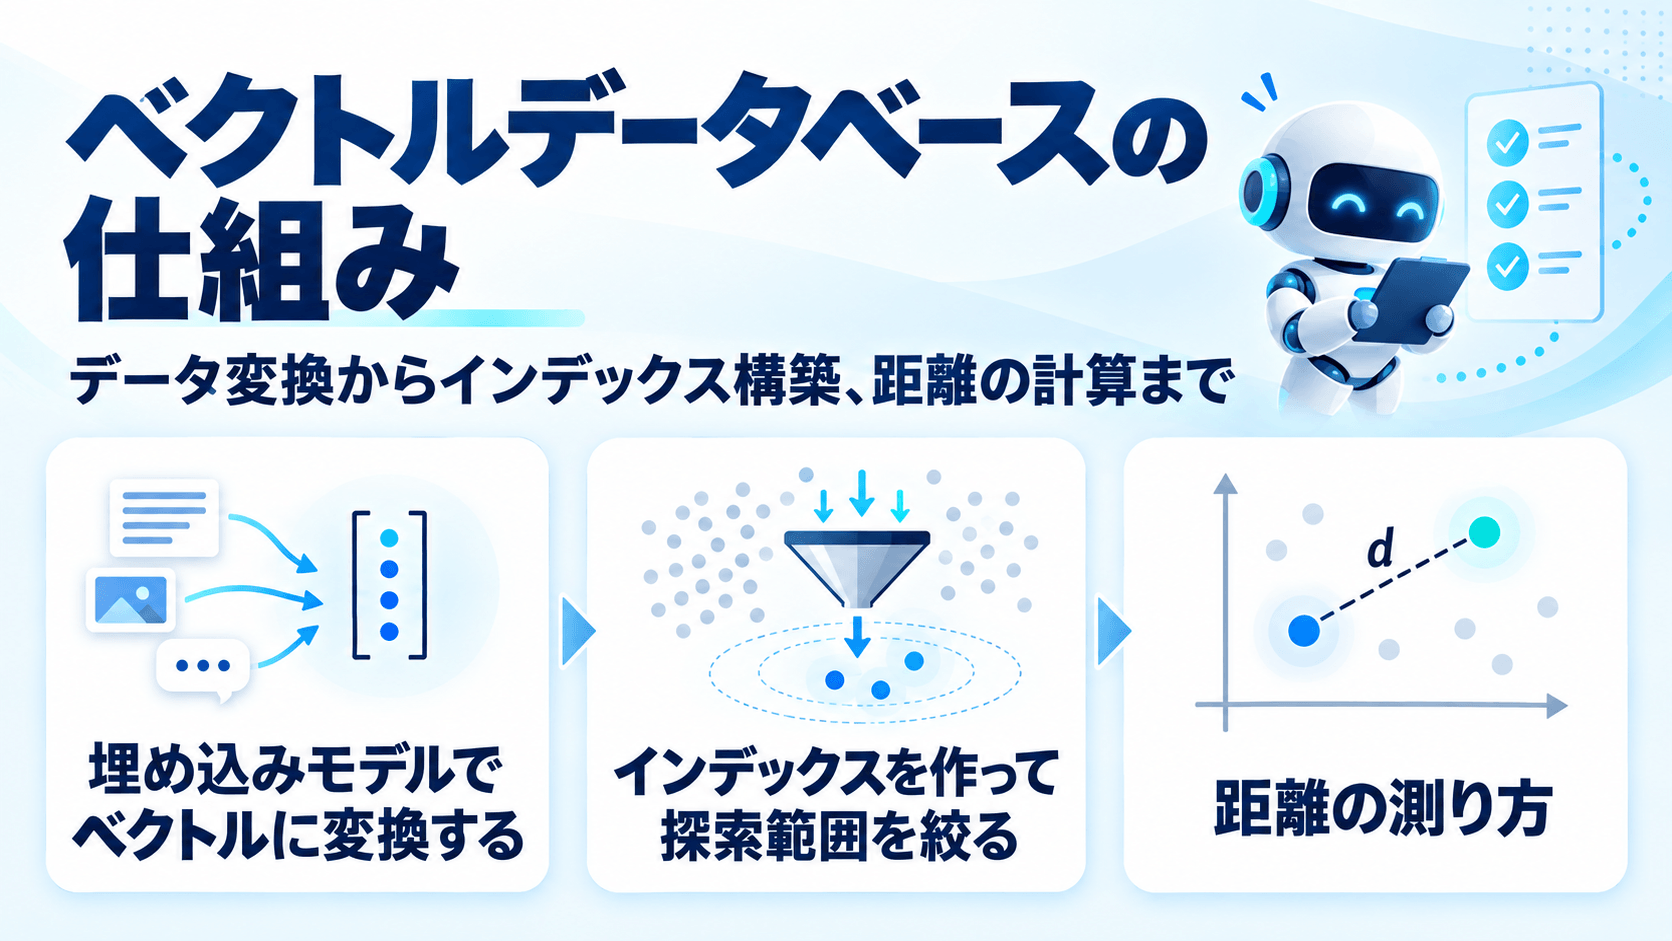
ベクトル検索では、保存するデータと検索するデータを、原則として同じ埋め込み空間に変換する必要があります。一般的には同じ埋め込みモデルを使い、互換性のないモデルで作成したベクトル同士は比較しません。
まずは保存したいデータをベクトルに変換します。文書を丸ごと変換するのではなく、見出しや段落など意味のまとまり(チャンク)に分割してから変換します。
長い文書を1つのベクトルにまとめてしまうと、複数の話題が混ざって特徴が薄まり、検索の精度が落ちます。分割したチャンクは、元の文書名・作成日・部署といったメタデータと組み合わせて保存し、後の絞り込み検索で使えるようにするのが基本です。
保存したベクトルすべてと距離を比較する全件探索では、指定した距離指標における最も近いベクトルを取得できます。ただし件数が増えるほど計算量は膨らみ、応答時間が要件に収まらなくなります。
そこで使われるのが、近似最近傍探索(ANN)と呼ばれる方式です。あらかじめベクトル同士のつながりや、まとまりごとの代表点を作っておき、探索する範囲を絞ることで応答時間を短縮します。
代表的な方式には、ベクトル同士をグラフでつないで近い方向へ移動していくHNSWと、空間を複数の区画に分けて一部だけを調べるIVFです。
注意したいのは、探索範囲を絞る方式が近似である点です。厳密に最も近いものを保証できるのは全件を比較する探索だけで、範囲を絞った分だけ取りこぼしが起きる可能性があります(Faiss公式のインデックス選択ガイド)。
どの程度速度を優先するかは、製品ごとの設定値で調整します。
「近い」をどう測るかにも種類があります。代表的なのは次の3つです。
どれを選ぶかは好みではなく、使う埋め込みモデルに合わせるのが基本です。
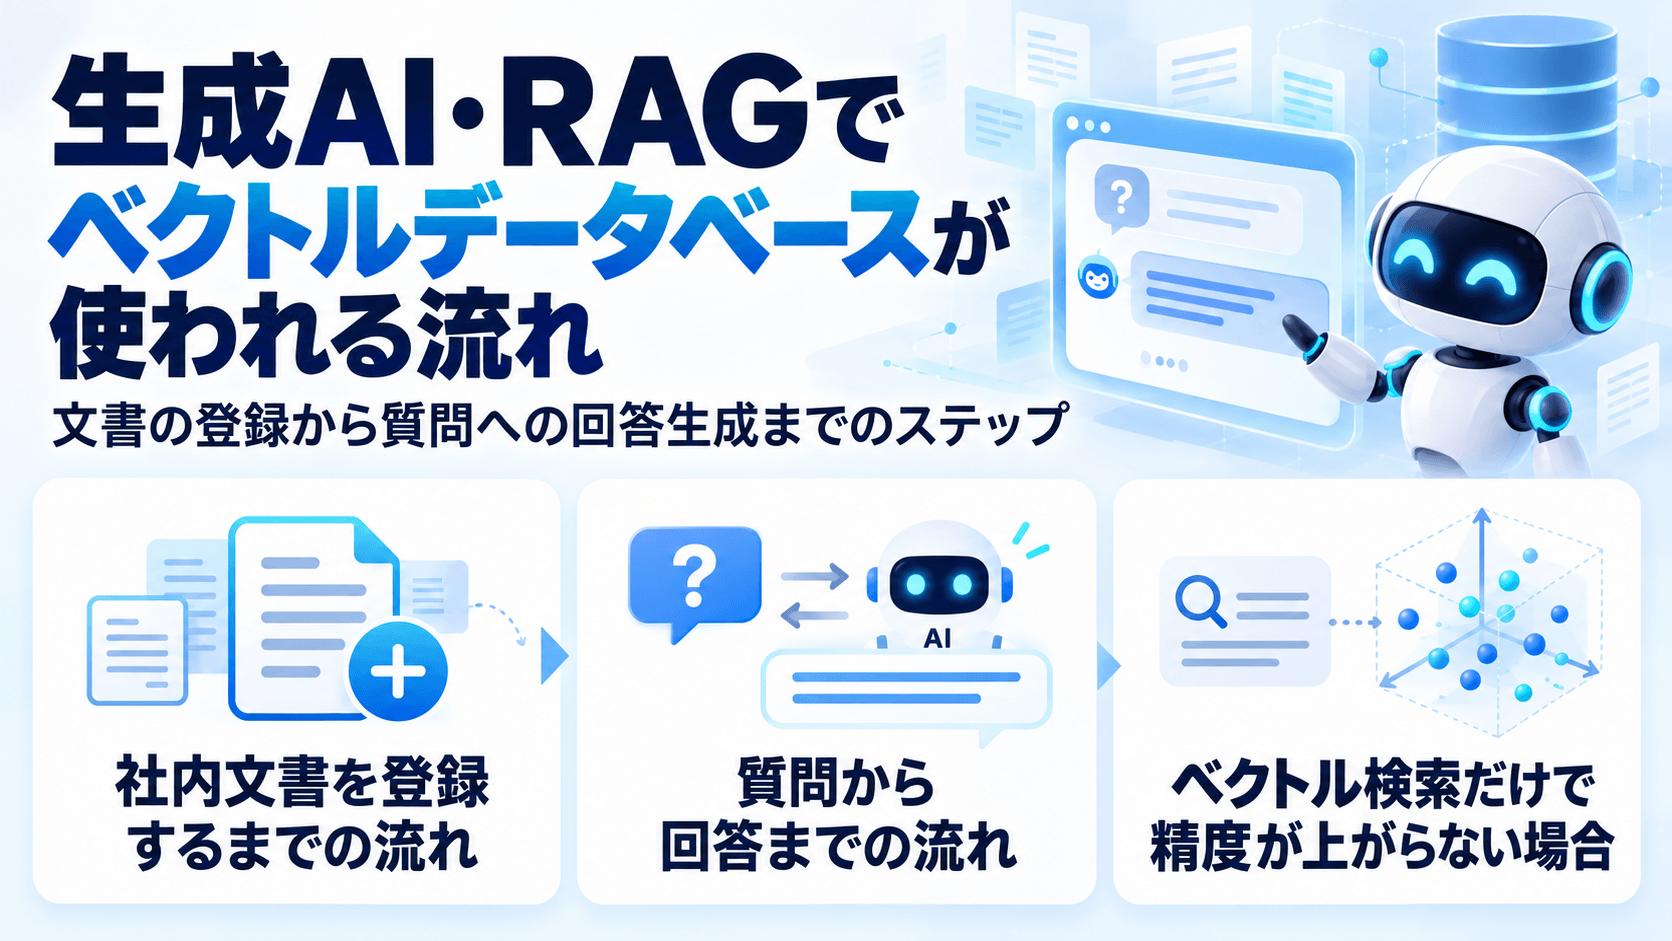
生成AIは、社内限定の文書や最新情報など、モデルが参照できない情報については正確に回答できません。そこで、質問に関連する情報を外部から検索してLLMに渡すRAG(検索拡張生成)が使われます。 その検索を担う手段のひとつがベクトルデータベースです。
RAGは検索と生成の2つの処理を組み合わせた構成で、ベクトルデータベースが関わるのは検索の側だけです。RAG全体の考え方や活用例はRAG(検索拡張生成)とはで解説しています。
RAGを動かす前に、参照させたい文書をベクトルデータベースに登録しておきます。手順は次のとおりです。
PDFやスキャン画像が混ざっている場合は、2の前にテキスト化の工程が加わります。
ここで文字が正しく取り出せていないと、以降の工程がすべて影響を受けます。元データの形式は事前に確認しておきましょう。
登録は一度で終わりではありません。文書が更新・追加されるたびに、該当するチャンクを作り直して入れ替える運用が発生します。
利用者が質問を投げてから回答が返るまで、次の順で処理が進みます。
ベクトルデータベースが関わるのは2までで、回答の文章を作るのはLLMです。検索と生成の分担を押さえておくと、回答がおかしいときの原因を切り分けやすくなります。
参照した文書自体が的外れなら検索側、文書は合っているのに回答内容がずれているなら、プロンプトやLLM側を確認します。
あわせて決めておきたいのが権限管理です。取得したチャンクはそのままLLMに渡されるため、閲覧権限のない文書が検索対象に入っていると、回答を通じて内容が漏洩するおそれがあります。
そのため、部署や役職ごとの絞り込みを、メタデータの検索条件として実装できるかどうかも製品選定の重要なポイントです。
型番・人名・社内の略称のように、意味ではなく文字列そのものが手がかりになる検索では、キーワード検索のほうが適しています。
一方、ベクトル検索は類似度の高い順に候補を返す仕組みです。閾値を設けないと、該当する文書がない質問にも無関係なチャンクが並ぶことがあります。
こうした弱点を補う方法のひとつが、キーワード検索とベクトル検索を組み合わせるハイブリッド検索です。表記ゆれと固有名詞が混在する社内文書では、両方を組み合わせる構成も有力な選択肢です。
自社に合うRAG製品を探す段階であれば、RAG関連のAI製品の比較・資料請求から複数社の資料をまとめて取り寄せられます。80製品以上を掲載したRAGソリューションカオスマップも、全体像の把握に使えます。
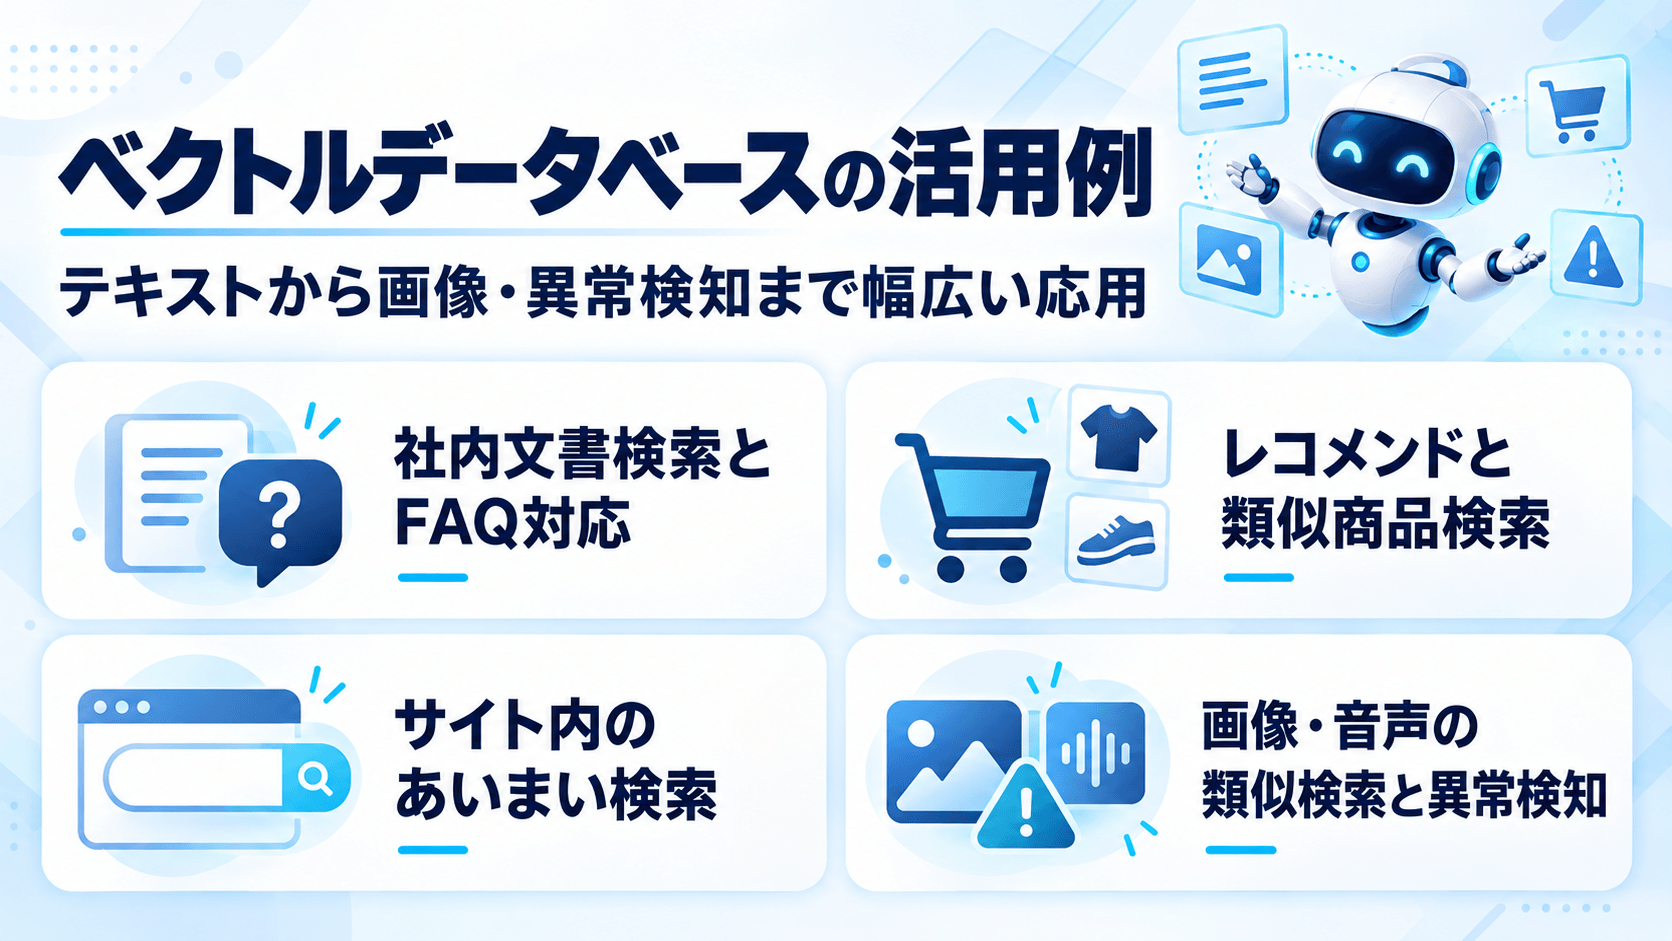
ベクトルデータベースが適しているのは、正解が一意に決まらず、近いものを候補として出したい処理です。用途は生成AIに限らず、社内の検索から推薦・異常検知まで広がります。
問い合わせ対応の担当者が、過去の対応履歴やマニュアルから該当箇所を探す用途です。質問に使う言葉と、文書に書かれた言葉がそろわない場面が起きるため、意味で探す方式が向いています。
社内向けのチャットボットとして提供する場合は、RAGの構成をそのまま使います。回答を生成せず、該当する文書へのリンクを返す形にすれば、生成AI特有の誤りを避けながら検索精度だけを改善することも可能です。
閲覧中の商品に近いものを並べる推薦は、ベクトル検索が早くから使われてきた分野です。
ZOZOは、ファッションコーディネートアプリ「WEAR」の関連コーディネート枠で、Google CloudのVertex AI Vector Searchを採用しています。
扱うのは約1,400万件・256次元のベクトルで、同社の試算では月額およそ1,380米ドルです(2025年7月時点の価格・レプリカ数2の前提)。
同社は技術ブログでAlloyDB for PostgreSQLとの比較検討を経て、インデックスの実装・運用・保守の手間を減らせる点を評価して選定したと説明しています。
利用者が入力した言葉と、サイト側で使っている言葉が違っていても結果を返せるようにする用途です。
ポイントサイト「ハピタス」を運営するオズビジョンは、検索ワードの意味を解釈するセマンティックサーチに、Amazon Aurora PostgreSQLとpgvectorを組み合わせた構成を採用しました。
広告データと検索ワードのベクトル化にはAmazon Bedrockを使っています(AWS Japan公式ブログ)。すでに運用しているデータベースを拡張する形で導入した例です。
検索の考え方についてはセマンティック検索とはのページも参考になります。
画像を特徴ベクトルに変換して保存すれば、類似する画像を探せます。製造業の外観検査で過去の不良品画像と照合したり、動画・音源の重複を検出したりする用途が代表例です。
異常検知では、正常時のデータをベクトルとして蓄積しておき、新しいデータがそこから離れているかを判定します。不正取引の検出や、設備の稼働データの監視が代表的な適用先です。
ベクトルデータベースへの注目が高まった2023年前後は、専用に作られた製品の名前が中心に挙がっていました。
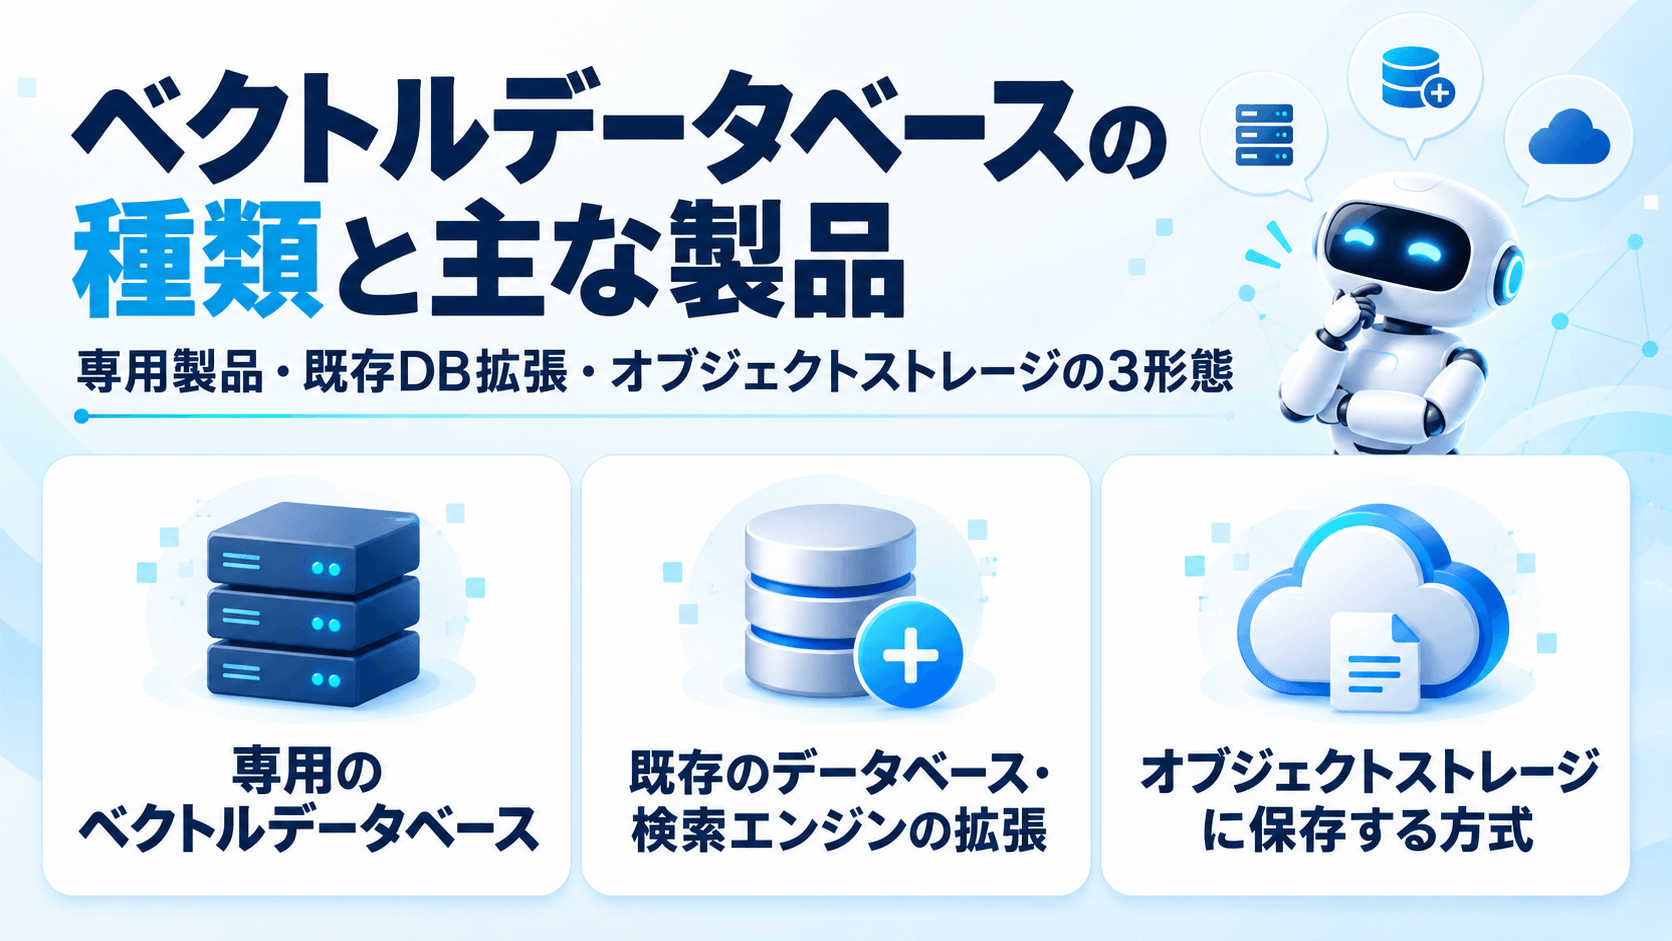
その後、既存のデータベースや検索エンジンがベクトル検索の機能を強化し、さらにオブジェクトストレージに保存する方式も加わっています。現在の選択肢は、専用製品・既存システムの拡張・オブジェクトストレージの3つの形態に分かれます。
ベクトルの保存と検索のために設計された製品です。件数が増えたときの分散処理や、選べるインデックスの種類の多さで有利になります。
| 製品 | 提供形態・ライセンス | 無料で試せる枠 |
|---|---|---|
| Pinecone | マネージドのみ(OSS版なし) | Starterプランで2GB・インデックス5個まで |
| Qdrant | Apache 2.0のOSSとクラウド | クラウド版にあり(カード登録不要) |
| Milvus / Zilliz Cloud | Apache 2.0のOSSとクラウド | クラウド版にあり |
| Weaviate | BSD-3-ClauseのOSSとクラウド | 1クラスタ・10万オブジェクトまで |
| Chroma | Apache 2.0のOSSとクラウド | 自己ホストは無償 |
分かれ目になるのは、自社で構築するか外注するかです。
PineconeはOSS版を持たないため運用を任せる前提になり、MilvusやQdrantは自社構築とマネージドのどちらも選べます。Chromaはローカルでも動く構成があり、手元での検証から始められます。
なお、FaissやAnnoyをベクトルデータベースとして紹介している記事がありますが、これらはライブラリです。
Faissの公式リポジトリも「類似検索とクラスタリングのためのライブラリ」と説明しています。
インデックスをファイルに保存する機能はありますが、データベースとしての更新管理やAPIサーバーを備えた製品ではありません(Faiss公式リポジトリ)。
検証段階はライブラリで進め、本番でデータベースへ移す構成も選べます。
現在使用しているデータベースや検索エンジンに、ベクトル検索の機能を追加する方法です。データの保管場所が増えず、既存の権限管理やバックアップの仕組みをそのまま使えます。
代表的なのがPostgreSQLの拡張機能である「pgvector」です。PostgreSQL 13以降に対応し、HNSWとIVFFlatのインデックスを利用できます(pgvector公式リポジトリ)。
Amazon Aurora PostgreSQLでも利用でき、Google CloudのAlloyDBはpgvectorを拡張した独自の拡張機能を提供しています。
検索エンジンではElasticsearchとOpenSearchが、キーワード検索とベクトル検索を組み合わせて統合するハイブリッド検索に対応しています(Elastic公式ドキュメント)。
Azure AI Searchもベクトル検索とハイブリッド検索に対応するサービスのひとつです。ベクトル検索機能自体は、全リージョン・全価格帯で追加料金なしに利用できます(Microsoft Learn)。
2025年12月に一般提供が始まったAmazon S3 Vectorsは、S3のバケットにベクトルを保存して問い合わせる方式です。1つのインデックスに最大20億件のベクトルを格納でき、AWSは専用のベクトルデータベースと比べて、アップロード・保存・クエリの総コストを最大90%削減できると説明しています(AWS公式)。
一方で応答時間は、頻繁に実行されるクエリで100ミリ秒程度かそれ以下、まれなクエリでは1秒未満とされており、専用製品より長くかかります(AWS公式ドキュメント)。
AWSは、高い検索性能が必要な場合にAmazon OpenSearch Serviceとの連携を案内しています。大量のベクトルを低コストで保持したい用途に向く方式です。
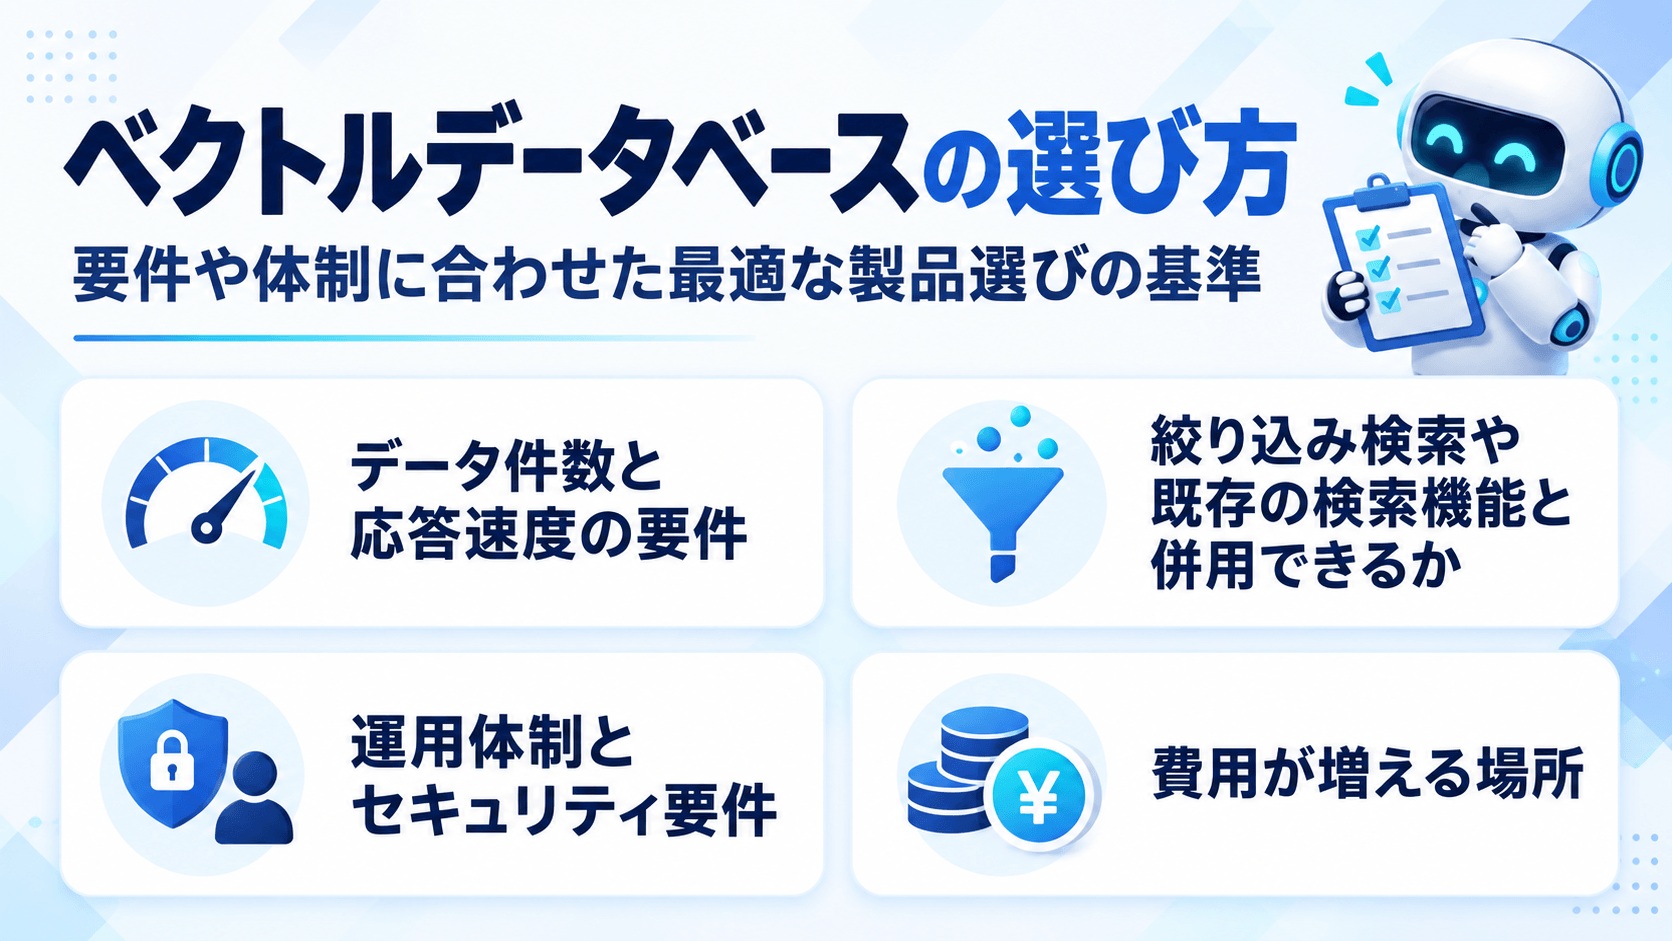
3つの形態に優劣はなく、どれが合うかは要件で決まります。
保存するベクトルの件数と、検索に許容できる待ち時間を先に決めます。数十万件程度で、社内向けに数百ミリ秒の応答が許されるなら、既存のPostgreSQLを拡張する構成が候補です。
実際に足りるかどうかは、次元数・検索の頻度・絞り込みの条件で変わります。
件数がさらに増える場合や、利用者を待たせずに結果を返す必要がある場面では、専用製品の分散構成も検討対象になるでしょう。逆に、参照頻度が低く保存量が多いデータであれば、オブジェクトストレージ方式でコストを抑えられます。
部署・年度・文書種別といった条件で絞り込みながらベクトル検索を実行できるかは、実際の使い勝手を左右するポイントです。
閲覧権限による出し分けも、メタデータでの絞り込みができるかどうかにかかっています。
キーワード検索も併用するのか、要件定義の段階で決めておきます。
すでにElasticsearchやOpenSearchでキーワード検索を運用しているなら、ベクトル検索を追加する構成が手軽です。
OSSを自社で構築すればライセンス費用は抑えられますが、バージョン更新・障害対応・スケール調整を自社で引き受けることになります。運用を担える人員がいなければ、マネージドサービスを選ぶほうが現実的です。
セキュリティ面では、保管するリージョンを指定できるか、役割ごとのアクセス制御と監査ログに対応しているかを確認します。社内の情報管理の基準に照らして、満たせない項目がないかを先に洗い出しておきましょう。
料金の考え方は製品ごとに異なります。課金の基準になるのは、おおむね次のいずれかです。
PoCの段階では無料枠に収まっていても、本番で件数と検索回数が増えると費用の構造が変わります。試算するときは、保存量だけでなく、更新の頻度とインデックスの再作成にかかる分まで含めておきましょう。
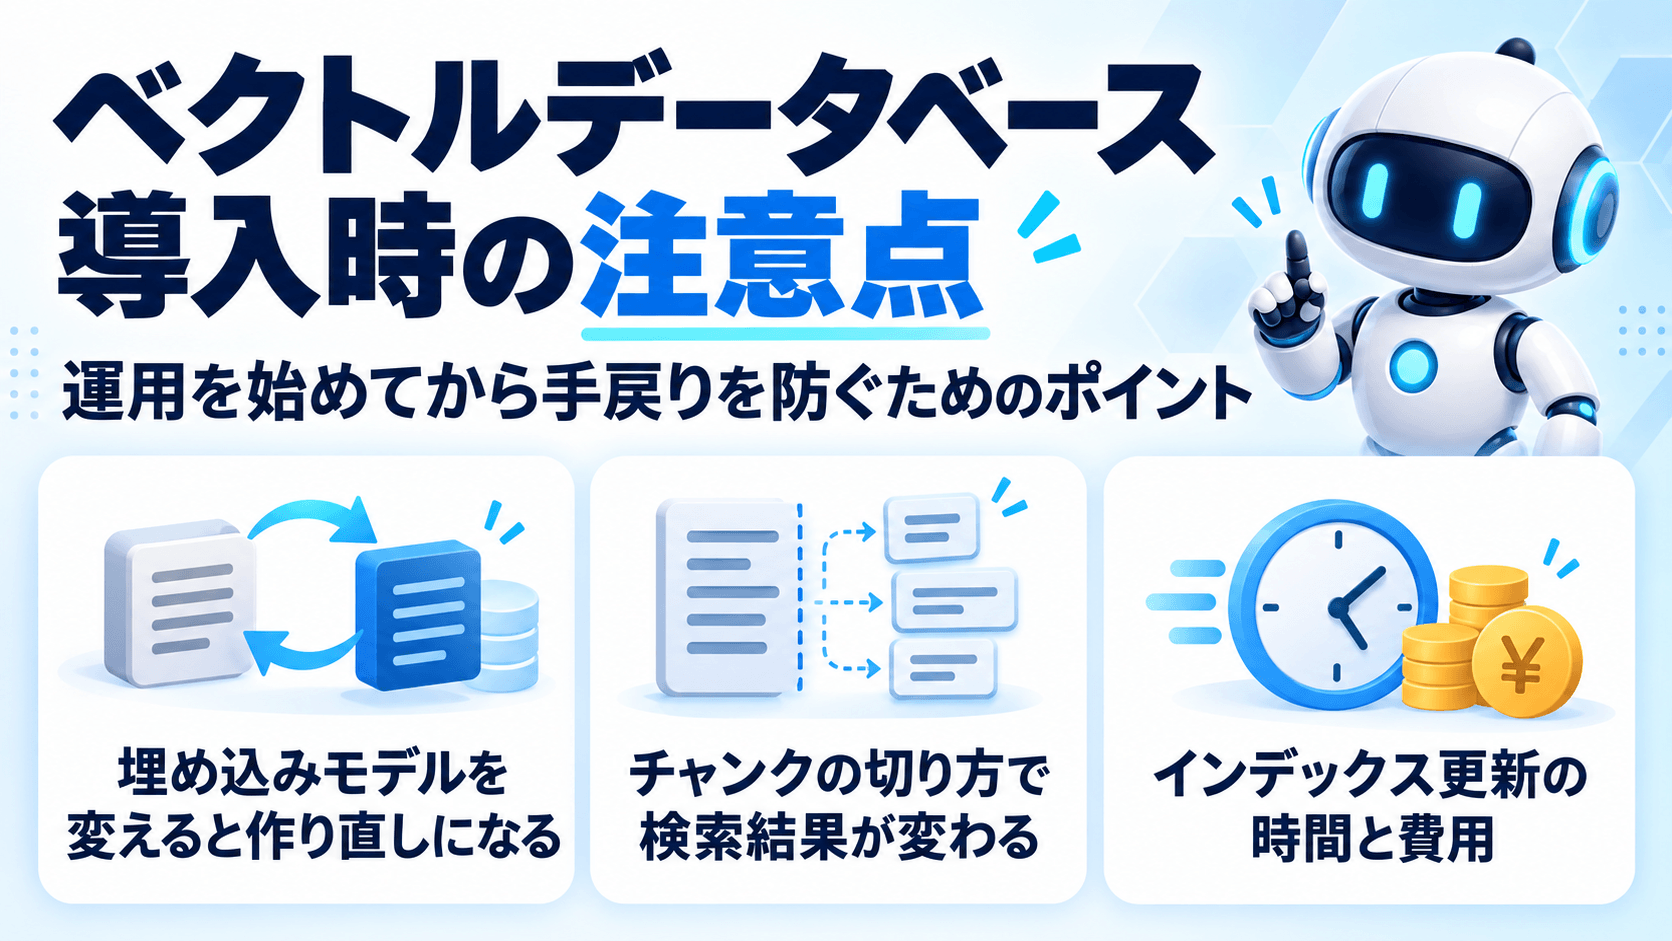
ベクトルデータベースは、検証環境では問題なく動いても、運用を始めてから手戻りが出るケースが多いです。手戻りの多くは、保存済みのデータを作り直す作業に関係します。
埋め込みモデルを別のものに変更すると、保存済みのベクトルはそのまま使えません。モデルごとに次元数も座標の意味も異なるため、全データを変換し直す必要があります。
モデルの提供終了や後継モデルへの移行は起こり得るため、再作成にかかる時間と費用を導入前に確認しておきましょう。
文書をどの単位で分割するかは、検索の精度に直接影響します。細かく切りすぎると前後の文脈が失われ、大きく切りすぎると1つのベクトルに複数の話題が混ざってしまいます。
見出し・条項・段落のような文書構造に沿って分割すると、意味のまとまりを保ちやすくなります。分割方法を変えた場合も、該当データの作り直しが必要です。
ベクトルを追加・更新するたびに、インデックスの更新が発生します。件数が多いほど更新の処理は重くなり、時間と費用が運用の負担になります。
前述のZOZOも、運用のなかでインデックス更新の時間が延び、更新費用が増加する問題に直面しました。その後、更新対象のデータを減らして対応したことを公開しています。どの頻度で何件を更新するのかを、設計の段階で見積もっておきましょう。
ベクトルデータベースは、データを数値のベクトルに変換し、意味の近いものを近い順に返すデータベースです。RAGでは、質問に関係する社内文書を取り出す部分を担います。
選択肢は、専用製品・既存のデータベースや検索エンジンの拡張・オブジェクトストレージの3つに分かれており、どれが適しているかは、データ件数と応答速度の要件、既存システムとの関係、運用体制で決まります。
まずは無料枠のある製品で検証し、件数と更新頻度の見通しが立った段階で本番の構成を決めると、過剰な投資を避けやすくなるでしょう。
構成の検討と並行して製品も見ておきたい場合は、RAG関連のAI製品一覧から各社のサービス内容を確認できます。
アイスマイリーでは、生成AIのサービス比較と企業一覧を無料配布しています。課題や目的に応じたサービスを比較検討できますので、ぜひこの機会にお問い合わせください。
あります。Milvus・Qdrant・Weaviate・ChromaはOSSとして公開されており、自社のサーバーで動かす分にはライセンス費用がかかりません。 pgvectorも、PostgreSQLの拡張機能として無償で利用できます。 クラウドのマネージドサービスにも、Pinecone・Qdrant・Weaviateなどが無料枠を用意しています。ただし容量や件数などに上限があるため、検証したいデータ量が収まるかを事前に確認しておきましょう。
専用製品として名前が挙がるのは、Pinecone・Milvus・Qdrant・Weaviate・Chromaです。 既存のシステムを拡張する形では、PostgreSQLのpgvectorとElasticsearch・OpenSearchが使われています。 日本国内でも、クラウド各社のマネージドサービスを採用した導入事例が公開されています。専用製品を自社で構築する前に、すでに使っているクラウドの機能で試せないかを確認しておくと候補を絞りやすいでしょう。
必須ではありません。参照する文書が数十件程度であれば、ライブラリでベクトルを保持し、総当たりで比較する構成でも動きます。 専用の仕組みが要るのは、件数が増えて総当たりでは応答が間に合わなくなったとき、更新の頻度が高く作り直しの手間が無視できなくなったとき、複数のシステムから同じベクトルを参照したいときです。PoCの段階から大規模な構成を選ぶ必要はありません。
セマンティック検索は「意味を理解して検索する」という考え方を指します。一方、ベクトル検索はそれを実現する手法のひとつです。同義語辞書や自然言語処理を使った方式もセマンティック検索に含まれます。 現在は埋め込みモデルとベクトル検索を組み合わせた実装も多いため、両者が近い意味で使われる場面もありますが、厳密には指している箇所が異なります。
業務の課題解決に繋がる最新DX・情報をお届けいたします。
メールマガジンの配信をご希望の方は、下記フォームよりご登録ください。登録無料です。


FOLLOW US
SNSをフォローして、最新情報をチェックできます!


AI製品・ソリューションの掲載を
希望される企業様はこちら