


生成AI
最終更新日:2026/10/09
「AIエージェントを導入したのに、結局自分がプロンプトを打ち続けている……」
エージェントの処理がいくら高速でも、人間が「次の指示」を出すボトルネックになっていては、真の自動化とは言えません。
2026年、この“プロンプト疲れ”を解決する新常識として「ループエンジニアリング(Loop Engineering)」が世界的な注目を集めました。これは、人間が都度指示を出すのではなく、AI自身が「観察→判断→実行→検証」を反復するシステムそのものを設計する手法です。
本記事では、AI任せによる「無限ループやコスト爆発の落とし穴」を回避し、安全かつ自律的に開発を回すための設計手法と導入ステップを体系的に解説します。
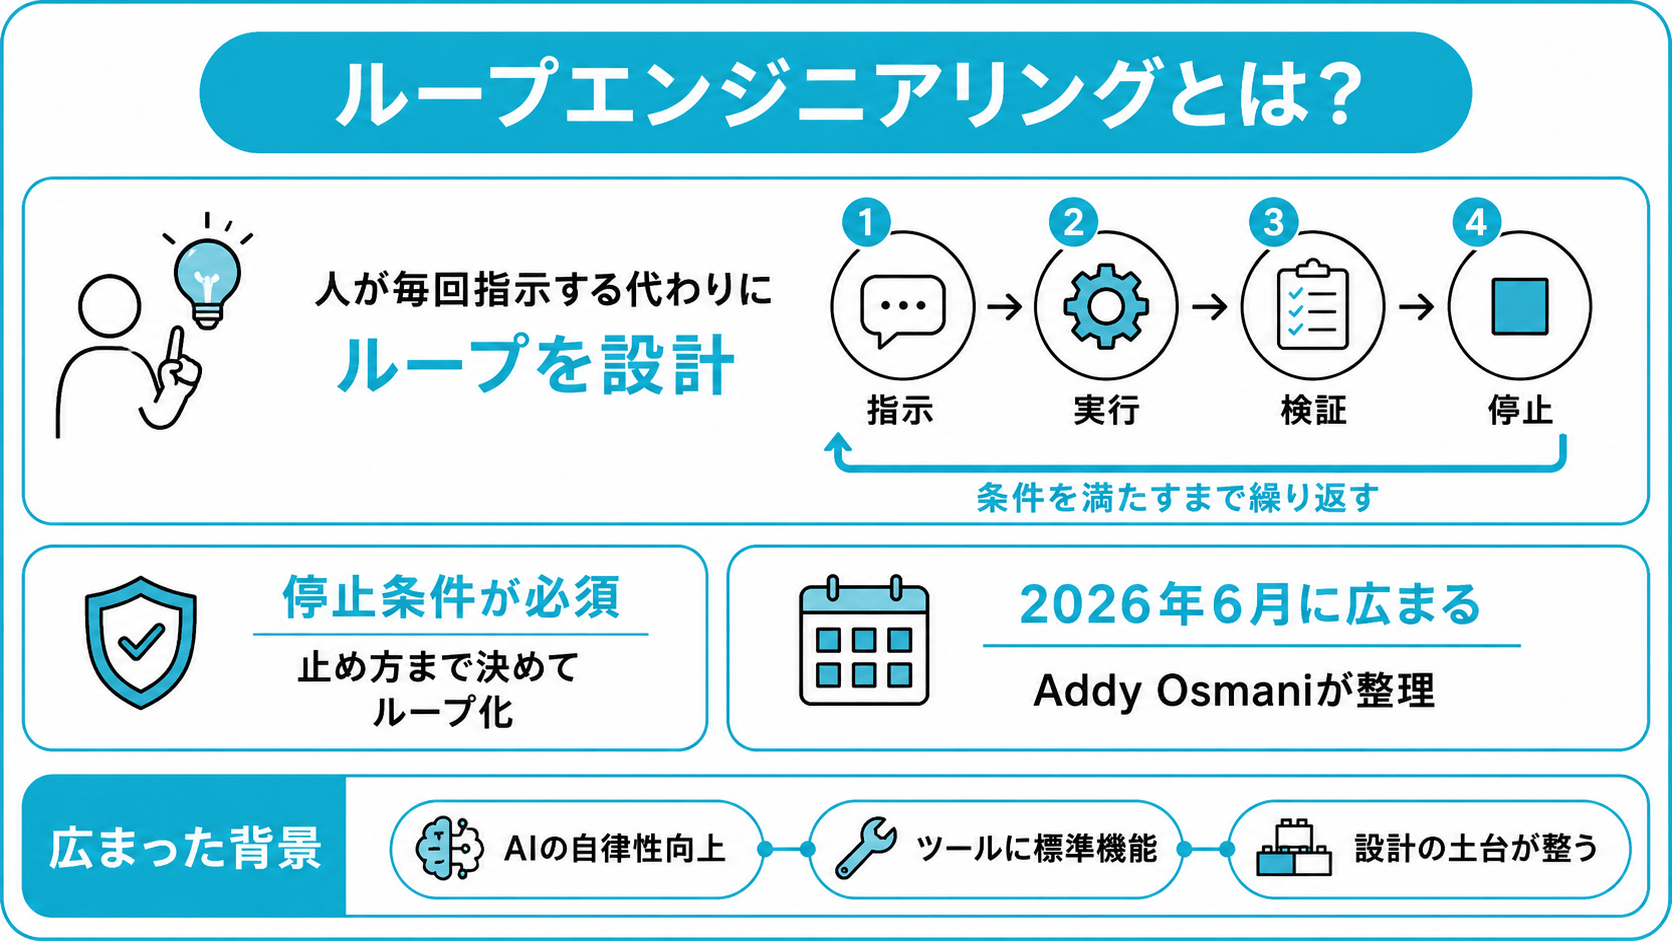
ループエンジニアリングとは、AIエージェント(指示を受けて調査・実装・検証まで自律的に進めるAIツール)に人間が毎回プロンプトを打つのをやめ、「指示出し→結果検証→次の行動を決める」ループそのものを設計する考え方です。
この言葉は特定の企業が発表した用語ではなく、2026年6月に複数の開発者の発言が重なったことで広まりました。ひとつは、自律型エージェント「OpenClaw」の作者として知られるPeter Steinberger氏がXに投じた次の一文です。
You shouldn’t be prompting coding agents anymore. You should be designing loops that prompt your agents.
(もうコーディングエージェントにプロンプトを打つべきではない。エージェントにプロンプトを出すループを設計すべきだ)
ほぼ同時期に、AnthropicでClaude Codeの開発を率いるBoris Cherny氏が「私はもうClaudeにプロンプトを出していない。ループが走っていて、そのループがClaudeにプロンプトを出し、何をすべきかを判断している。私の仕事はループを書くことだ」と語りました。
こうした発言が出る中、Google Cloud AIのディレクターを務めるAddy Osmani氏は2026年6月7日、「Loop Engineering」と題した記事を公開し、この考え方を整理しました。
Osmani氏は記事の冒頭で、次のように定義しています。
Loop engineering is replacing yourself as the person who prompts the agent. You design the system that does it instead.(ループエンジニアリングとは、エージェントにプロンプトを打つ人としての自分自身を置き換えることだ。代わりにそれを行うシステムを、あなたが設計する)
同氏はループを「再帰的なゴール(recursive goal)」とも表現しています。人間が目的をひとつ定義すれば、完了までAIが反復するという意味です。
【参考】Loop Engineering|AddyOsmani.com
AIに作業をさせ続けるという発想自体は新しくありません。2026年になって現実的な手法として注目されるようになった背景は、次の3つです。
1つの指示に対して複数の手順を自分で判断して進められるようになり、人間が逐一補足しなくても作業が前に進むようになりました。
Osmani氏は「1年前ならループを組むには自分で大量のシェルスクリプトを書き、それを永遠に保守する必要があった。今は部品が製品の中に入っている」と述べています。
プロンプト・コンテキスト・ハーネスという3つの考え方が広まり、AIに何を渡すか、どんな環境で動かすかがある程度まで固まりました。そこから、人間が毎回操作しなくてもよいという発想につながりました。
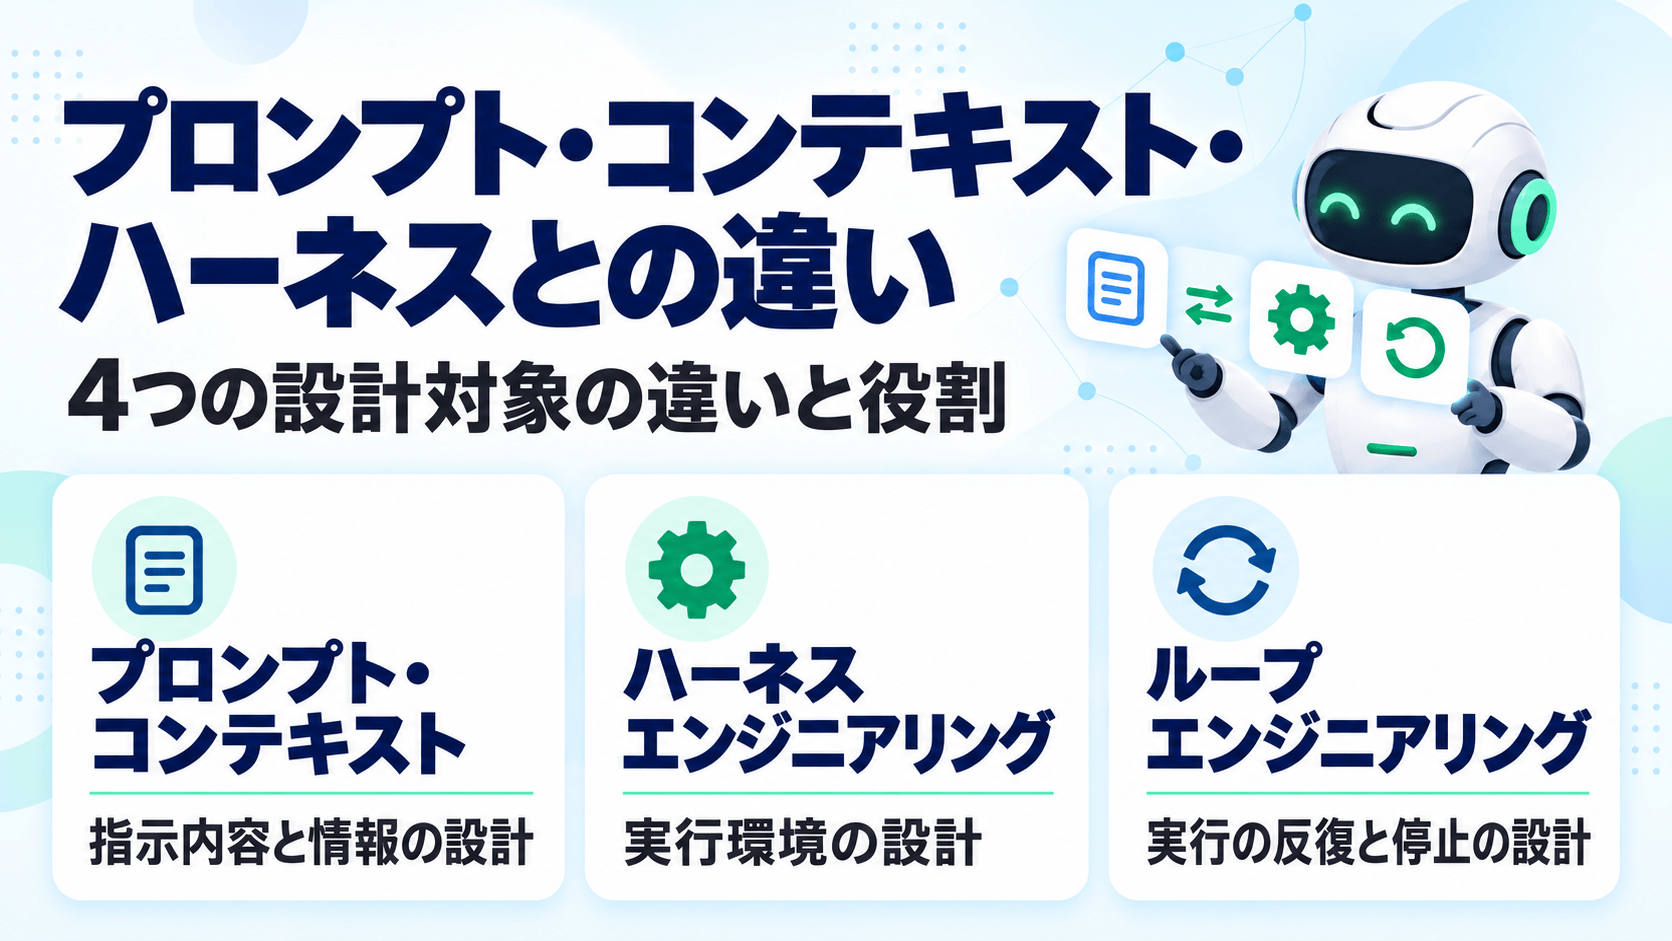
ループエンジニアリングを含むこれら4つの手法は、何を設計対象にするかで分かれています。
| 設計対象 | 何を設計するか | 答える問い | 不足したときに出る症状 |
|---|---|---|---|
| プロンプトエンジニアリング | AIモデルに送る指示の内容と構造 | 何をしてほしいか | 意図と違う出力が返る |
| コンテキストエンジニアリング | AIモデルに見せる情報全体 | 何を読ませ、何を読ませないか | 古い情報や無関係な情報が混ざる |
| ハーネスエンジニアリング | エージェントが動く環境・制約・ツール・検証 | どこまで、どう安全に実行させるか | 権限が過剰、未検証の出力が外に出る |
| ループエンジニアリング | 実行・検証・修正・停止の反復 | いつまで、何回繰り返すか | 同じ失敗を繰り返す、人が介入し続ける |
これらの4つの手法は、AIに任せる範囲が広がるにつれて順次必要となる「段階的な設計」と考えられます。各手法は独立しているわけではなく、互いに補完し合う関係にあります。
4つの中で混同されやすいのが、ハーネスエンジニアリングとの違いです。
ハーネスとは、AIモデル以外のすべての要素です。使えるツール・与える制約・フィードバックの仕組み・検証のゲートなどが含まれます。
「エージェント=AIモデル+ハーネス」と表現されることもあり、同じAIモデルでもハーネスの設計次第で結果が変わるという知見から注目されました。
これに対してループエンジニアリングは、ハーネスを備えたエージェントの実行を外側から繰り返し制御する仕組みを設計します。いつ実行を始めるか、どの条件で継続するか、成果物をどう検証するか、いつ止めるかを決める役割です。
| 項目 | ハーネスエンジニアリング | ループエンジニアリング |
|---|---|---|
| 設計するもの | エージェント1回分の実行環境 | 実行を繰り返し起動して検証する仕組み |
| 関係 | エージェントの実行環境を整える | そのエージェントの実行を外側から繰り返し制御する |
| 主な設計対象 | ツール・権限・制約・検証環境 | 実行の開始・継続・検証・停止 |
| 主な関心 | 1回の実行をどう制御するか | 実行をどの条件で繰り返し、いつ止めるか |
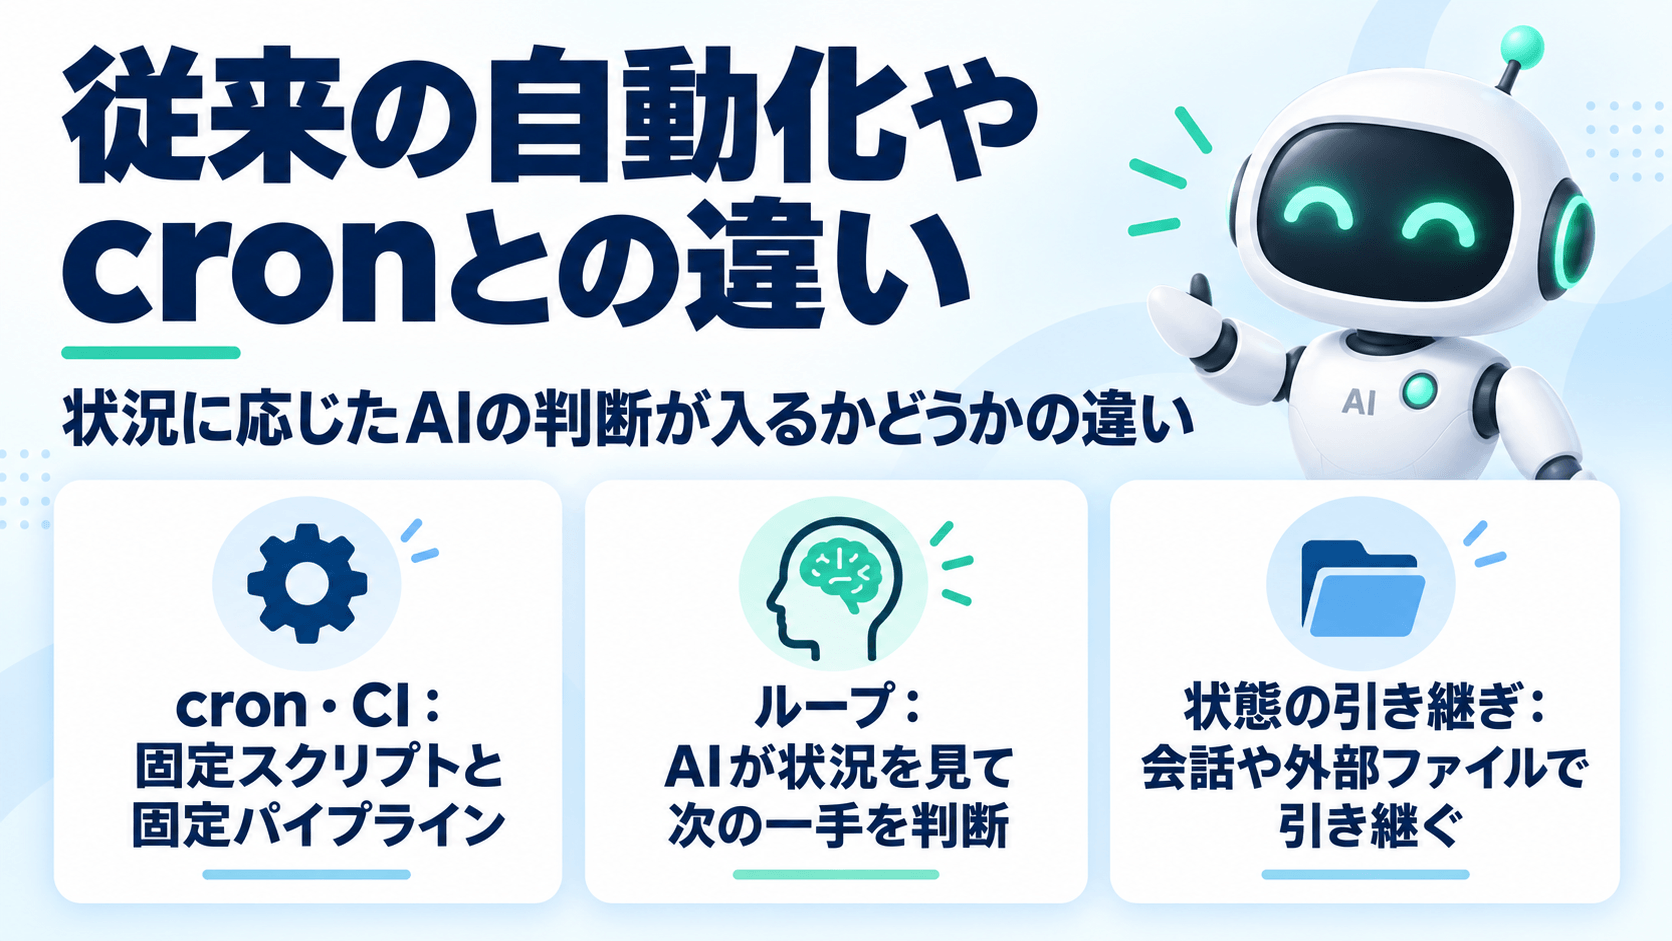
決まった時間に処理を自動実行するだけなら、cron(決まったスケジュールでプログラムを実行するUNIXの仕組み)やCI(継続的インテグレーション:コードの変更のたびにテストやビルドを自動実行する仕組み)で以前から可能でした。
cronのジョブは、周囲の状況がどうであれ、人間があらかじめ書いた同じスクリプトを毎回実行します。実行のタイミングは自動でも、処理の中身は固定です。想定外の事態が起きれば失敗して終わり、対応するのは人間です。
一方ループは、その瞬間の状況を見てAIが次の一手を選びます。判断するのは人間が書いた条件分岐ではなく、AIモデル自身です。そして結果を検証し、状態を次のループへ引き継ぎます。
cronが「トリガー→固定処理→完了」という一方向の流れであるのに対し、ループは「観察→判断→実行→検証→判定」というサイクルです。
| 項目 | 手動でプロンプト | ループ | cron | CI(GitHub Actionsなど) |
|---|---|---|---|---|
| 処理の中身 | 人間がその都度決める | AIが状況を見て判断 | 固定スクリプト | 固定パイプライン |
| 状態の引き継ぎ | 人間の記憶と会話履歴 | 会話や外部ファイル等で引き継ぐ | 処理側で実装すれば可能 | 成果物・キャッシュ・外部ストレージ等で実装可能 |
| 向くタスク | 探索・方針の検討 | 状況が変わる継続作業 | 定型作業(バックアップ等) | 信頼性が要るパイプライン |
| 停止の判断 | 人間の主観 | 検証の合格・上限・異常検知 | 実行した処理の終了条件 | ジョブの成功・失敗・キャンセルなど |
| 主なリスク | 人間がボトルネック化 | コストの膨張・脱線 | 状況変化に対応できない | 設定の複雑化 |
判断が要らない機械的な作業まで、無理にループ化する必要はありません。毎回同じ処理で済むならcronやCIで十分です。状況に応じた判断が入る作業だけをループに載せます。
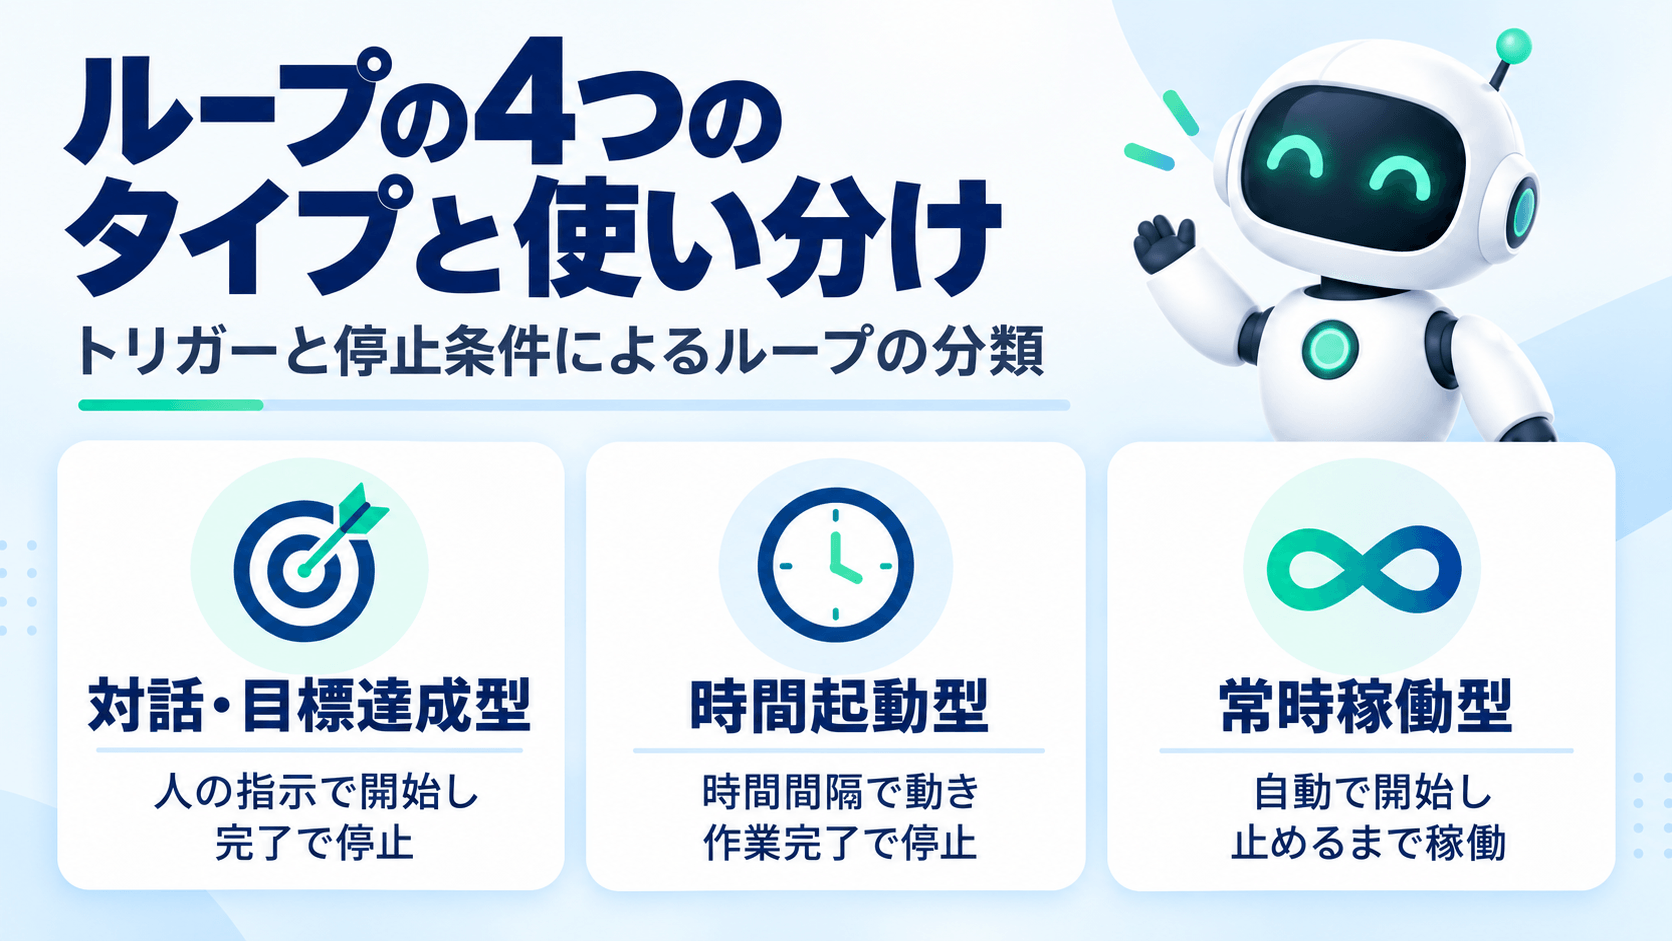
ループと一口に言っても、回り方はひとつではありません。何をきっかけに動き出し、何をもって止まるかで、設計する項目も変わります。
Claude Codeの開発チームは、トリガー・停止条件・向くタスクの3点でループを4つに分類しています。
| タイプ | トリガー | 停止条件 | 向くタスク |
|---|---|---|---|
| 対話型 | 人間のプロンプト | AIが完了または追加情報が必要と判断 | 定常的でない短めの作業 |
| 目標達成型 | 人間のプロンプト | 目標の達成、または上限ターン数への到達 | 検証可能な完了条件があるもの |
| 時間起動型 | 指定した時間間隔 | 人間が止めるか、作業自体が終わる | 繰り返しの作業、外部システムの監視 |
| 常時稼働型 | イベントまたはスケジュール(人が介在しない) | 各タスクは目標達成で終了、仕組み自体は止めるまで稼働 | バグ報告の仕分け、依存関係の更新など |
このうち対話型は、手動で行っているやり取りです。新たに設計するのは目標達成型と時間起動型で、常時稼働型はこの2つを組み合わせて人の関与を外した形にあたります。
すべての作業に複雑なループが要るわけではありません。単純な形から始めて、必要な場面だけこれらのパターンを使い分けます。
目標達成型は、成果で止まるループです。
何をもって完了とするかを人間が定義し、AIが停止しようとするたびに、評価用の別AIモデルが停止条件を満たしているか判定します。
満たしていなければ作業に戻す仕組みで、コードを書いたAIモデル自身に完了判定をさせない点が特徴です。
Claude Codeでは /goal がこれにあたり、公式ブログでは次のような指定例が挙げられています。
/goal get the homepage Lighthouse score to 90 or above, stop after 5 tries.

(トップページのLighthouseスコアを90以上にする。5回試したら停止する)
時間起動型は、成果ではなく時間で動くループです。
作業内容は同じで入力だけが変わるもの、あるいは外部システムの変化に反応したいものに向きます。Claude Codeでは /loop が一定間隔でプロンプトを再実行します。
/loop 5m check my PR, address review comments, and fix failing CI

(5分ごとにPRを確認し、レビューコメントに対応し、失敗したCIを直す)
時間起動型を選ぶとき、あわせて決めるのがどこで動かすかです。
/loop は開いているClaude Codeセッション内で動作するため、PCとセッションを維持する必要があります。端末を閉じても継続させたい場合は、クラウド上で動作するRoutinesを利用します。
CLIからは/schedule を使ってScheduled Routineを設定できます。
同じセッションの中で繰り返すのか、実行のたびに新しいセッションを再起動するのか。この違いは、長時間走らせたときの挙動にも影響します。
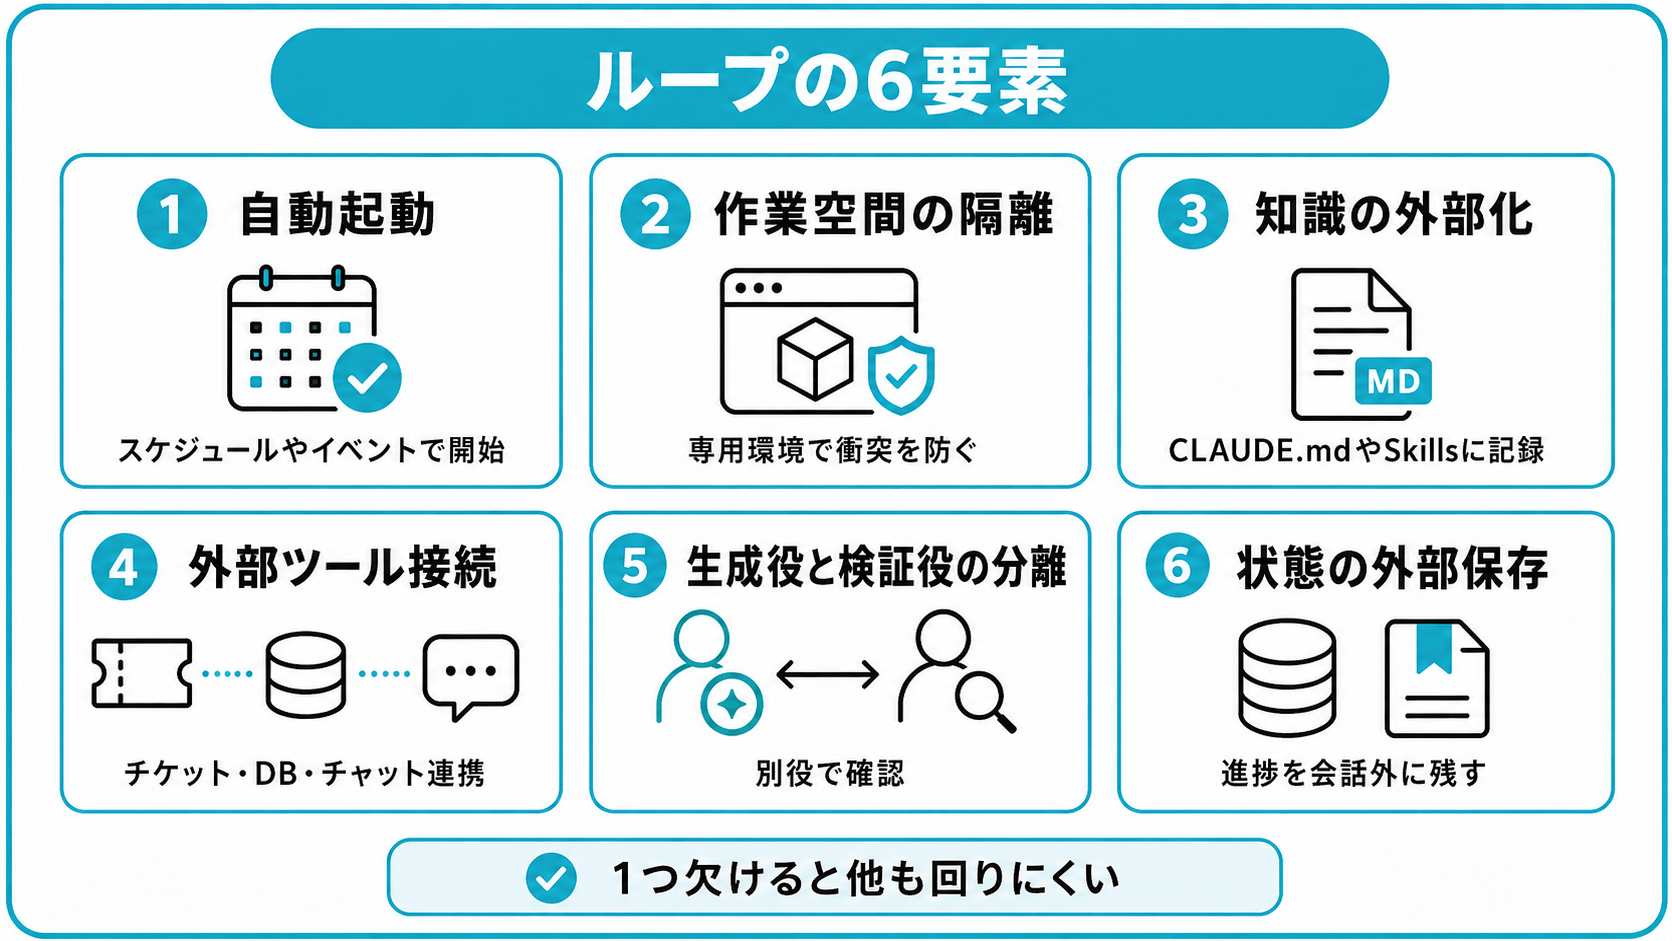
いずれもClaude CodeとOpenAI Codexの双方に対応する機能があり、特定のツールでしか組めないものではありません。
スケジュールやイベントをきっかけにエージェントを起動する仕掛けです。定期的に課題を洗い出して優先度を付け、対応が必要なものだけを人間に届けます。
一度きりの実行をループに変えるのがこの部品で、これがなければ人間が手で起動する運用に戻ります。
複数のエージェントを同時に動かすと、同じファイルを編集して衝突します。
git worktree(1つのリポジトリから独立した作業ディレクトリを複数切り出すGitの機能)を使い、エージェントごとに専用の作業場所を割り当てることで衝突を防ぎます。
ただし防げるのはファイルの衝突までで、並列数を増やすほど速くなるわけではありません。出てきた成果物をレビューする人間の処理能力が上限になります。
エージェントがプロジェクト固有の命名規則やビルド手順を参照できるよう、それらを会話の外に記録しておきます。Claude Codeでは常時参照する情報をCLAUDE.mdに、繰り返し使う作業手順をSKILL.mdを含むSkillsに分けて管理できます。
ルートのCLAUDE.mdはセッション開始時に読み込まれ、コンテキストの圧縮後にも再読み込みされます。一方、Skillsは必要になったときに呼び出される仕組みです。用途を分けることで、プロジェクトの前提や手順を毎回プロンプトで説明する必要を減らせます。
【参考】OpenAI Codexのスキル機能/Claude Codeのスキル機能
ファイルやローカル環境だけを扱うループでは、課題管理ツールやデータベース、チャットツールなど外部サービスの情報を参照・更新できません。
MCP(Model Context Protocol:AIと外部ツールをつなぐ共通規格)をベースにしたコネクタを通じて、課題管理ツールのチケットを読む、データベースに問い合わせる、チャットツールに報告を投稿するといった動作が可能になります。
修正案を提示するだけのエージェントと、変更を提案してチケットを更新しテストが通ったら通知するループの差はここにあります。
ただし、外部ツールへの接続は、AIに社内の情報を読ませ、外部に書き込ませる経路そのものになります。
信頼できない接続先からの入力がAIモデルの判断に影響しうる点も含めて、どのツールをつないでよいかは個人の設定ではなく組織の方針として決めます。
サブエージェント(メインのエージェントから呼び出される、別の指示を持った補助的なエージェント)を使い、作業する役と検証する役を分ける設計です。
生成したエージェント自身に評価まで任せると、生成時の前提や見落としをそのまま引き継ぐ可能性があります。そのため、作業する役と検証する役を分け、異なる指示やコンテキストで確認させる設計が有効です。
検証役には別の指示と別の権限を与え、必要に応じて別のAIモデルを使う方法もあります。
大規模言語モデル単体では、別々の実行の間に作業状態を自動で引き継ぐことはできません。
何が完了し、何が失敗し、次に何をやるのかという情報を、Markdownファイルや課題管理ボードなど、会話の外に保存しておく必要があります。
記憶がなければ、ループは毎回ゼロから同じ作業を繰り返し、数日前に見送った案を再提案するといった現象が起きます。
ループエンジニアリングはClaude Codeだけで実現するものではありません。前述した自動起動・状態保存・検証・エージェント間の役割分担といった仕組みを組み合わせれば、複数のフレームワークで同様の構成を作れます。
代表的な選択肢をまとめると、次のとおりです。
| フレームワーク・ツール | 得意な領域 | ループ構築で使える主な機能 |
|---|---|---|
| LangChain/LangGraph | 長時間・状態保持型のワークフロー | 処理の分岐・状態保存・チェックポイント・中断/再開・人による承認 |
| CrewAI | 複数のAIエージェントによる役割分担 | エージェント間の協調・Flowによる処理制御・状態保存・メモリ・ガードレール |
| OpenAI Agents SDK | 比較的シンプルなエージェントループの実装 | ツール呼び出し・エージェント間の引き継ぎ・セッション・ガードレール・トレーシング |
| Microsoft Agent Framework | 業務システムを含む複数工程のワークフロー | ワークフロー・状態管理・チェックポイント・中断/再開・人による承認・複数エージェントの制御 |
どのフレームワークを使っても「何をもって完了とするか」「何回まで繰り返すか」「どの操作には人の承認を挟むか」といった条件が自動で決まるわけではありません。
フレームワークはループを実行する土台であり、ループそのものの設計は利用する側が行います。そのため、必要な構成要素を先に決め、実装しやすいものを選ぶとよいでしょう。
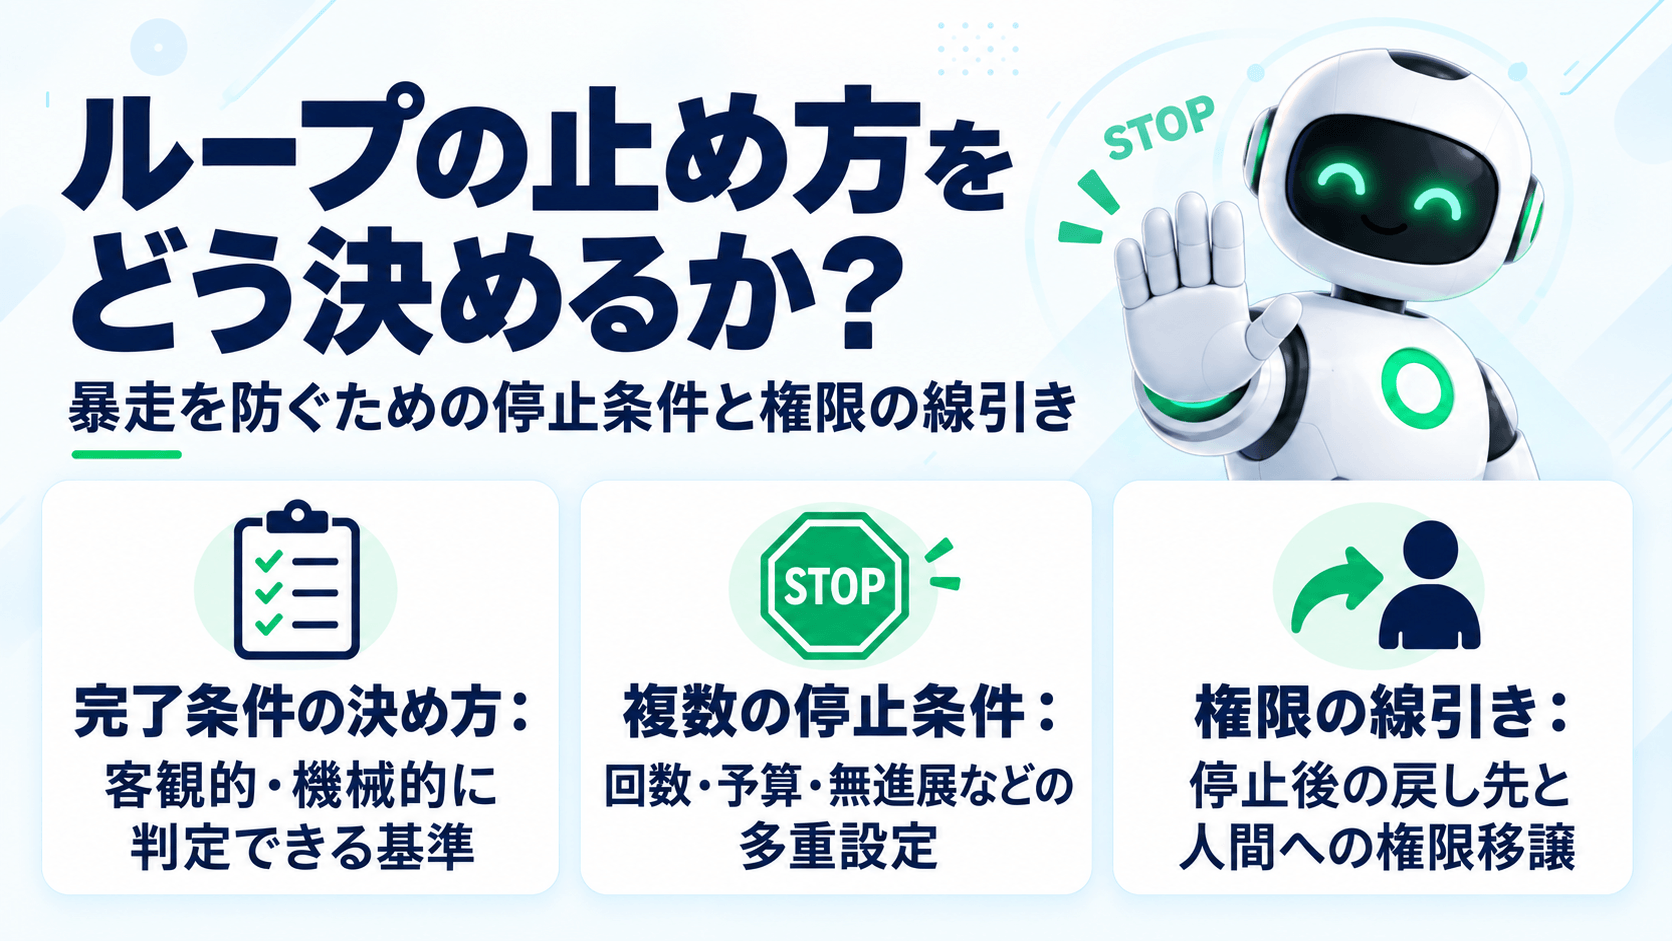
構成要素を揃えればループは動きます。ただし実際の設計で大事なのは、「どう回すか」ではなく「どう終わらせるか」です。止め方が曖昧なループは、処理が終わらなかったり、失敗したまま動き続けたりするおそれがあるため、稼働前に停止条件を決めておく必要があります。
最初に決めるのは「何をもって完了とするか」です。
対象のテストがすべて通る、エラー率が0.1%未満、表示速度が1.5秒以内といったように、機械的に判定できる形にします。合否を判定できない作業をループに載せると、速度だけが上がってミスが再生産されます。
停止条件は1種類ではなく、代表的なものを組み合わせて多重に塞ぐのが基本です。
| 種類 | 内容 |
|---|---|
| 回数上限 | 試行回数の上限を決める。Claude CodeのSDKでは max_turns で設定でき、数えるのはツール呼び出しを伴うターンのみ、既定値は無制限 |
| 予算上限 | ループ全体の利用金額に上限を設ける。maxbudgetusd として用意されており、既定値は無制限。サブエージェントの消費も合算される |
| 無進展の検出 | 直近の数回で成果物に変化がなければ止める。同じ失敗を繰り返す挙動を断つ |
| 異常時の強制終了 | ツール呼び出しの連続失敗など、特定の異常パターンで打ち切る |
1つの条件だけでは想定外の実行を十分に防げないため、複数の停止条件を組み合わせます。
【参考】How the agent loop works|Claude Code Agent SDK
止まったあと、誰に何が渡るのかを決めておきます。
同じ失敗が3回続いたら人間に戻す、外部APIのエラーはチャットに通知するといった戻し先がないと、詰まった状態のままトークンを消費し続けます。
権限の線引きも必要です。自動実行を許可するのは、隔離した作業空間の中で読む・書く・テストやlintを実行する範囲にとどめます。mainへのマージ・本番環境への反映・外部への送信・ファイルやブランチの削除・依存パッケージの追加には人間の承認を挟みます。
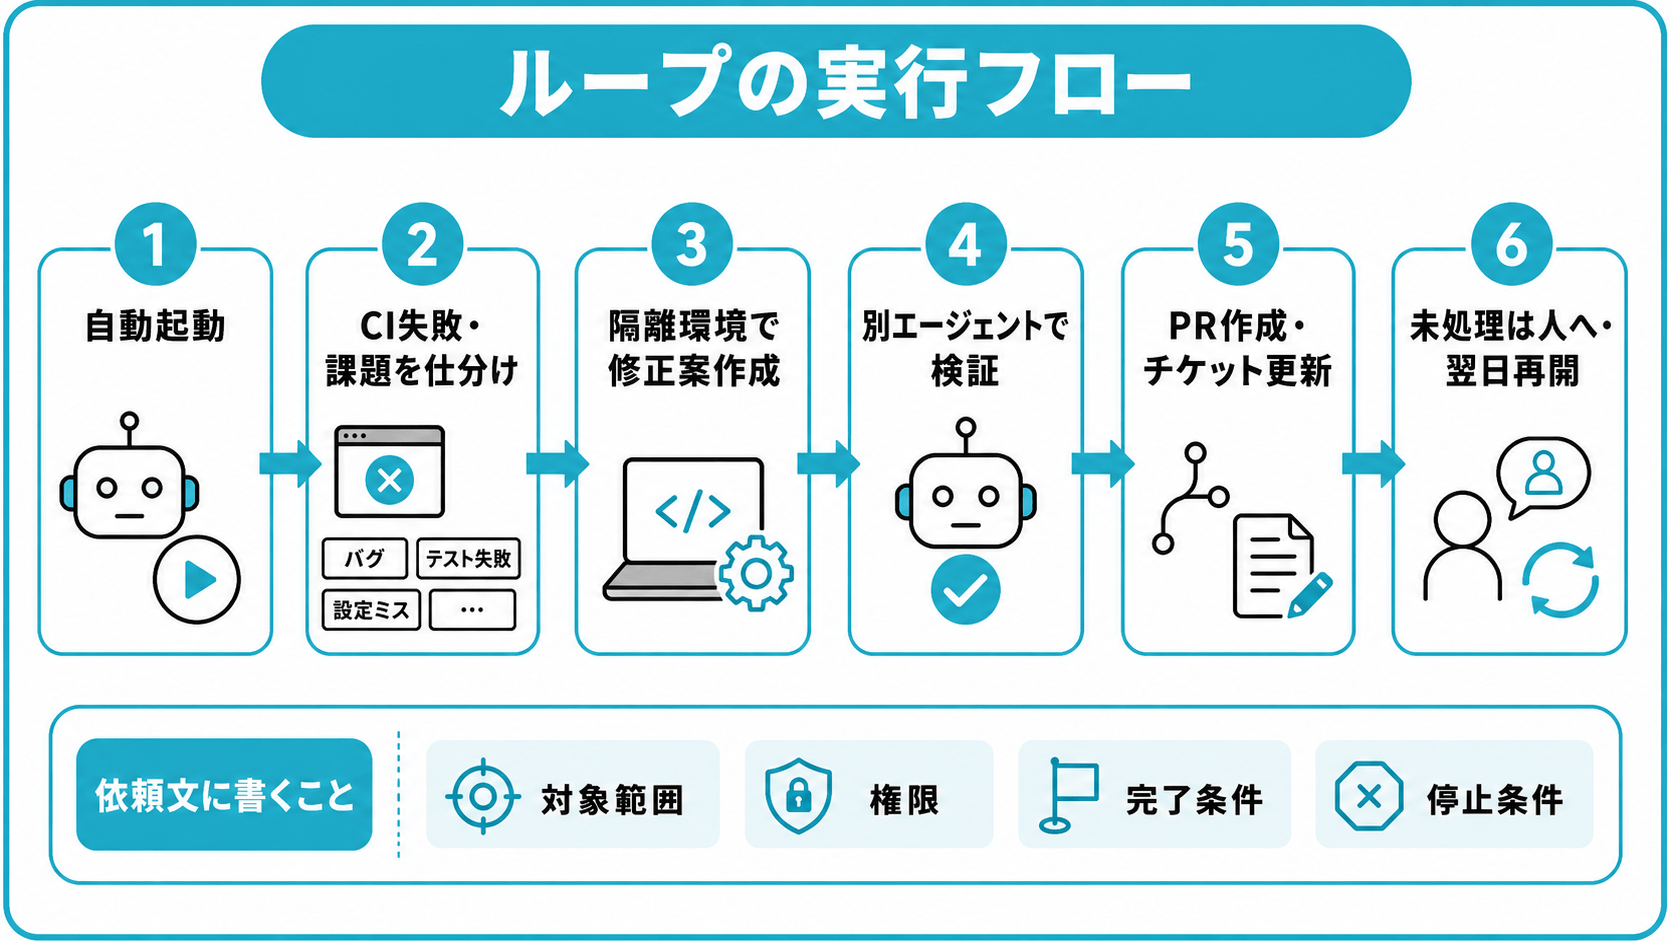
6つの構成要素が実際の流れの中でどう組み合わさるかを見ていきます。
例えば、以下のような流れで自動化できます。
1.タスクの仕分け(トリアージ)
毎朝、自動実行プログラムが走り、前日のエラーや未対応の課題を読み込みます。AIが「これは自動修正可能」「これは人間による確認が必要」といった優先順位をつけ、状況を報告ファイルや管理ボードに書き出します。
2.修正案の作成
対応すべき課題に対し、別のAI(サブエージェント)が隔離された作業環境で修正案を作成します。
3.検証と反映
別のAI(検証役)が、その修正が既存のテストに適合するかを確認します。問題なければPR(修正依頼)を作成し、チケットを更新します。
4.継続と報告
対応できなかった課題はそのまま残され、翌朝また同じプロセスが走ります。状態はファイルに保存されているため、前日の続きからスムーズに再開できます。
このように設計しておけば、人間が毎日プロンプトを入力しなくても、AIが自動的に課題を整理・解決してくれます。
「このバグを直して」とだけ伝えて長時間走らせると、テストは通っているのに元の仕様が壊れていた、という結果になりかねません。作業範囲・権限・完了条件・停止条件を最初に書き込んでおくと、同じ依頼でも挙動が安定します。
決済フローのE2Eテストをすべて通す状態にする。

・対象は src/checkout/ と tests/checkout/ のみ
・作業は feature/fix-checkout-timeout の専用ディレクトリで行う
・自動で許すのは対象ディレクトリ内での編集、テスト実行、lint、buildまで
・mainへのマージ、依存パッケージの追加、DBマイグレーション、外部への送信、ファイル削除は人間の承認を挟む
・完了条件は、E2Eが20回連続で通り、既存のアサーションに変更がないこと
・テストを変更した場合は、その理由をPRに書き残すこと
・5回試して通らない、予算が20ドルに達する、直近3回で差分が変わらない、のいずれかで停止する
・停止したら差分と実行ログをPRに残す
長く見えますが、これはプロンプトというより作業の仕様書です。
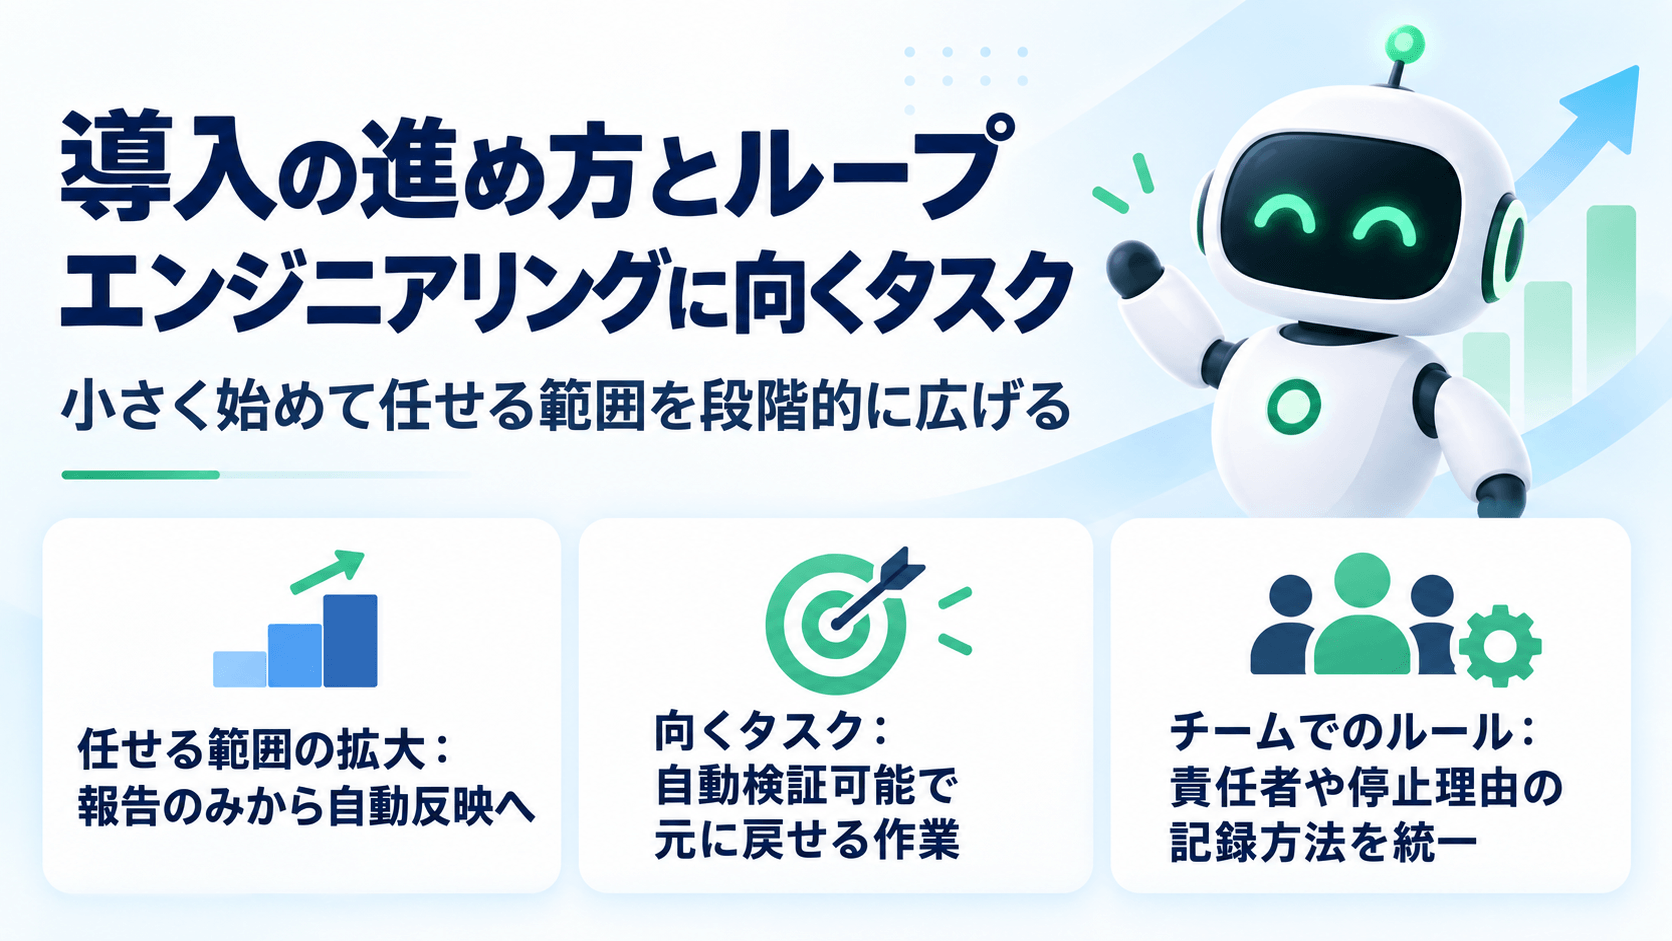
いきなり無人で動くループを組むのではなく、任せる範囲を段階的に広げます。
| 段階 | 内容 | 人間の関与 |
|---|---|---|
| 報告のみ | ループは調査・検出して結果を報告するだけで、変更は加えない | 修正はすべて人間 |
| 検証付きの修正案 | ループが修正案まで作り、テスト結果などの証拠を添えて提出する | 承認と反映は人間 |
| 自動反映 | 検証を通過したものは自動で反映される | 例外時のみ人間 |
報告のみの段階から始めれば、ループの判断精度を安全に評価できます。
適性は、自動で検証できるか・失敗しても戻せるか・停止条件を数値で書けるかの3点でおおむね判断できます。
| 具体例 | 共通する特徴 | |
|---|---|---|
| 向くタスク | CI失敗の一次調査と修正案の作成/テストコードの補完/ログの巡回点検と異常分類/ドキュメントと実装の同期/依存ライブラリの更新確認 | 自動で検証できる、失敗時に元に戻せる、停止条件を数値で書ける |
| 慎重に扱うタスク | 広範囲のリファクタリング/本番環境の権限操作/セキュリティに関わる変更/対外的な発信 | 影響範囲が大きい、元に戻すコストが高い |
| 向かないタスク | デザインの方向性や文章のトーンの判断/一度きりで反復しない作業/要件が固まっていない検討 | 客観的な合否基準がない、ループを組むコストを回収できない |
向かないタスクは、従来どおり人間が対話しながらエージェントを使う方が適しています。
個々のループで停止条件を定めたうえで、チームとして運用する場合は責任者や記録方法も統一します。個人の設定にとどめず組織の仕組みとして動かすなら、稼働前に次の項目を決めておきます。
| 項目 | 内容 |
|---|---|
| 責任者 | ループごとに1人置き、結果とコストの両方を見る |
| 上限 | 最大の実行回数・制限時間・予算 |
| 証拠の形式 | 何が出ていれば合格とみなすか |
| 停止理由の記録 | どの条件で止まったかを残す |
| ロールバック手段 | 問題が起きたときに元に戻す方法 |
ループの実行履歴を後から追える状態にしておくことも必要です。コストや品質の異常に気付いても、どのループが何をしたか特定できなければ対処できません。
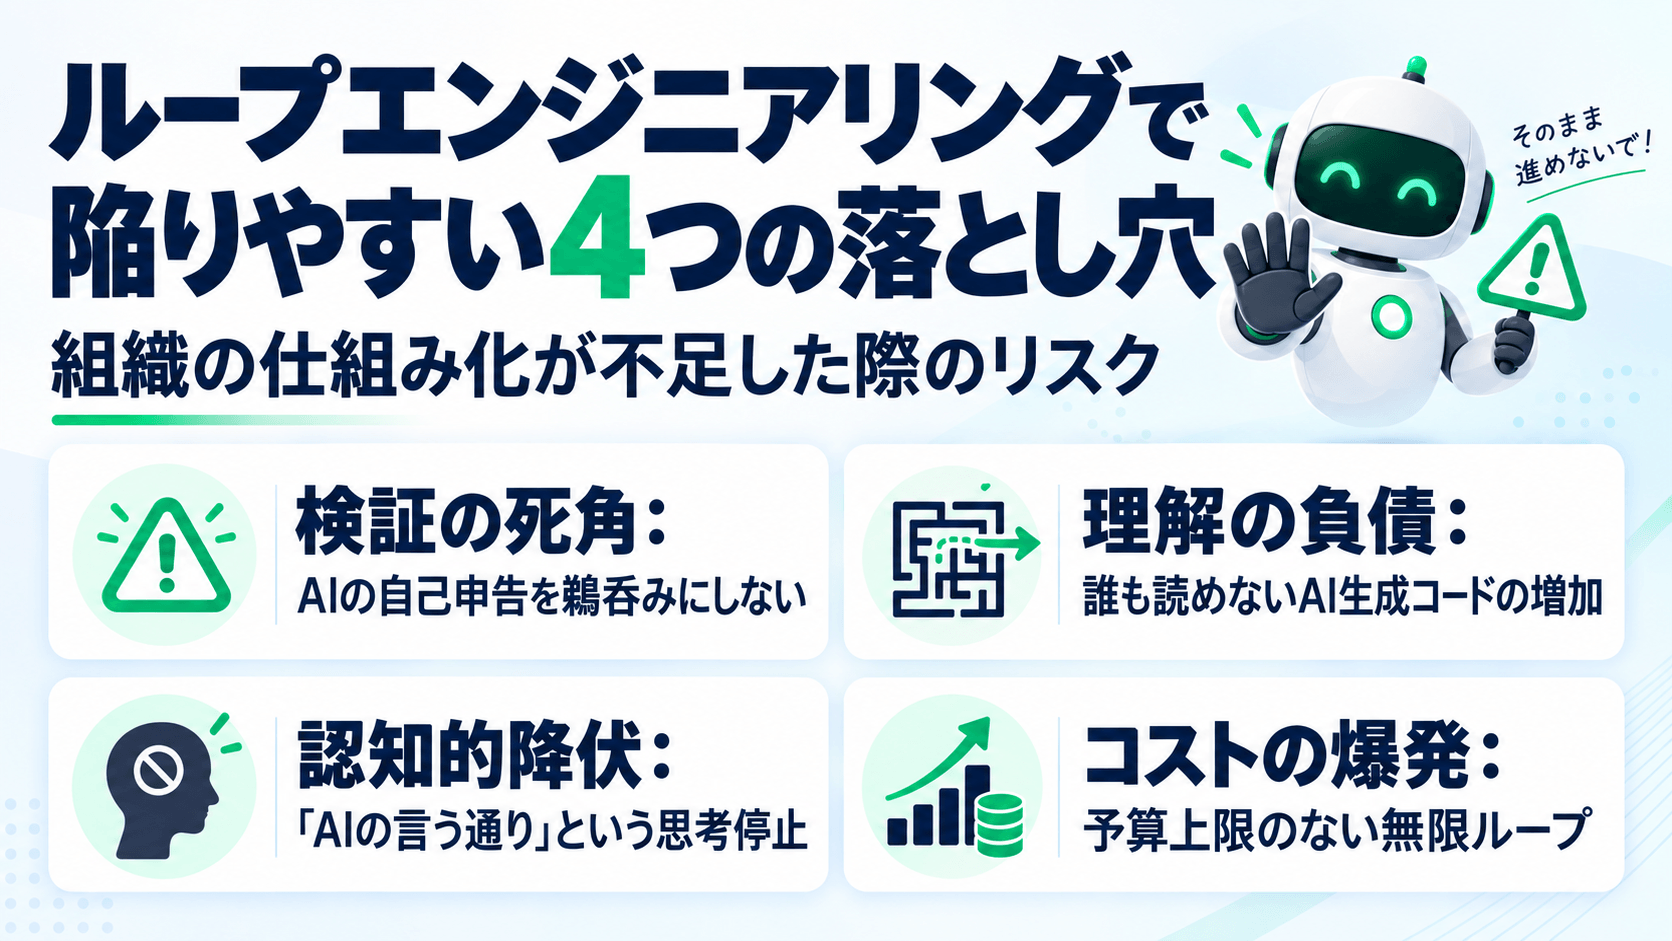
ループエンジニアリングは強力ですが、運用を組織の設計として仕組み化しないと、以下のようなリスクが生まれます。
AIが「完了しました」と言っても、それは自己申告に過ぎません。AIに作業と検証の両方を任せると、自分のミスを自分で見逃し続けます。「AIが完了と言ったからOK」という判断は組織として禁止し、テストやCIなど客観的な証拠で合格を判定する仕組みが不可欠です。
AIが書いたコードを人間が確認せずに量産し続けると、「何が書かれているか誰もわからない」という状況に陥ります。これを「理解の負債」と呼びます。いざ障害が起きた時に誰も修正できなくなるため、AI生成物であっても人間が理解・レビューする習慣を崩してはいけません。
AIが自動で結果を出すことに慣れると、人間が自分の頭で考えるのをやめてしまいます。これを「認知的降伏」と呼びます。AIが出した答えをそのまま使うのではなく、「なぜその判断をしたのか」を自分の言葉で説明できないものは採用しないという厳しさが必要です。
人間が操作する作業と違い、ループは止めない限り永遠に動き続けます。並列で複数のAIを走らせれば、1日分の予算を数時間で使い切ることも珍しくありません。必ず「いつ止めるか」という予算・回数・時間のハードリミット(強制停止条件)を事前に設定してください。
ループエンジニアリングは、AIエージェントに指示を打ち続ける人間の役割を、指示を出し検証する仕組みの設計へ移す考え方です。2026年6月にAddy Osmani氏が「Loop Engineering」と題した記事を公開し、Claude CodeやCodexに必要な機能が揃ってきたことで、選択肢として現実味を帯びました。
提唱者自身が「まだ初期段階であり、自分自身も懐疑的だ」と留保を付けているとおり、これは完成した方法論ではありません。用語も推奨される進め方も、今後変わる可能性が高い領域です。小さく試して自社の現場で確かめるのが、現時点では確実な進め方です。
仕組みを整えたあとも、何を目標にするか、どこで止めるか、出てきたものを世に出してよいかを決めるのは人間の側です。
アイスマイリーでは、AIエージェントのサービス比較と企業一覧を無料配布しています。課題や目的に応じたサービスを比較検討できますので、ぜひこの機会にお問い合わせください。
AIエージェントへの指示・検証・停止を、人間が都度操作するのではなく、ループとして設計する考え方です。2026年6月にAddy Osmani氏がこの名称でまとめました。業界で定義が統一されているわけではなく、現在進行形で議論されている概念です。
ハーネスエンジニアリングはエージェント1回の実行環境(使えるツール、制約、検証の仕組み)を設計する手法です。ループエンジニアリングは、そのハーネスを外側から動かす側にあたり、いつ起動し、どう検証し、いつ止めるかを設計します。ハーネスが整っていることがループの前提です。
まず、プロジェクトのルールや禁止事項など、常に参照させたい情報をCLAUDE.mdなどに記録します。繰り返し使う作業手順はSkillsとして用意し、そのうえで機械的に検証できる小さな作業をひとつ選び、報告のみの段階から試します。
ループエンジニアリングは特定ツールの機能ではなく設計の考え方のため、OpenAI Codexやオープンソースのエージェントなどでも実践できます。本記事で挙げた6つの構成要素に相当する機能が揃っているかを基準に選ぶとよいでしょう。
ループの実装はエンジニアの領域ですが、導入判断に必要なのは技術の詳細よりも運用の設計です。どの作業をどこまで自動化するか、予算の上限をいくらにするか、どこで人間の承認を挟むか。これらは情報システム部門やDX推進の立場から決めるべき論点です。
なくなりません。指示を打つ作業からは外れる一方で、目標と境界の定義・停止条件の設計・最終的な検証と責任は人間に残ります。ループを設計するほうがプロンプトを書くより簡単になったわけではなく、人間が受け持つ仕事の中身が変わったと捉えるほうが実態に合います。
業務の課題解決に繋がる最新DX・情報をお届けいたします。
メールマガジンの配信をご希望の方は、下記フォームよりご登録ください。登録無料です。


FOLLOW US
SNSをフォローして、最新情報をチェックできます!


AI製品・ソリューションの掲載を
希望される企業様はこちら