


生成AI
最終更新日:2026/10/08
GPT-Liveは、OpenAIが2026年7月8日に発表した新世代の音声モデルです。聞きながら話せるフルデュプレックス構造の仕組み、Advanced Voice Modeとの違い、プラン別の料金と提供範囲、法人利用の可否、音声データの扱いまで、公式情報をもとに解説します。
OpenAIが新しい音声モデルを発表して以来、「GPT-Liveって結局なにが変わったの?」「自分のプランで使えるの?」「Advanced Voice Modeとどう違うの?」という声が増えています。
一言でいえば、ChatGPTの音声機能を根本から作り替えるアップデートがGPT-Liveです。聞くことと話すことを同時に行えるため、これまでの「交互に話す」やり取りから、人と話しているような会話へと一気に近づきました。
2026年10月時点では、個人向けプランに加え、対象のBusiness・Enterprise・Edu・Healthcareワークスペースでも利用でき、開発者向けのGPT-Live-1 APIも9月10日に公開済みです。
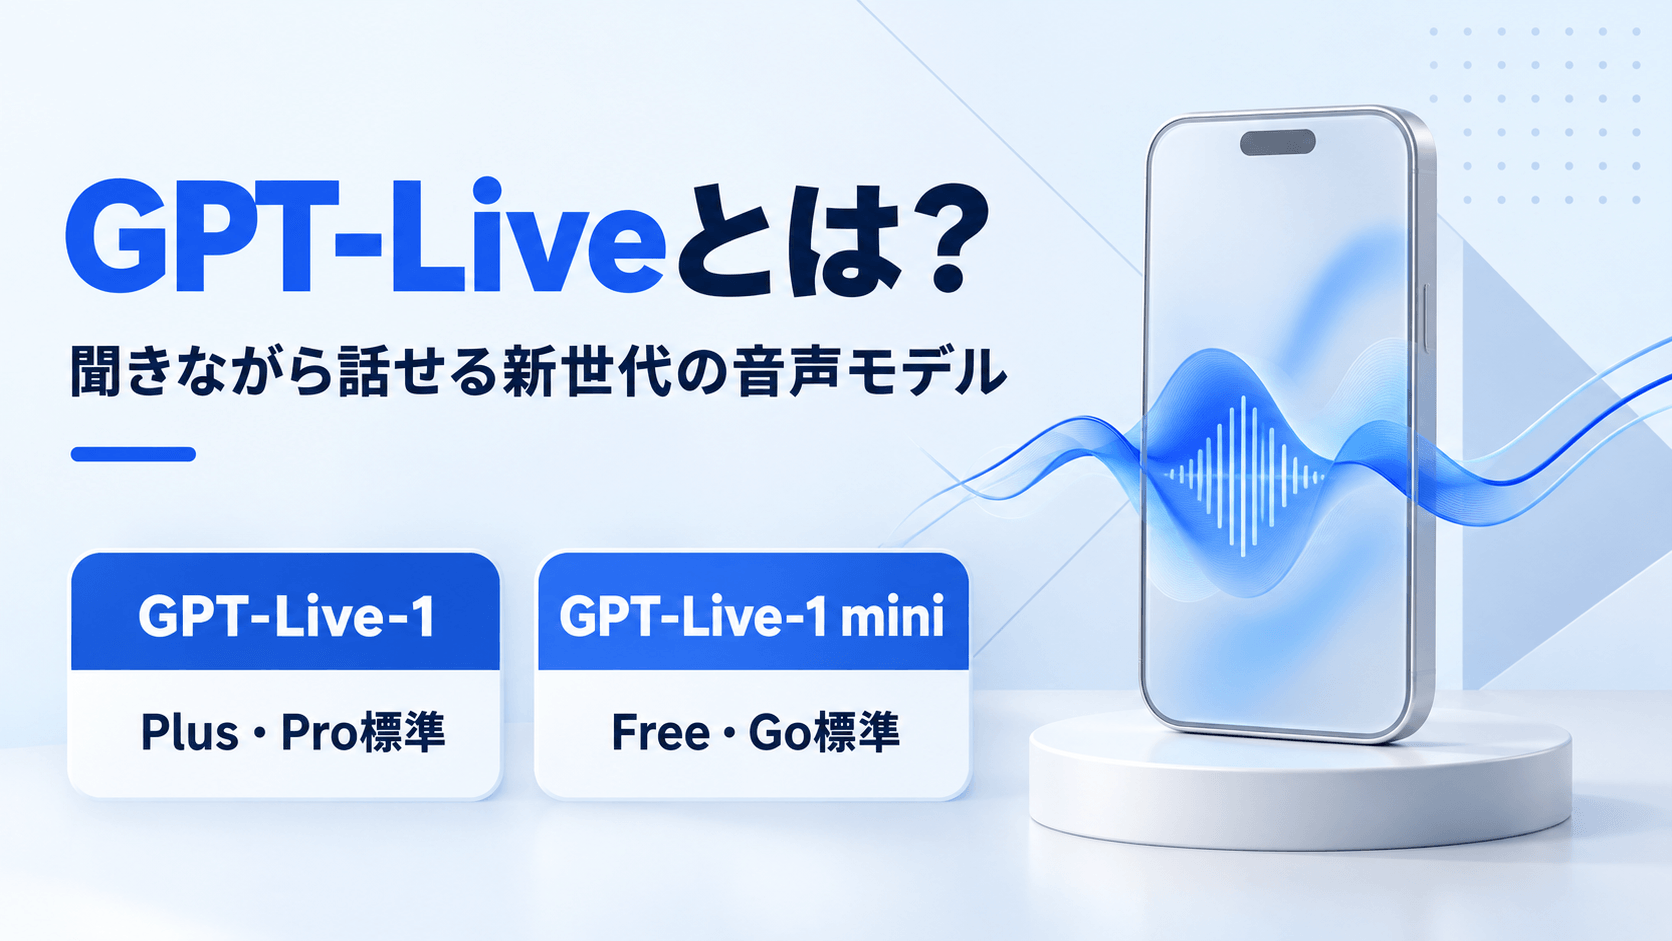
GPT-Live(GPT Liveとも表記されます)とは、ChatGPTの音声機能「ChatGPT Voice」を刷新する新世代の音声モデルです。最大の特徴は、聞きながら同時に話せる点にあります。
OpenAIは現地時間2026年7月8日(日本時間7月9日)にGPT-Liveを発表しました。iOS・Android・chatgpt.comのWeb版に向けて、世界中で順次展開されています。
現在、ChatGPTのVoiceやDictation(音声入力)といった機能は、週に1億5,000万人以上に利用されています。その体験全体が変わるという意味で、今回のアップデートのインパクトは小さくありません。
GPT-Liveには「GPT-Live-1」と「GPT-Live-1 mini」という2つのモデルがあります。
2026年9月9日以降のChatGPT Voiceでは、FreeプランとGoプランでGPT-Live-1 miniが標準となり、PlusプランとProプランでは上位モデルのGPT-Live-1が標準として利用できます。また、利用できる時間枠もプランごとに異なります。
開発者向けには、GPT-Live-1 APIが2026年9月10日に公開されました。音声を担う部分の料金は1分あたり0.05ドルで、組み合わせるバックエンドモデルの利用料は別途発生するようになっています。ChatGPT内での利用と、自社サービスへの組み込みでは、料金の見方が異なるため区別して理解してください。
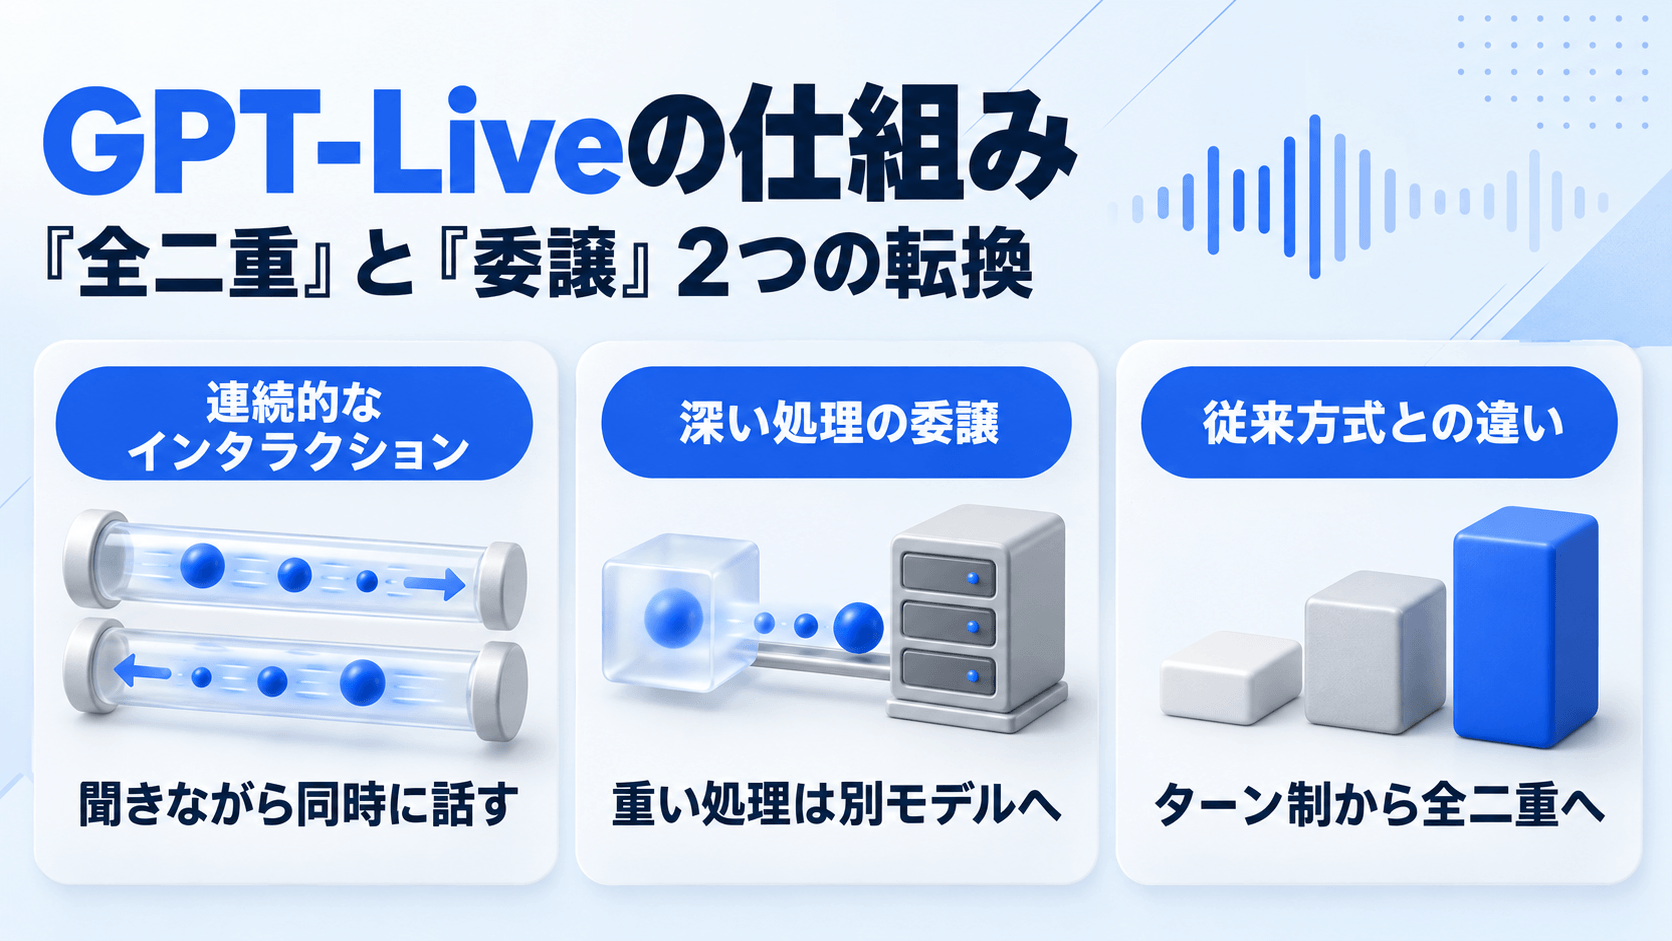
GPT-Liveの本質は、「連続的なインタラクション」と「深い処理の分離」という2つのアーキテクチャ変更にあります。順番に見ていきましょう。
GPT-Liveは、フルデュプレックス(全二重)というアーキテクチャで構築されています。フルデュプレックスとは、聞くことと話すことを同時に行える方式のことです。
従来のように「メッセージのかたまり」を順番に処理するのではなく、GPT-Liveは入力を受け取りながら出力を生成し続けます。そのため「話すか」「聞き続けるか」「一時停止するか」「割り込むか」「ツールを呼び出すか」といった判断を、1秒間に何度も下せるのです。
この設計から、次のような振る舞いが生まれます。
2つ目の転換が、会話を担う部分と重い処理を担う部分の切り離しです。
検索や難しい推論を必要とする質問が来た場合、GPT-Liveは会話を止めずに、処理を別のモデルへ委譲します。2026年9月9日以降のChatGPT Voiceでは、こうした場面でGPT-5.6またはGPT-6 Astraを利用でき、モデルと推論の強度は、テキストチャットと同じ操作画面から選択する仕様です。
重要なのは、委譲している間も会話が止まらないこと。裏で検索や推論が走っている間も、GPT-Liveはユーザーと話し続けます。結果として、気まずい沈黙が生まれません。
GPT-Liveが何を解決したのかは、過去の2方式と並べると分かりやすくなります。
| 方式 | 代表例 | 仕組み | 抱えていた課題 |
| カスケード型 | 初代ChatGPT Voice | 音声認識(STT)→LLM→音声合成(TTS)を直列に接続 | モデル間で情報が失われ、応答が遅くぎこちない |
| ターン制 | Advanced Voice Mode | 単一モデル内で音声を処理・生成 | 沈黙で発話の終わりを判定するため、短い間や背景ノイズで誤って割り込む |
| 全二重 | GPT-Live | 入力処理と出力生成を同時並行 | 提供開始時点では動画・画面共有に非対応 |
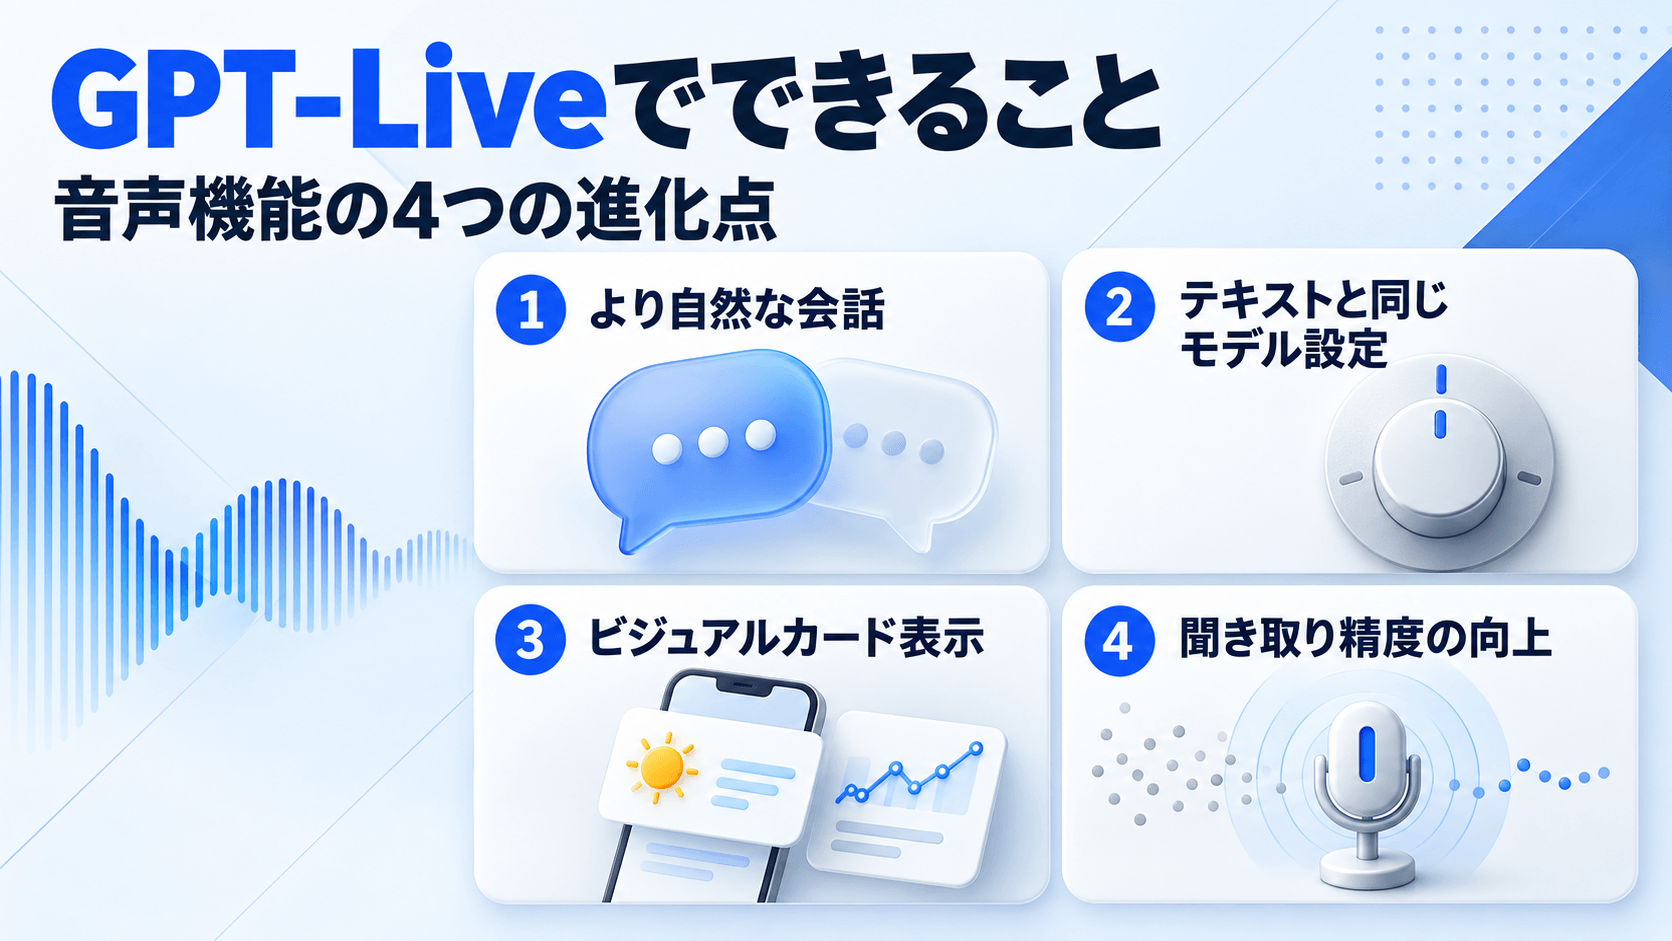
GPT-Liveが搭載されたChatGPT Voiceの進化は、大きく4つに整理できます。「自然な会話」「賢い回答」「ビジュアル表示」「聞き上手」です。
話している途中で割り込んで質問する、考えをまとめるために少し黙る、「もう少しゆっくり話して」と頼む。こうした操作が自然にできるようになりました。
ChatGPTの側も「mhmm」「got it(わかった)」といった短い言葉で相槌を打ちます。会話についてきていることが、声から伝わる仕組みです。
音声そのものも刷新されました。ChatGPTに用意された9種類の音声が、GPT-Live向けにリマスターされています。内訳はArbor、Breeze、Cove、Ember、Juniper、Maple、Sol、Spruce、Valeです。
あらかじめ用意されたChatGPTのパーソナリティ(性格プリセット)は、現時点ではLiveに適用されません。会話中に口調やテンポを指示する形になります。
2026年9月9日、音声専用だったInstant・Medium・Highという設定は廃止されました。代わりにVoiceでも、テキストチャットと同じモデル選択・推論強度の操作を使う仕様へ切り替わっています。
検索や難しい推論が必要な場面では、GPT-5.6またはGPT-6 Astraを利用できます。利用できるモデルと上限は、契約プランによって異なる点に注意してください。
この変更により、音声とテキストの体験に一貫性が生まれました。会話の途中でテキストへ切り替えても、同じモデルとの対話を続けられます。
音声だけでは伝わりにくい情報もあります。GPT-Liveでは、会話の最中に天気・株価・スポーツなどのトピックについて、リッチなビジュアルカードを画面に表示できるようになりました。
Web検索、メモリ、画像の扱いにも引き続き対応します。2026年8月7日には、会話中のファイルアップロードとProjectsでの音声利用にも対応しました。資料の内容を声で質問したり、プロジェクトの指示や過去のチャットを踏まえて話したりできます。
さらに9月23日のアップデートで、Web・iOS・Androidのプラグインにも対応しました。会話中に画像を添付したり、話せない場面ではテキストで入力したりと、同じチャットの中で音声とテキストを行き来できる設計です。
ユーザーが少し黙っても、ChatGPTはすぐに割り込まなくなりました。会話の冒頭で「私が聞くまで待って」と伝えれば、黙って聞き続けます。
通り過ぎる車の音や近くの話し声といった背景ノイズがあっても、ユーザーの声に集中しやすくなった点も改善のひとつ。移動中や屋外での利用を想定した進化と言えるでしょう。
このほか、Apple CarPlayでの音声会話や、他のアプリを使いながら会話を継続する「バックグラウンド会話」といった設定も用意されています。
出典: Introducing GPT-Live|OpenAI / ChatGPT Voice|OpenAI Help Center
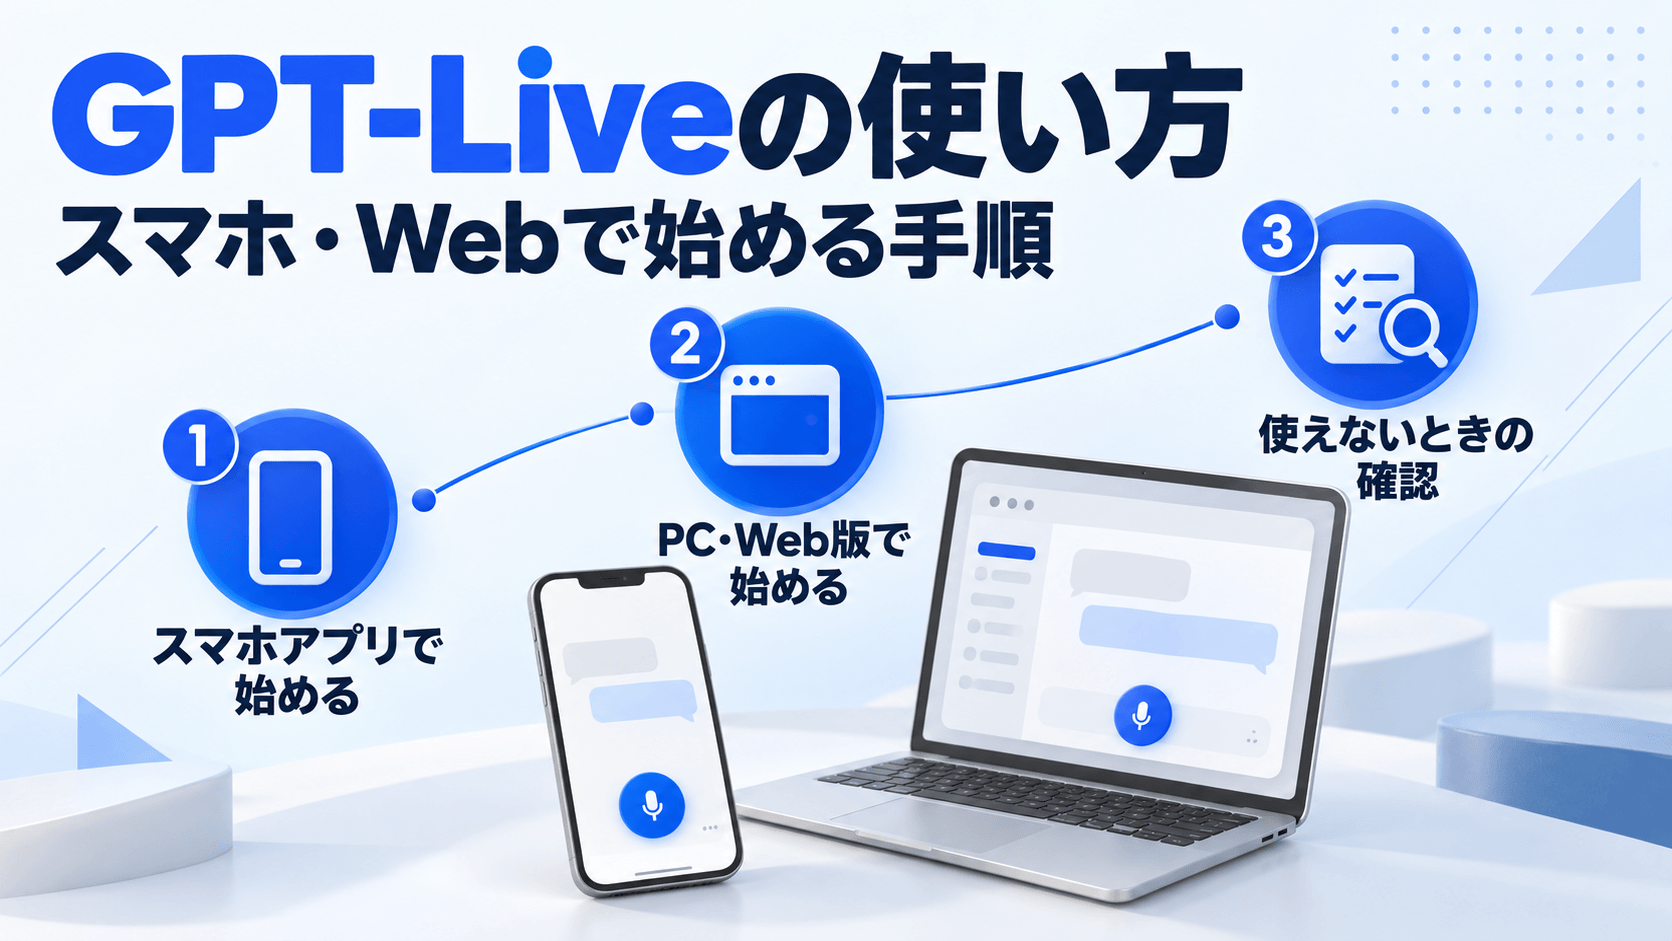
GPT-Liveを初めて使う場合は、対応環境・マイクの許可設定・契約プランを確認してから始めると迷いません。
スマホアプリとWeb版では、GPT-Liveを搭載したVoice in Chatが起動します。一方、Windows・macOSのデスクトップアプリでは「Voice in Desktop」という別の音声体験が用意されており、同じ音声機能でも中身が異なる点に注意してください。
出典:OpenAI
ChatGPTアプリのメッセージ欄にあるVoiceアイコンを選びます。初回はマイクの利用を許可し、好みの音声を選んでから、そのまま話し始めてください。
英会話練習に使う場合は、「Settings(設定)→Voice(音声)→Language(言語)」から主に話す言語を選び、会話の冒頭で役割・話す速さ・訂正の方法を伝える使い方がおすすめです。
関連記事:ChatGPT音声会話の使い方とは?無料・有料の制限や活用例を解説
chatgpt.comの入力欄にあるVoiceアイコンを選び、ブラウザのマイク利用を許可すれば、会話を開始できます。PCでGPT-Liveを使う場合は、デスクトップアプリではなくブラウザ版を開いてください。
Liveの表示可否は、契約プラン・ワークスペースの設定・地域・アプリのバージョン・ペアレンタルコントロールに左右されます。
まずアプリを最新の状態へ更新し、マイクの利用許可が有効になっているかを確認してください。そのうえで、「設定→音声」の選択肢にLiveが表示されているかを確認する流れがおすすめです。
割り込みや聞き取りが不安定な場合は、静かな環境やヘッドホンの利用を試してください。iPhoneでは、Mic ModeのVoice Isolationも選択肢のひとつになります。
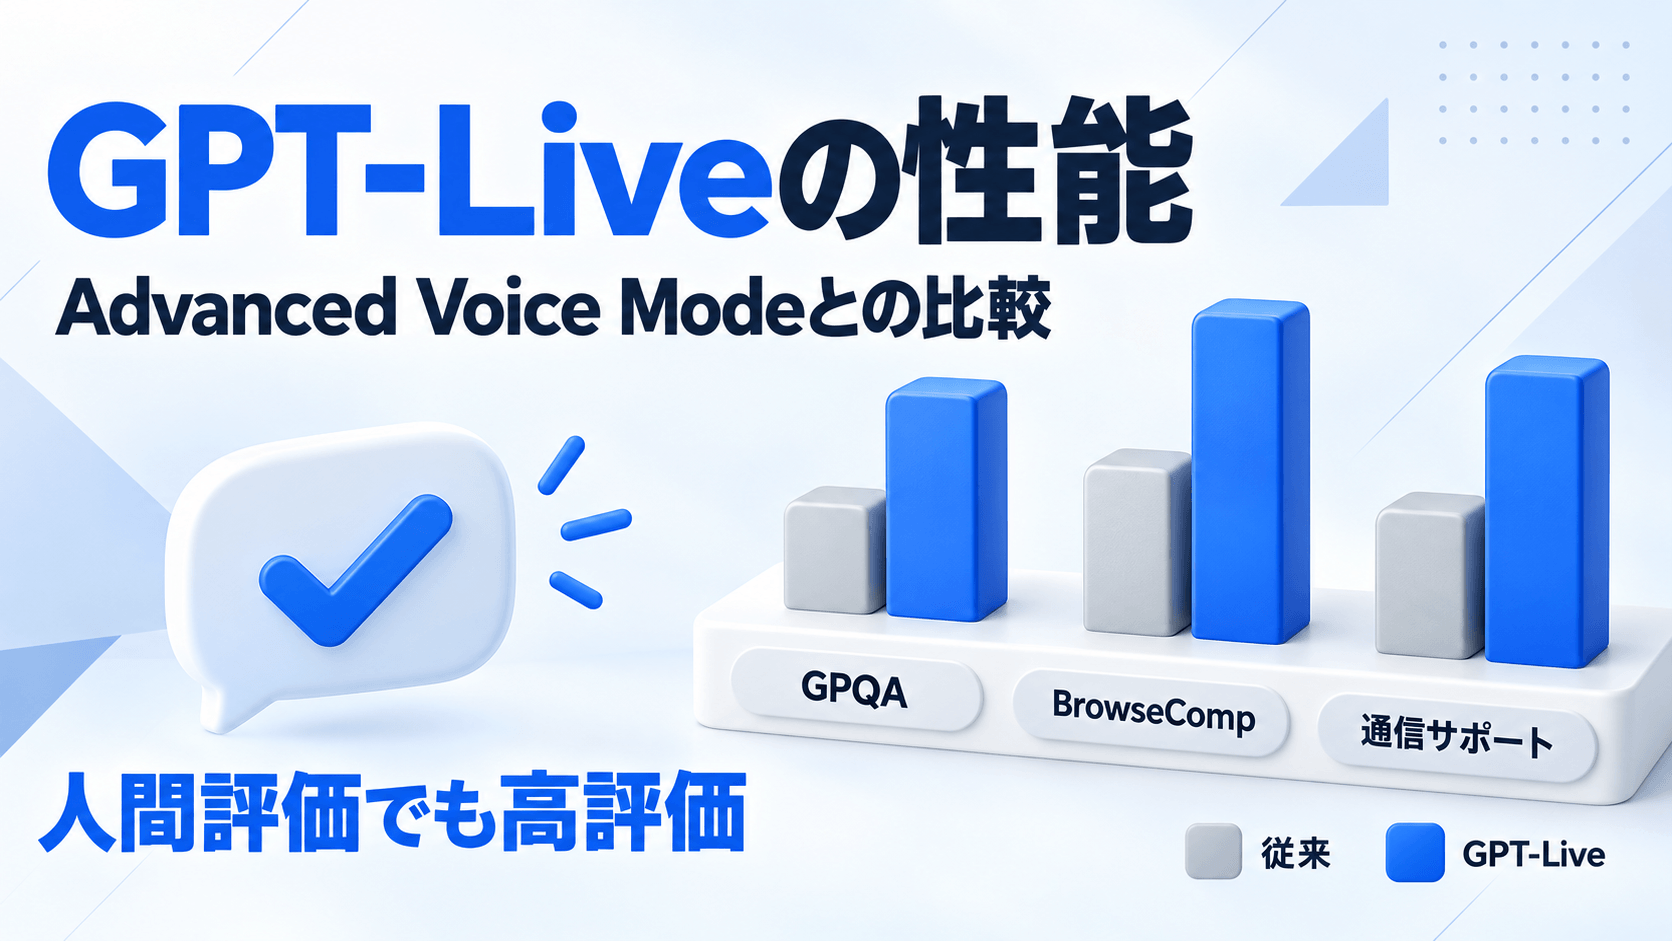
GPT-Liveは、人間による評価と各種ベンチマークの双方で、従来のAdvanced Voice Modeを上回りました。
OpenAIは会話の心地よさと流れを測る新しい人間評価を設計しています。5〜10分の会話を対象にした比較では、総合的な好ましさ、発話の受け渡し、割り込み、会話の流れ、やり取りの自然さのいずれにおいても、GPT-Live-1とGPT-Live-1 miniがAdvanced Voice Modeより強く好まれました。
ベンチマークの結果は次のとおりです。
| ベンチマーク | 測定する内容 | 結果 |
| GPQA | 生物・化学・物理における専門家レベルの科学的推論 | GPT-Live-1がAdvanced Voice Modeを大幅に上回る |
| BrowseComp | エージェント的なWeb検索と、見つけにくい情報を探し出す能力 | GPT-Live-1が明確なスコア向上 |
| τ³-Voice Telecom(社内版) | 現実的な複数ターンの通信サポート業務 | GPT-Live-1がAdvanced Voice Modeを上回る |
ただし、この性能向上をどう解釈するかには議論があります。スコアの伸びは音声対話層そのものの進化というより、裏側の推論モデルに処理を委譲していることに由来する部分が大きいのではないか、と指摘する声も一部のメディアから出ています。
なお、これらの評価は提供開始時点のもので、当時の委譲先はGPT-5.5でした。
出典: Introducing GPT-Live|OpenAI / GPT-Live System Card|OpenAI Deployment Safety Hub
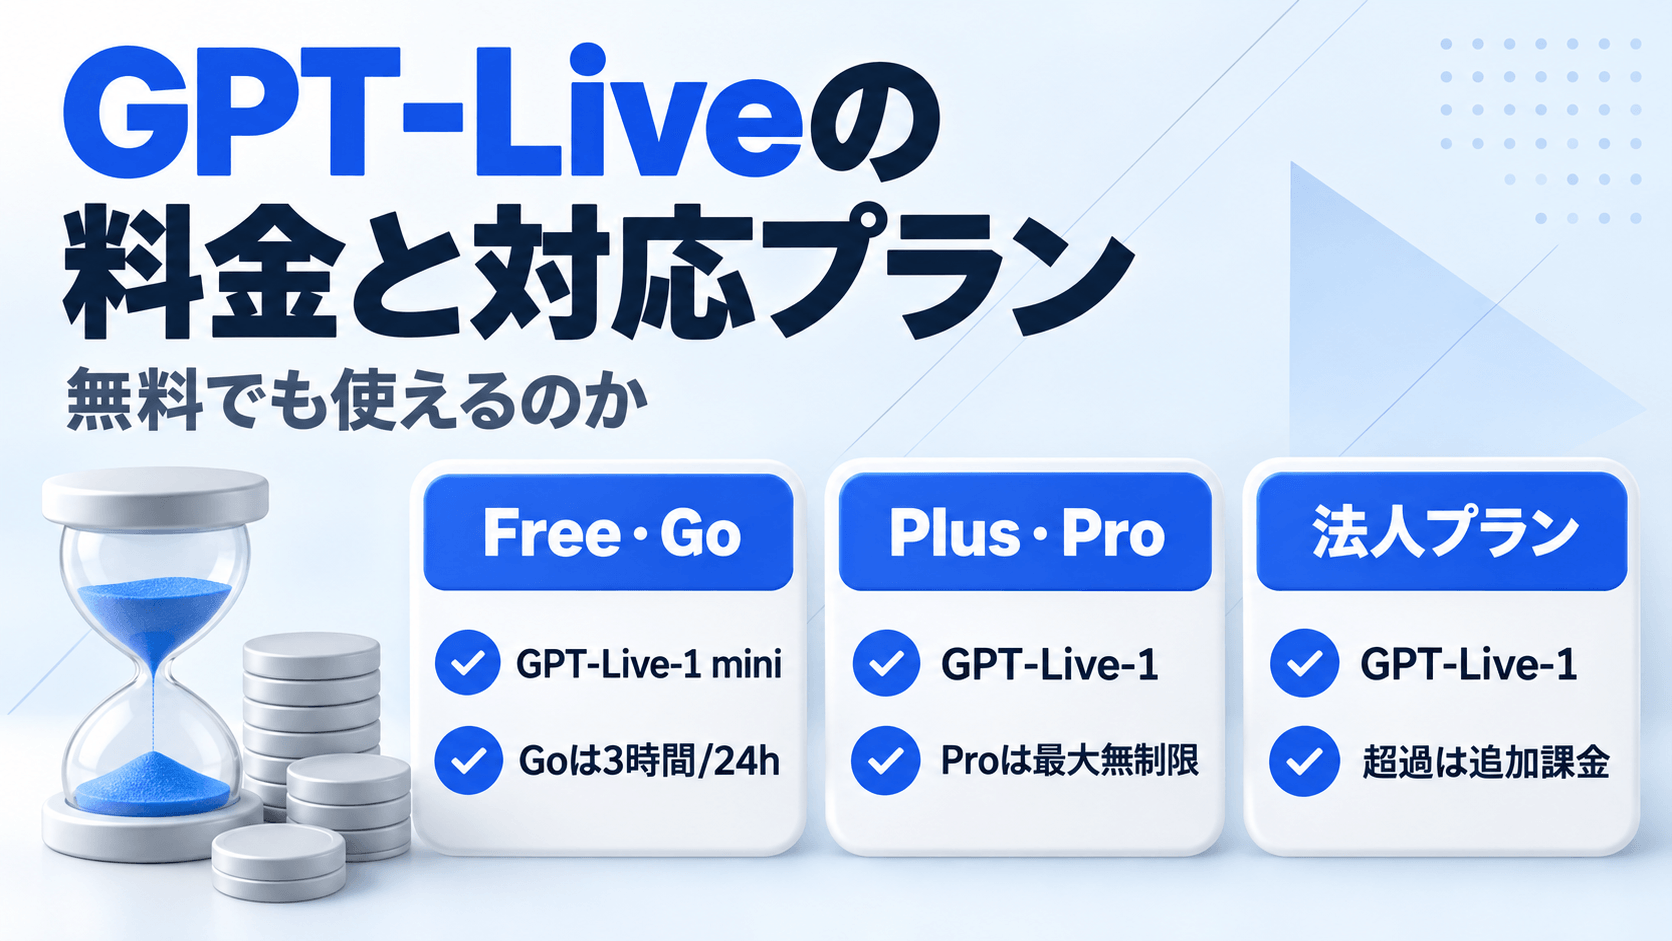
無料プランでもGPT-Live-1 miniを利用できます。一方で、契約プランによって標準モデル・利用枠・追加料金の条件は異なります。
| プラン | 標準のLiveモデル | 24時間ローリング利用枠 | 補足 |
| Free | GPT-Live-1 mini | 制限付き(上限は変動) | 個人向け |
| Go | GPT-Live-1 mini | 3時間 | 2026年9月9日以降はmini |
| Plus | GPT-Live-1 | 3時間 | 上限後にminiへ自動切替なし |
| Pro(100ドル/月) | GPT-Live-1 | 15時間 | 個人向け |
| Pro(200ドル/月) | GPT-Live-1 | 無制限 | 個人向け |
| Business Standard | GPT-Live-1 | 3時間 | 追加利用は1.25クレジット/分 |
| Business Premium | GPT-Live-1 | 15時間 | 追加利用は1.25クレジット/分 |
| K-12 Teachers | GPT-Live-1 | 3時間 | 教員向け |
| Enterprise・Edu・Clinicians(クレジット課金) | GPT-Live-1 | ― | 1.25クレジット/分。ワークスペース設定に依存 |
| Enterprise(従量USD) | GPT-Live-1 | ― | 0.05ドル/分。ワークスペース設定に依存 |
| Legacy Enterprise・Edu | GPT-Live-1 | 3時間 | 旧プラン |
出典:OpenAI
※OpenAI公式ヘルプセンターに基づきます。提供条件は変更される可能性があるため、最新の情報は公式サイトをご確認ください。
利用環境は、次の3つに分けて理解してください。
音声機能の利用上限はプランと音声オプションによって異なり、変更される場合もあります。上限に近づくと、ChatGPT上に通知が表示される仕組みです。
出典: ChatGPT Voice|OpenAI Help Center / Introducing GPT-Live|OpenAI
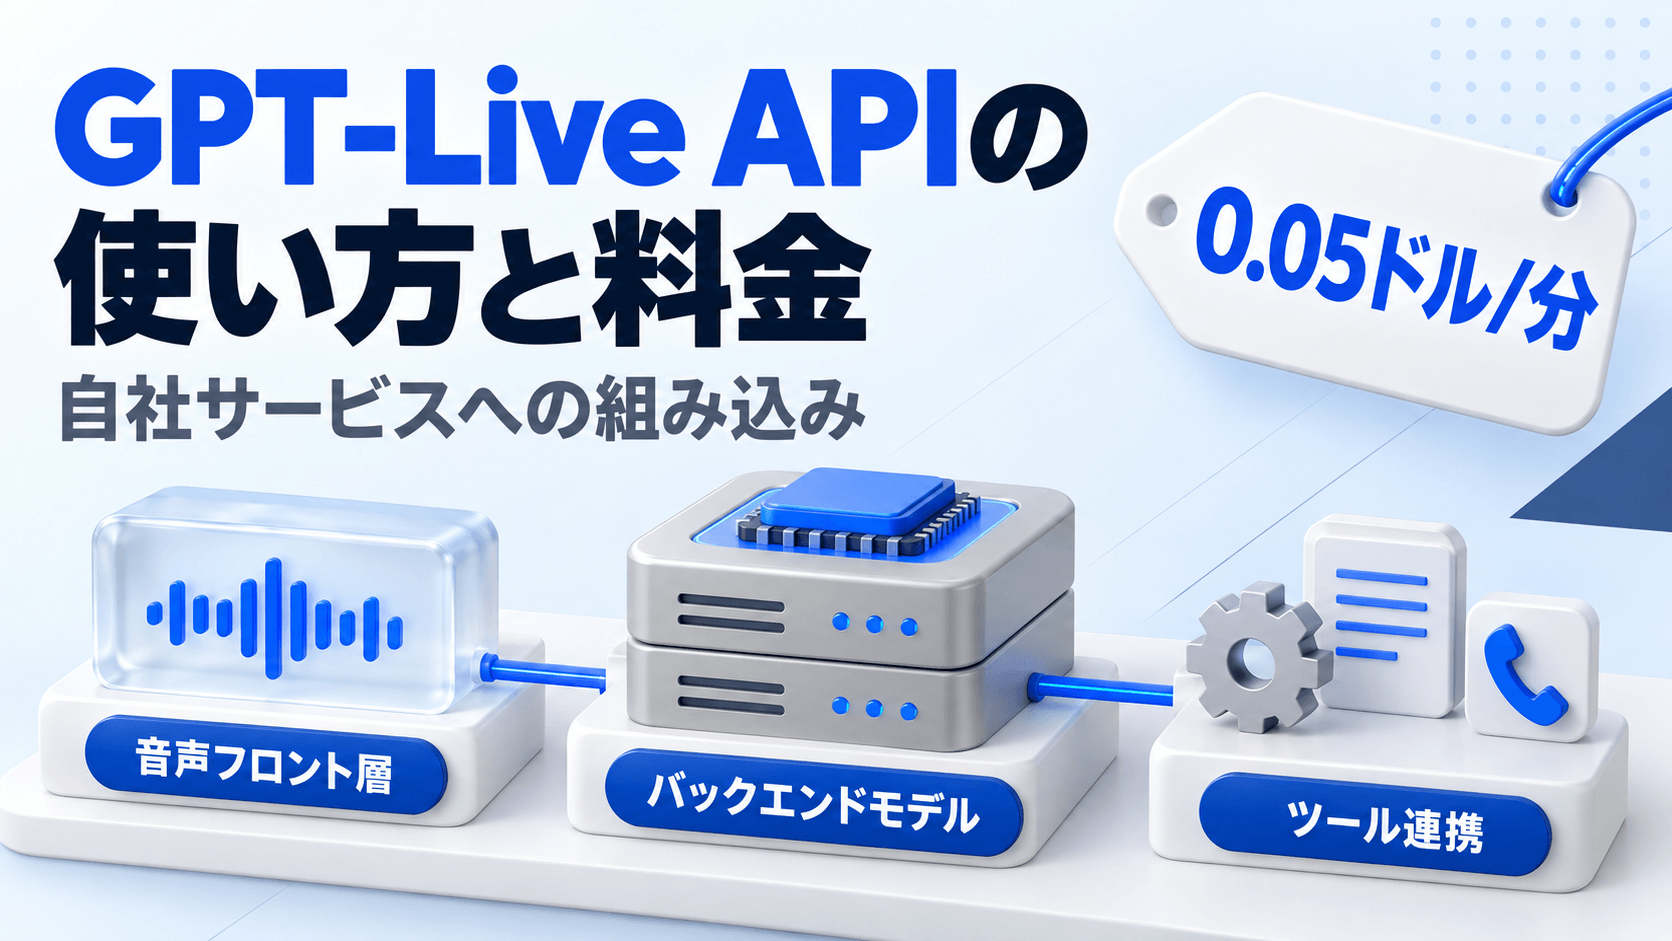
ChatGPT内で使う「GPT-Live」と、開発者が自社サービスへ組み込む「GPT-Live-1 API」は、料金体系も対象も異なります。
GPT-Live-1 APIは2026年9月10日に提供が始まりました。音声を担う部分と、バックエンドの言語モデルやツールを組み合わせて、音声エージェントを構築する位置づけです。
音声フロント層の料金は、1分あたり0.05ドルです。組み合わせるバックエンドモデルやツールの利用料は、別に発生します。
| 項目 | 内容 |
| 提供開始 | 2026年9月10日 |
| 音声フロント層 | 0.05ドル/分 |
| バックエンドモデル・ツール | 別料金 |
| 主な用途 | 音声エージェント、電話、業務ワークフロー |
出典:OpenAI
GPT-Live-1は、割り込みの判断や音声の聞き取り・発話を担います。推論やツール呼び出しは、GPT-6 Astraなどのバックエンドモデルや、第三者モデルへ委譲する設計です。
電話対応の機能、音声認識による文字起こし、応答テキストの生成、名前や略語を正しく聞き取るキーワードバイアスなど、音声エージェントの実装に使える機能が用意されています。
関連記事:OpenAI、APIに3つの新音声モデル導入。リアルタイムで推論・翻訳・文字起こしに対応
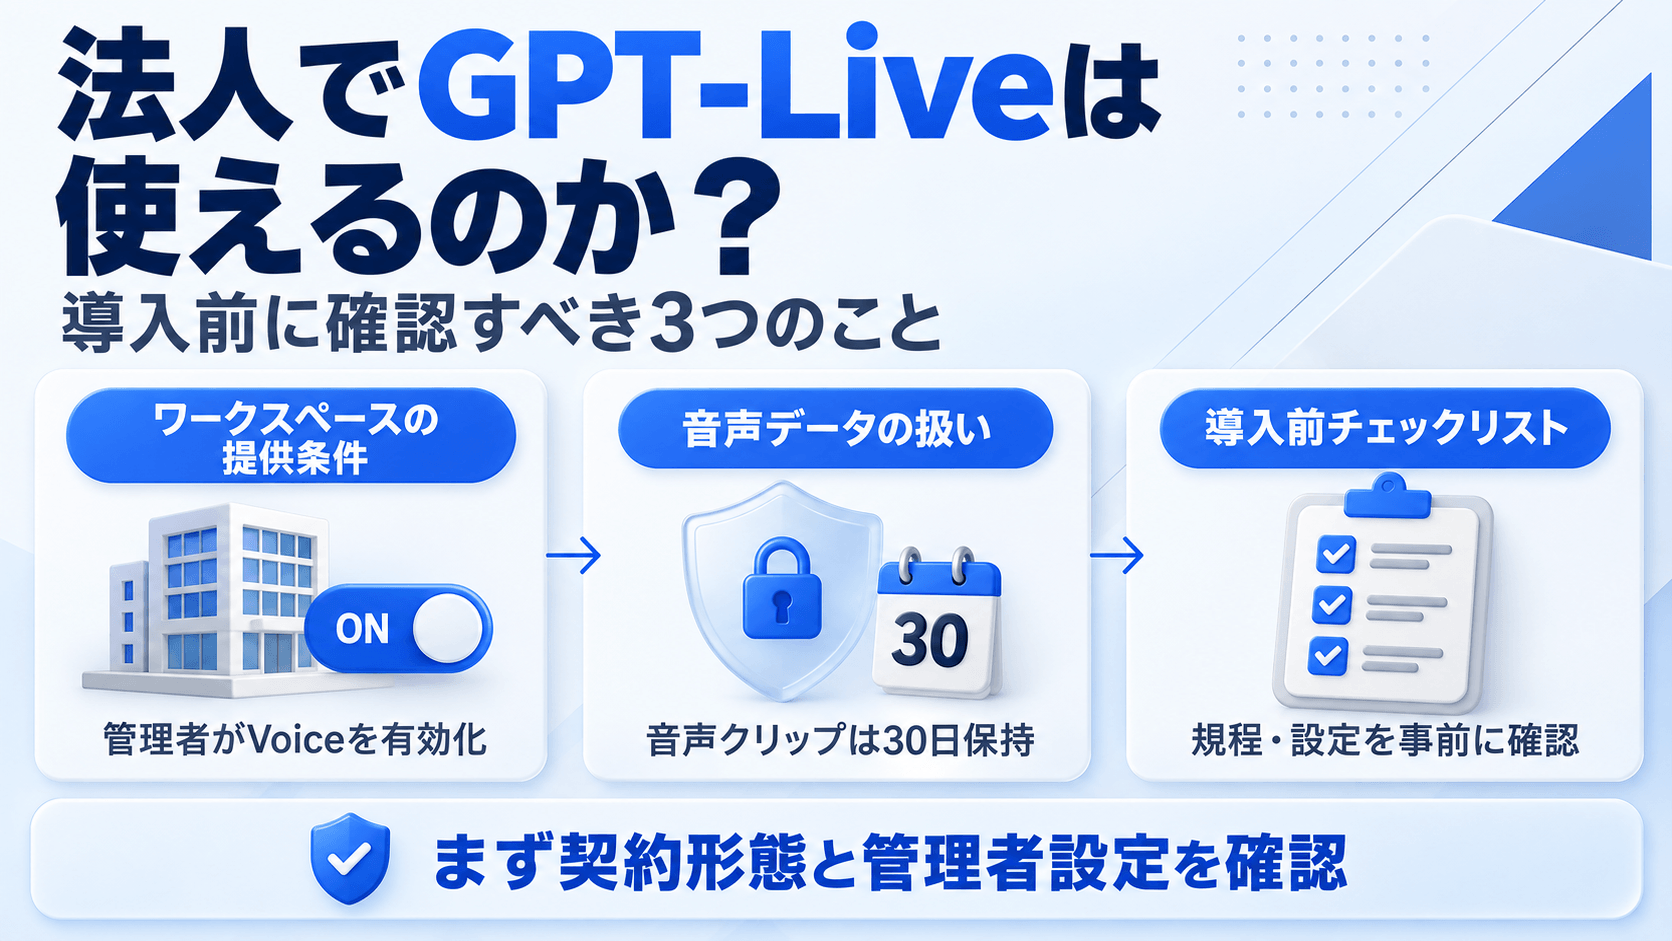
法人利用を検討する場合、まず確認すべきは自社の契約形態です。対象ワークスペースでもVoiceを利用できますが、管理者の設定や契約内容によって、利用可否や利用枠が変わります。
対象のBusiness・Enterprise・Edu・Healthcareワークスペースでは、管理者がVoiceを有効にしていれば利用できます。Voice in ChatはWeb・iOS・Androidで使え、GPT-Liveを搭載しています。
このうちEnterprise・Edu・Healthcareのワークスペースでは、管理者がVoiceを有効にするとLiveが既定のVoice体験になり、Early Model Accessの有効化は不要です。
情報システム部門や法務部門が気にするのは、音声データの扱いでしょう。公式ヘルプセンターの記述を整理します。
補足すると、OpenAIはデータ保持について、法的手続きの影響を受ける可能性がある旨を公式ヘルプセンターに注記しています。最新の条件は必ず公式サイトをご確認ください。
社内会議にそのまま持ち込める形で整理しました。
契約プランの利用枠だけでなく、ワークスペース管理者のVoice設定と、上限超過時にクレジットまたは従量課金が発生する契約かどうかも、あわせて確認しておくと安心です。
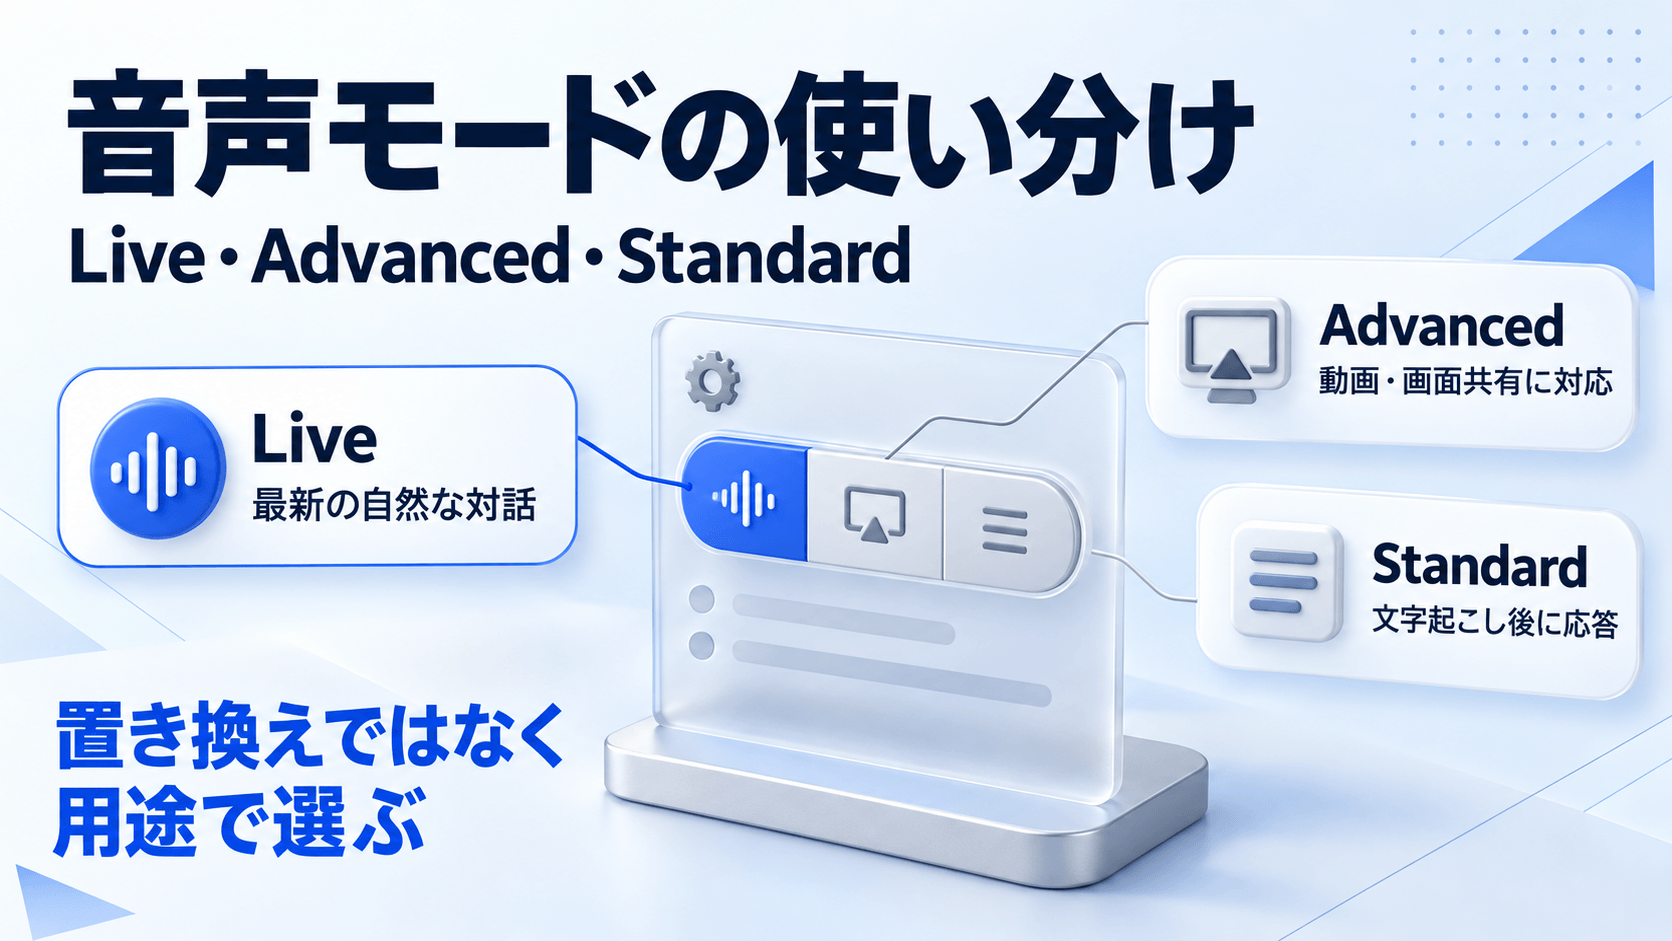
「GPT-LiveがAdvanced Voice Modeを置き換える」という説明を見かけますが、これは正確ではありません。AdvancedもStandardも設定画面に残り、用途によって使い分ける形になります。
とくに動画や画面共有を使いたい場合は、今もAdvancedを選ぶ必要があります。
| モード | 位置づけ | 動画・画面共有 | 主な用途 |
| Live | 最新の音声体験(GPT-Live搭載) | 非対応 | 自然な対話、Web検索、メモリ、ビジュアル表示、プラグイン |
| Advanced | 従来のリアルタイム音声体験 | 対応(対象プランのモバイルアプリ) | 画面を見せながらの質疑、カスタムGPTsとの音声会話 |
| Standard | 発話を文字起こししてから応答する方式 | ― | Liveが使えない環境での代替 |
切り替えは「設定→音声(Settings→Voice)」から、Live・Advanced・Standardのいずれかを選ぶだけ。表示される選択肢は、プラン・地域・アプリのバージョンによって変わります。
カスタムGPTsとの音声会話も、Advanced経由であれば現時点では利用できます。その際、GPTsではShimmerという専用の音声が使われます。
とはいえ、OpenAIは2026年9月11日、カスタムGPTsを全プランで廃止し、プラグインへ移行する計画を発表しました。公式FAQによると、廃止予定日は2026年12月11日です。日程はプランやワークスペースによって異なる場合があるため、最新の情報は公式サイトをご確認ください。
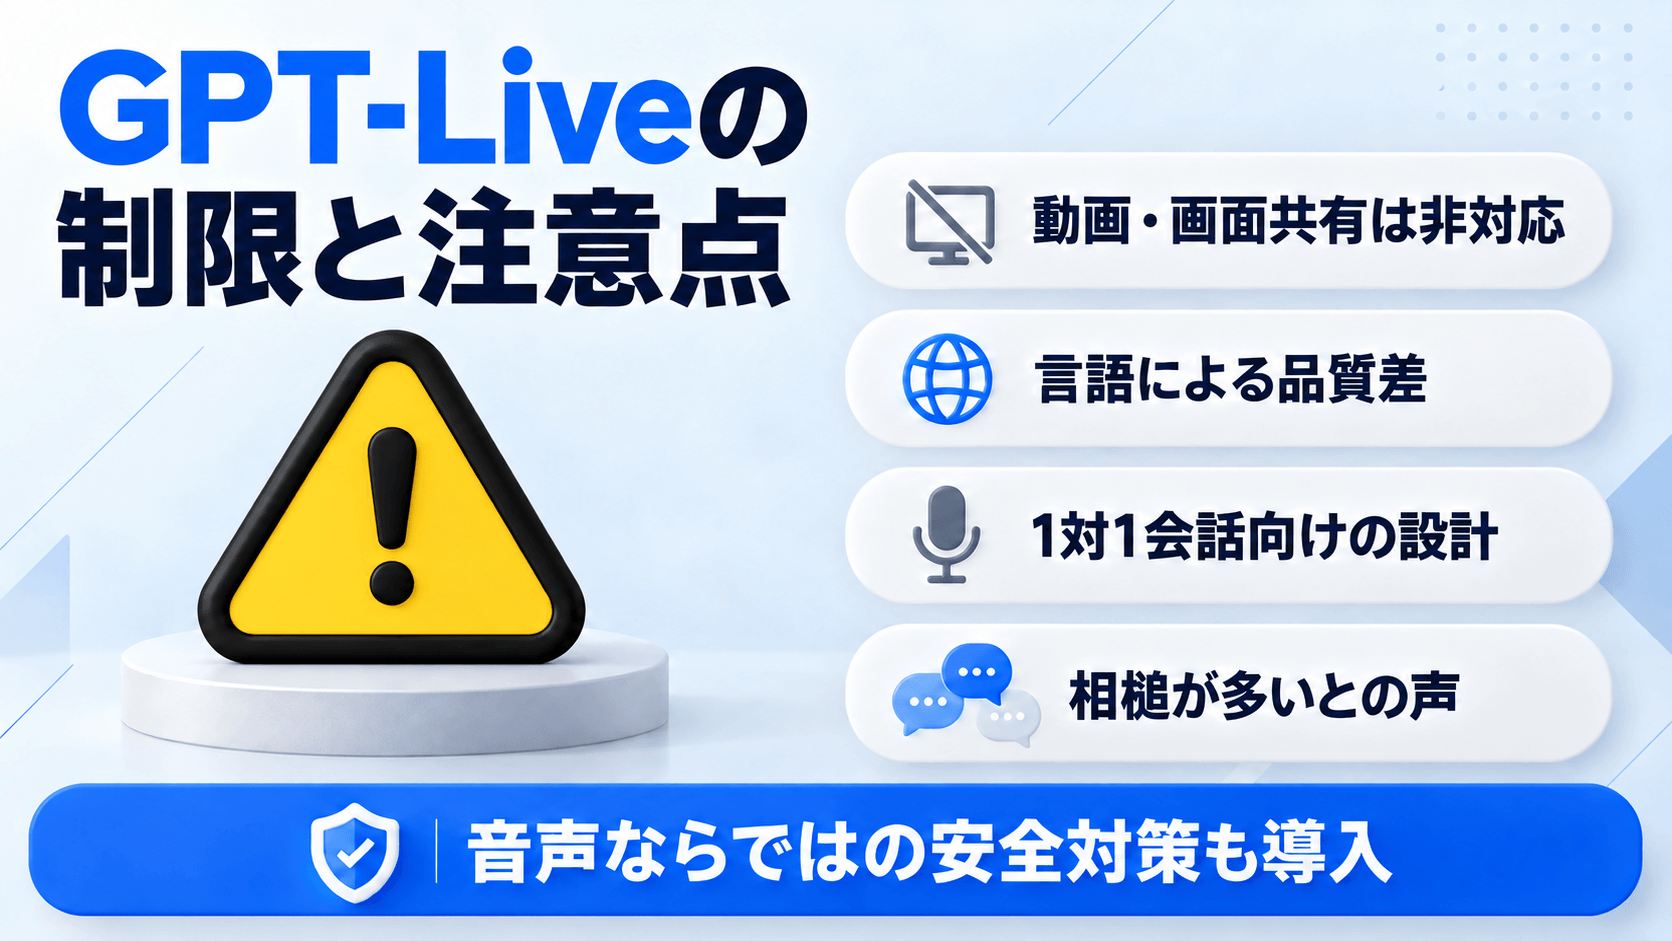
| 制限事項 | 内容 |
| ①動画・画面共有 非対応 | Liveでは動画や画面共有を使えません。動画・画面共有が必要な場合は、iOS・AndroidアプリでAdvancedに切り替えてください。プラグインは2026年9月23日のアップデートで対応済みのため、Liveのまま利用できます。 |
| ②言語による品質差 | GPT-LiveはChatGPTでよく使われる言語向けに最適化されており、言語によっては非ネイティブのアクセントや流暢さの不足が生じる可能性があります。 |
| ③1対1会話向けの設計 | Liveは基本的に1対1の会話を想定した設計です。背景ノイズには対応できるものの、複数話者の環境には最適化されておらず、人同士が話している声に反応してしまうことがあります。議事録用途を考えている方は注意してください。 |
| ④相槌の多さへの指摘 | 初期のユーザーからは、相槌が多すぎてかえって会話の邪魔になる、という声も一部で報告されています。ここは公式の見解ではなく、あくまで利用者の感想として捉えてください。 |
音声会話はリアルタイムで進むため、OpenAIは音声に固有の安全対策を用意しています。
危険な出力を検知した場合には、より安全な応答へ誘導する、支援リソースを表示する、リスクの高い場面では音声会話を終了する、といった仕組みが働きます。自傷に関する会話では、専門家が監修したクライシスヘルプラインの案内が行われます。
10代のユーザー向けには、年齢に応じた振る舞いをモデルに直接学習させました。保護者はペアレンタルコントロールで子どもの利用可否を決められ、自傷や自殺の意図が疑われる高リスクな状況では連携した保護者に通知が届く場合もあります。実在する人物の声を模倣しないための安全対策も導入済みです。
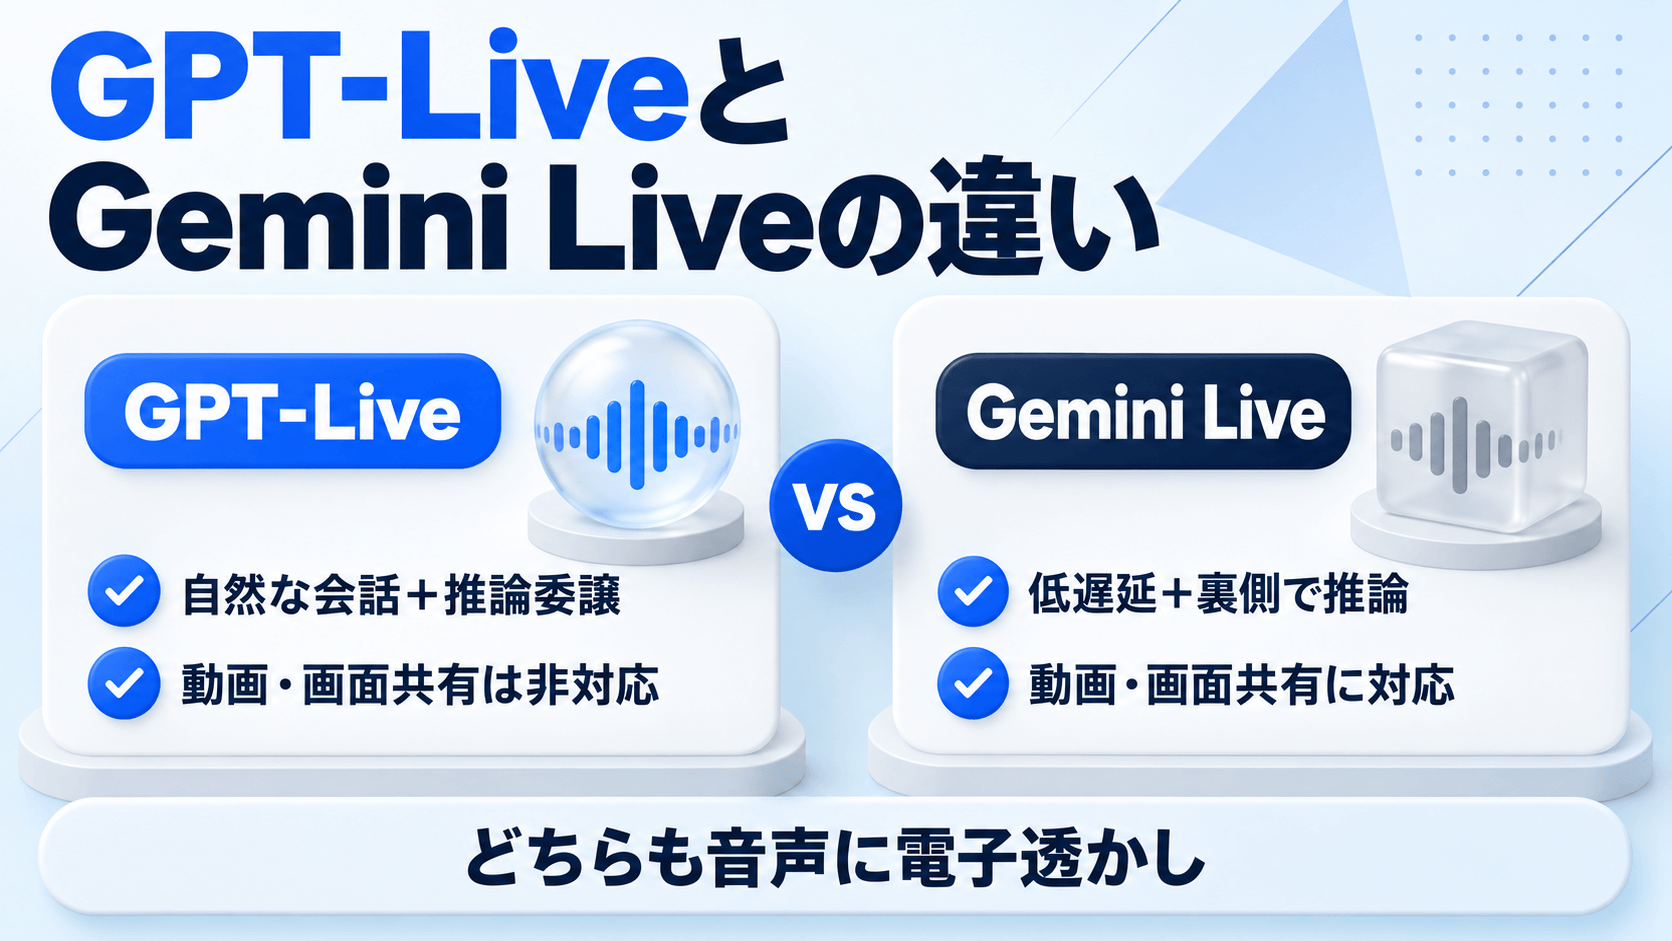
リアルタイム音声AIの分野では、GoogleのGemini Liveが先行してきました。両者は「聞きながら話す」自然な会話という目標こそ共通しているものの、強みの置きどころが異なります。
| 観点 | GPT-Live | Gemini Live(Gemini 3.8 Live/Extended Thinking) |
| 設計思想 | 会話の自然さ+裏側のフロンティアモデルへの委譲による「賢さ」 | 低遅延の対話を基本とし、会話を続けながらバックグラウンドでツール呼び出しや推論を行う |
| 動画・画面共有 | 非対応(2026年10月時点) | 対応 |
| 音声の電子透かし | SynthID(2026年7月31日〜) | SynthID |
| API | GPT-Live-1 API提供中(音声フロント層0.05ドル/分) | Live APIで一般提供中 |
Googleは2026年9月15日、Gemini 3.1 Flash Liveの後継としてGemini 3.8 Liveと推論を強化したGemini 3.8 Live Extended Thinkingを公開しました。
生成された音声にはSynthIDという電子透かしが埋め込まれます。OpenAIも2026年7月31日から、ChatGPT VoiceとAPIの音声にSynthIDを付与しており、AI音声の出所を確認できる仕組みは両者に共通しています。
現時点では「どちらが優れているか」を断じる段階にありません。動画や画面共有を伴う業務が中心ならGemini Live、会話の自然さと検索・推論の賢さを重視するならGPT-Liveというように、用途から選ぶのが現実的でしょう。
出典: リリースノート|Gemini API|Google AI for Developers
GPT-Liveについて、本記事の要点を振り返ります。
次のアクションはシンプルです。まず自社の契約プランを確認し、設定→音声からLiveを選べるかどうかを試してみてください。そのうえで、音声クリップの保持期間と学習利用の設定を、社内の情報セキュリティ規程と照らし合わせましょう。
アイスマイリーでは、生成AI のサービス比較と企業一覧を無料配布しています。課題や目的に応じたサービスを比較検討できますので、ぜひこの機会にお問い合わせください。
はい、Freeプランでは、GPT-Live-1 miniを制限付きで利用できます。Goプランでは、GPT-Live-1 miniを24時間ローリングで3時間まで利用できます。Plusプランでは、上位モデルのGPT-Live-1を同じく3時間まで利用可能です。上限を超えると、プランに応じた追加課金や制限が発生する場合があります。
問題ありません。Liveは聞くことと話すことを同時に行えるため、割り込みや発話の継続に対応します。ただし発話の重なり、背景ノイズ、ネットワークの状況、マイク設定などが聞き取りに影響する場合があります。
利用できます。PCでは、chatgpt.comのVoice in ChatからGPT-Liveを利用できます。 一方、Windows・macOSのデスクトップアプリには、GPT-Live搭載のVoice in Chatとは別の「Voice in Desktop」が提供されています。どちらの体験を使っているか、混同しないよう確認してください。
表示されない場合は、契約プラン・ワークスペースの設定・地域・アプリのバージョン・ペアレンタルコントロールを順に確認してください。Web版でVoiceアイコンが表示されるかどうかを試すと、原因の切り分けに役立ちます。
おすすめしません。Liveは1対1の会話向けに設計されており、複数話者の環境には最適化されていないためです。なお、Voiceの文字起こしは逐語記録ではありません。会議の録音・議事録が目的であれば、専用の録音・文字起こしツールの利用を検討してください。
音声クリップは、チャットに表示される文字起こしとあわせて30日間保持されます。チャットを削除すれば、関連するクリップも30日以内に削除されます。
業務の課題解決に繋がる最新DX・情報をお届けいたします。
メールマガジンの配信をご希望の方は、下記フォームよりご登録ください。登録無料です。


FOLLOW US
SNSをフォローして、最新情報をチェックできます!


AI製品・ソリューションの掲載を
希望される企業様はこちら