


生成AI
最終更新日:2026/10/28
Jevとは、米TypeSafe AIが2026年9月に公開したAIモデルです。
Jevには、文章を書かずに「判断」だけを返すという珍しい特徴があります。「他のAI(LLM)と何が違うの?」「自社の業務に使える?」「どうやって使い始めればいいの?」と疑問を持つ方もいるでしょう。
本記事では、公式情報をもとにJevの仕組みや料金、使い方、注意点を解説します。企業が導入前に確認したいチェックポイントもまとめました。
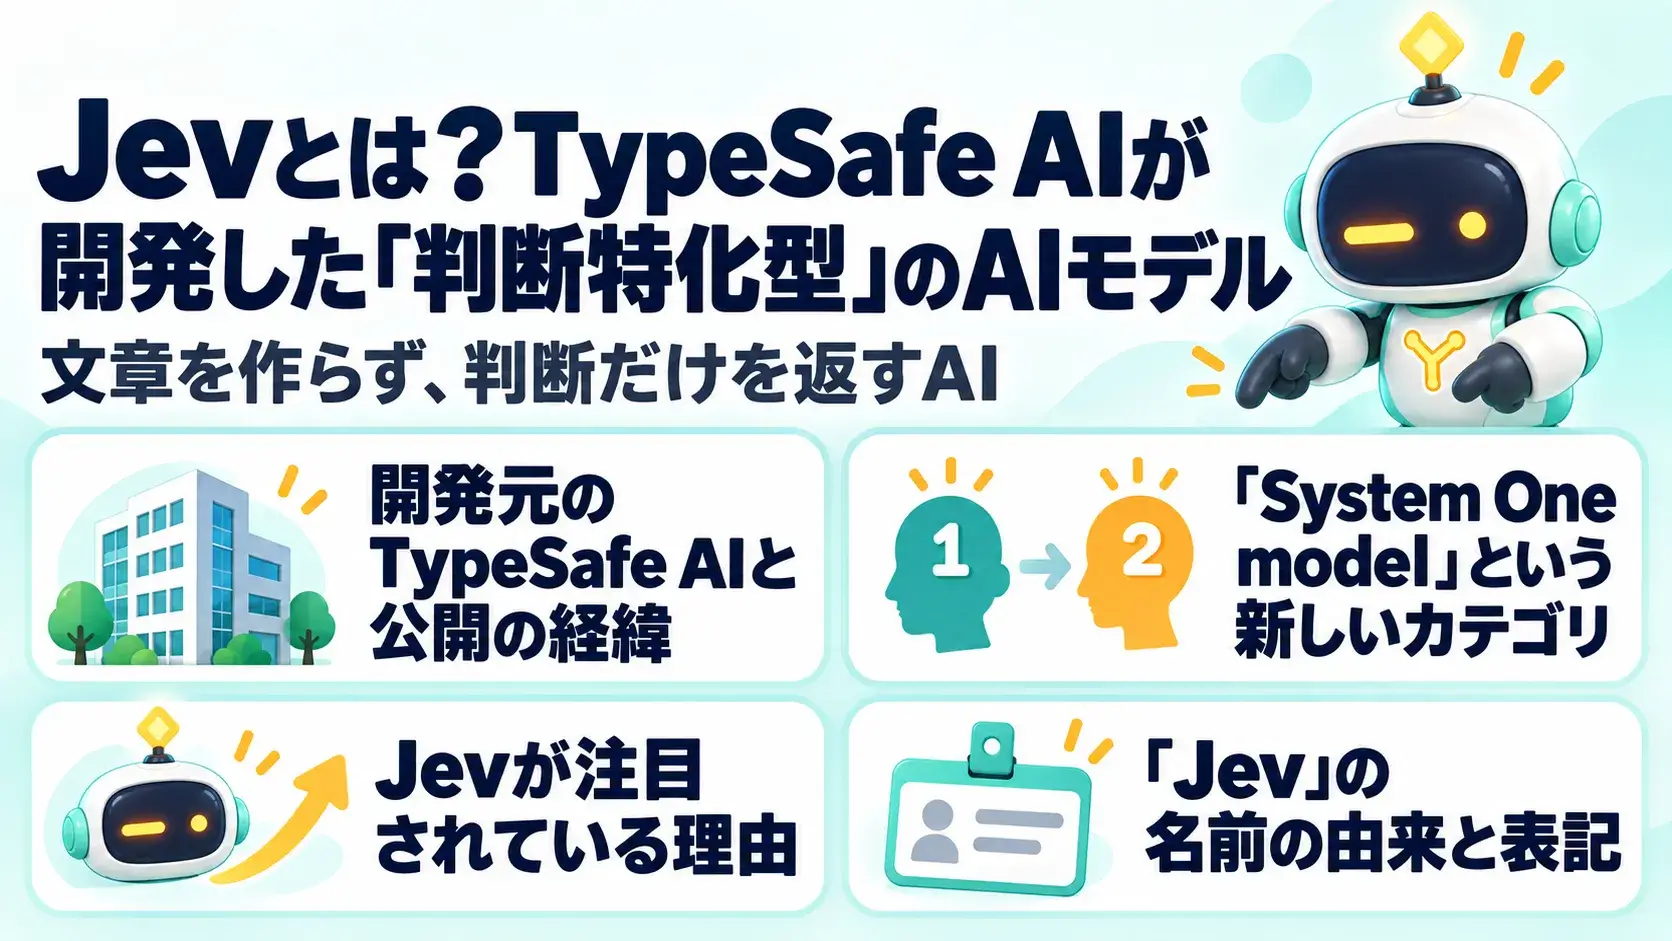
Jevは、文章を生成せずに「判断」だけを返すAIモデルです。米国のTypeSafe AIが開発し、2026年9月15日に早期アクセスの提供を始めました。
ChatGPTのような生成AIは、質問に対して文章で答えます。一方、Jevが返すのは、「どの選択肢か」「何段階目か」「Yesの確率はいくつか」といった、形式が決まった答えです。
公式は、Jevを「非構造の状態を入れると、型付きの確率的な判断が返る」ものと説明しています。ここでいう「型付き」とは、答えの形式があらかじめ決まっていることを指します。
たとえば、届いた問い合わせを「請求」「技術」「営業」のどの部署に回すかを決める場面を考えてみましょう。Jevは、選んだ部署とその確率を数値で返します。プログラムはその値を受け取り、そのまま振り分けの処理に使えます。
つまりJevは、人と会話するためのAIではありません。システムの中で、小さな判断を大量かつ高速にこなすためのAIです。
Jevの基本情報を、以下の表にまとめました。
| 項目 | 内容 |
| 開発元 | TypeSafe AI(米国サンフランシスコ) |
| 公開日 | 2026年9月15日(早期アクセスの開始) |
| モデルの種類 | System One model(判断特化型) |
| 現行バージョン | jev-1.13.0 |
| 主な出力 | 選択(Choice)・段階評価(Score)・Yes/Noの確率(Noul) |
| 料金 | 入力100万トークンあたり0.042ドル、出力は無料 |
| 利用方法 | 公式コンソール、API、SDK、外部のAIゲートウェイ |
※TypeSafe AI公式ブログ・公式ドキュメント(2026年10月6日時点)に基づきます。
TypeSafe AIは、米国サンフランシスコに拠点を置くAI企業です。公式ブログによると、非公開で約2年にわたり研究開発を行った後、Jevを公開しました。
創業者でCEOを務めるのは、Diogo Almeida(ディオゴ・アルメイダ)氏です。公式サイトのチーム紹介では、RLHFとInstructGPTの共同開発者とされています。どちらも、ChatGPTやGPT-4の土台となった手法です。Google Brainでの経歴も掲載されています。
開発の出発点として、公式ブログには印象的な問いが記されています。「モデルは何年も前からチャットでは超人的なのに、自動化はどこにあるのか」という問いです。
会話は得意でも、ソフトウェアに組み込んで自動化に使うのは難しいという課題があります。この課題に応えるために生まれたのがJevだと言えるでしょう。
出典:Introducing System One Models & Jev|TypeSafe AI/Team|TypeSafe AI
TypeSafe AIは、Jevを「System One model(システム1モデル)」と位置づけています。Jevは、このカテゴリで最初のモデルです。
名前の由来は、行動経済学者ダニエル・カーネマンの著書『ファスト&スロー』にあります。同書は、人間の思考を2つに分けて説明しています。速く直感的な「システム1」と、遅く熟考する「システム2」です。
例えるなら、時間をかけて文章を組み立てるLLMは「システム2」寄りの存在です。対してJevは、短時間で的を絞った判断を下す「システム1」の役割を担います。公式ドキュメントも、System Oneモデルの特徴を「速く、焦点を絞った判断」と説明しています。
出典:System One|TypeSafe Docs(2026年10月6日確認)
Jevが公開直後から注目を集めている背景の一つには、AIエージェントの普及があると考えられます。AIに業務を任せる場面が増えるほど、「次に何をするか」「この結果で進めてよいか」といった小さな判断の数も増えていきます。
こうした判断のたびにLLMを呼び出すと、待ち時間と費用がかさみがちです。Jevは、この課題に「判断だけを速く、安く返す」という答えを示しました。
開発者向けサービスでも、対応が速やかに進みました。公開翌日の2026年9月16日には、VercelがAI Gatewayでの提供を発表しています。Netlifyも、9月17日に対応を発表しました。
出典:TypeSafe AI’s Jev now available on AI Gateway|Vercel/TypeSafe Jev now available in AI Gateway|Netlify
モデル名のJevは、19世紀の経済学者ウィリアム・スタンレー・ジェヴォンズに由来します。蒸気機関の効率が上がった結果、石炭の需要はかえって増えました。公式ブログは、機械の知能も同じ道をたどると予想しています。
公式表記は、頭文字だけが大文字の「Jev」です。本記事では、検索キーワードの「JEV」と区別しながら説明します。
なお、2026年10月6日時点で、公式サイトや公式ドキュメントに読み方の記載は見当たりませんでした。以降、モデル名は「Jev」で統一します。
出典:Introducing System One Models & Jev|TypeSafe AI
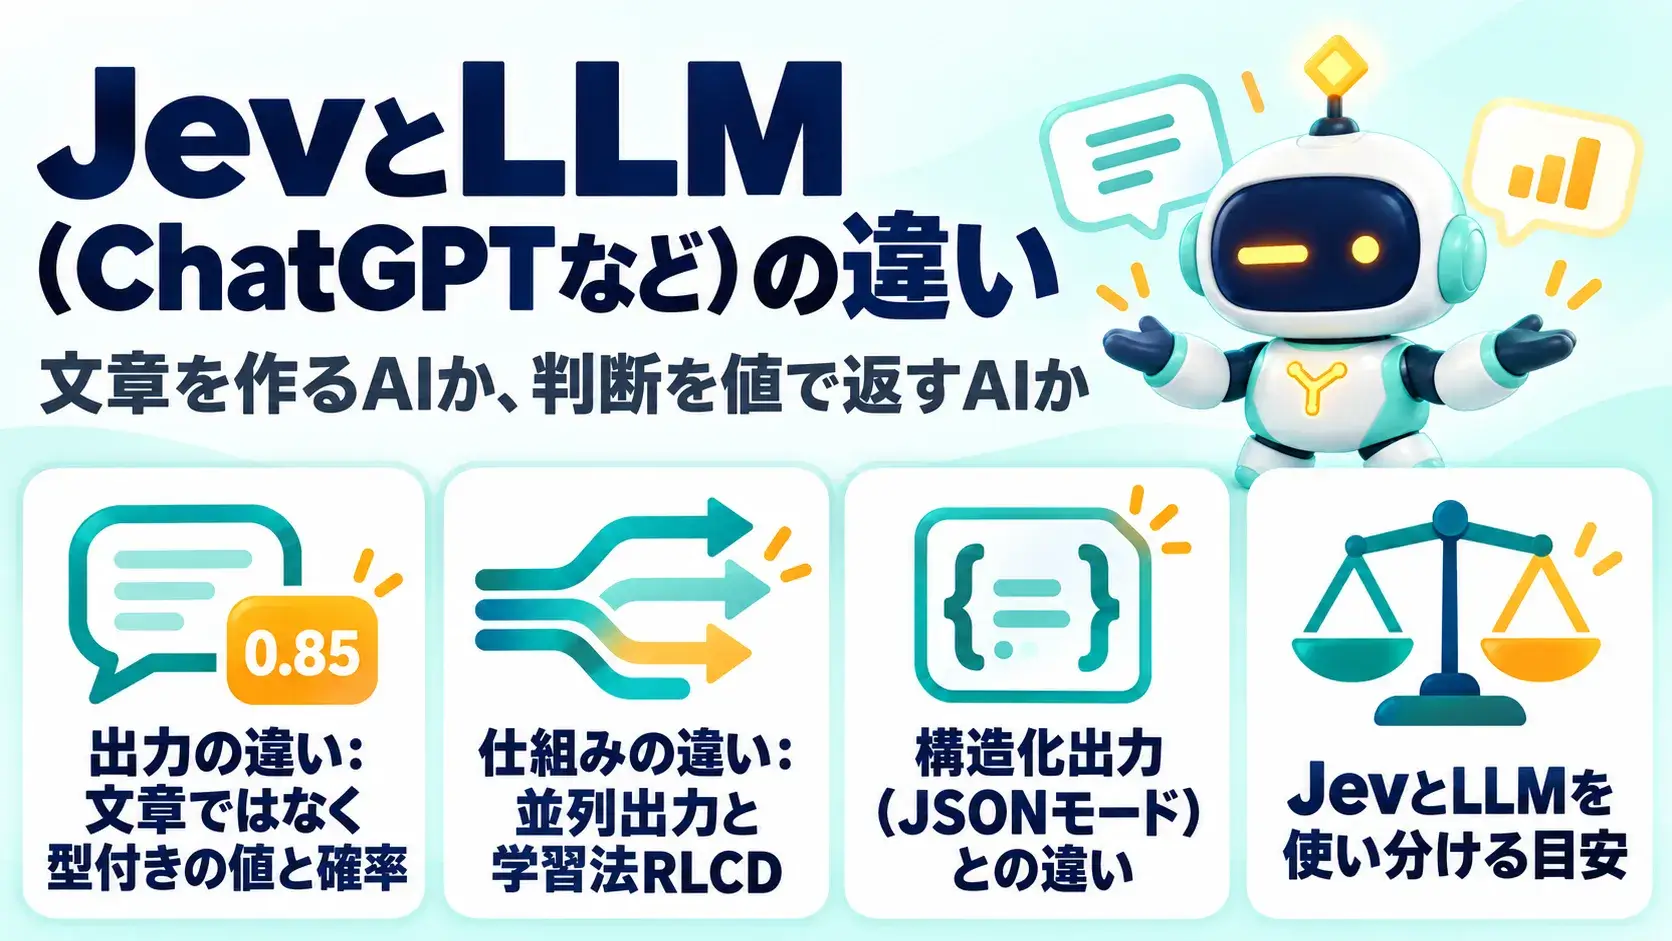
LLMが「文章を作るAI」なのに対し、Jevは「判断を値で返すAI」です。両者は競合するものではなく、役割の異なる道具と捉えるのが正確でしょう。
LLM(大規模言語モデル)とは、大量の文章を学習し、人間のように文章を生成するAIです。ChatGPTなどのサービスでは、LLMが文章生成や対話に使われています。Jevとの主な違いを、以下の表にまとめました。
| 比較項目 | LLM(ChatGPTなど) | Jev |
| 出力 | 文章(自由な文字列) | 型の決まった値と確率 |
| 得意な仕事 | 文章作成・要約・対話・コード生成 | 分類・振り分け・採点・Yes/No判定 |
| 判断理由の説明 | 文章で説明できる | 返さない(値と確率のみ) |
| 応答時間 | 3〜329秒(公式ブログでの比較値) | 70〜500ミリ秒 |
| 料金体系 | 入力と出力の両方に課金されるのが一般的 | 入力のみ課金(出力は無料) |
| 形式の崩れ | 起こりうる(構造化出力の機能で抑えられる場合もある) | 定義した型の範囲外の値は返らない |
※TypeSafe AI公式ブログ・公式ドキュメント(2026年10月6日時点)に基づきます。応答時間は、TypeSafe AIが評価したタスクでの値です。
LLMは文章の生成に加え、決まった形式で判断結果を返す用途にも使えます。Jevは文章を生成せず、定義した質問に対する値と確率を返します。比較する際は、出力形式だけでなく、同じ判断タスクでの精度・応答時間・費用を確認しましょう。
Jevは、選択肢の名前や数値を答えとして返します。プログラムは、その値をそのまま条件分岐に使えます。
Jevが速い理由の一つは、答えの出し方にあります。LLMは、文章をトークン(単語や文字の断片)単位で1つずつ順番に生成します。一方、Jevは、1回の問い合わせですべての答えをまとめて並列に出力します。
もう一つの違いは、学習方法です。一般的なLLMは、RLHF(人間のフィードバックによる強化学習)などで「役に立つ文章」を学びます。一方、JevはRLCDという独自の学習方法を採用しています。正式名称は、Reinforcement Learning for Calibrated Decisionsです。
日本語にすると、「較正された判断のための強化学習」となります。ポイントは、出力する確率が、実際に正しく判断できる割合と合うように学習することです。たとえば、確率「90%」と答えた判断が、実際にも9割の割合で正しくなる状態が理想です。
確率が実態と一致していれば、「確率が低いものだけ人が確認する」といった運用を組みやすくなります。この性質は、後述する確信度の活用にもつながっています。
出典:Introducing System One Models & Jev|TypeSafe AI
LLMにも、決まった形式で出力させる「構造化出力」や「JSONモード」と呼ばれる機能があります。JSONとは、プログラムが扱いやすいデータ形式の一つです。
ただし、構造化出力を使っても、LLMは答えをトークン単位で順に生成します。出力トークンにも料金がかかる点は変わりません。
Jevは、判断を返すことだけを目的に設計されたモデルです。速度やコスト、確率の信頼性も含め、判断に最適化されている点が構造化出力との違いと言えます。
JevとLLMのどちらを使うべきか迷ったら、次の4つの観点で考えると判断しやすくなります。
| 観点 | Jevが向いている | LLMが向いている |
| 答えの形 | 選択肢や段階など、あらかじめ決められる | 自由な文章で答える必要がある |
| 理由の説明 | 不要、または記録したルールと人の確認で対応できる | 判断の理由を相手に伝える必要がある |
| 処理件数 | 大量の件数を繰り返し処理する | 件数は少なく、1件ごとの内容が重い |
| 速さ | 1秒未満の応答が求められる | 数秒〜数十秒待てる |
たとえば、問い合わせの部署への振り分けは、答えの形が決まっていて処理件数も多い仕事です。Jevに向いていると言えるでしょう。一方、「問い合わせへの返信文を書く」は文章が必要なため、LLMに任せるべき仕事です。
1つの業務の中には、Jevに向く部分とLLMに向く部分が混在していることがほとんどです。業務を細かく分け、それぞれに合った道具を選ぶ視点が欠かせません。
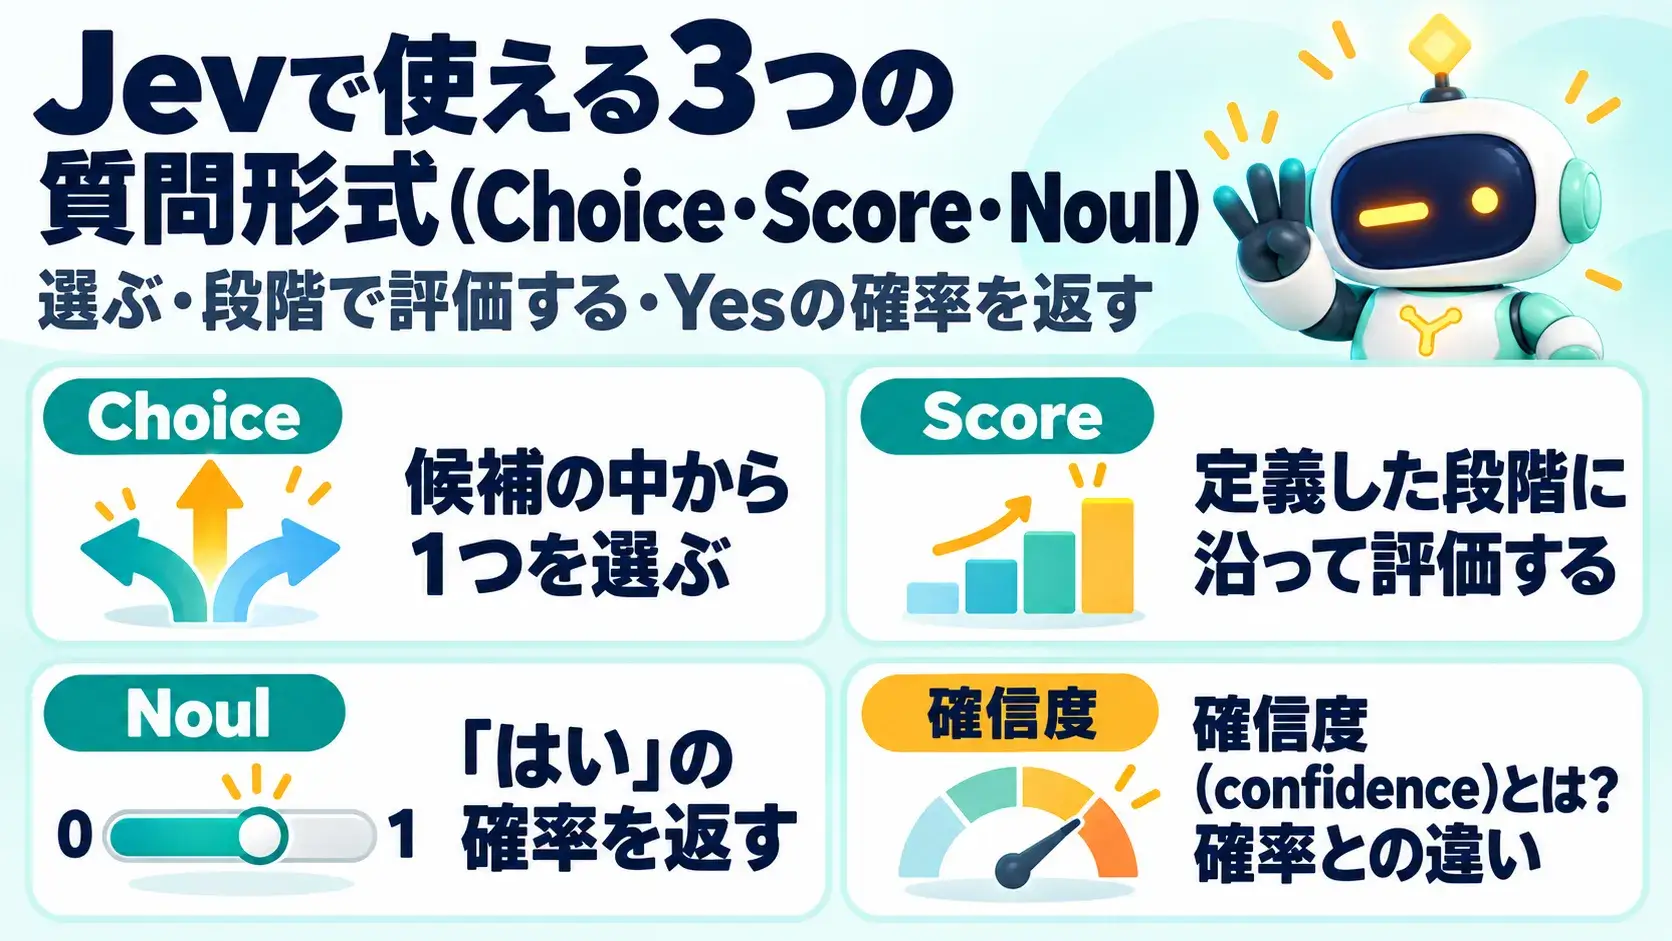
Jevへの問いかけは、「Choice」「Score」「Noul」の3種類に限られます。この3つを組み合わせて、業務上の判断を組み立てます。
Jevに渡すのは、判断の材料となる「状態(state)」と、それに対する「質問(questions)」の2つです。状態には、問い合わせの文面や申請内容などのテキストを入れます。
| 形式 | 問いの形 | 返ってくる値 | 業務での例 |
| Choice | どの選択肢に当てはまるか | 選んだ選択肢・確率・確信度 | 問い合わせを担当部署に振り分ける |
| Score | どの段階に当てはまるか | 確率で重み付けした段階の値・確率・確信度 | クレームの深刻度を3段階で評価する |
| Noul | この内容は正しいか | Yesの確率(0〜1) | 個人情報が含まれるかを判定する |
※TypeSafe AI公式ドキュメント(2026年10月6日時点)に基づきます。
3つの形式は、1回のAPI呼び出しの中で自由に組み合わせられます。APIとは、ソフトウェア同士が機能をやり取りするための窓口のことです。
複数の質問は、同じ状態に対して並列に評価され、それぞれの評価は互いに独立しています。公式ドキュメントによれば、質問を増やしても応答時間はほとんど変わりません。判断の観点が多い業務ほど、この特性が生きてくるでしょう。
Choiceは、あらかじめ用意した選択肢の中から1つを選ぶ質問です。選択肢は、1つの質問につき最大255個まで設定できます。
主な用途は、問い合わせの担当部署への振り分けや、書類の種類ごとの分類などです。各選択肢には「請求:支払いに関する問題」のように説明を付けられます。判断基準を言葉で明確に伝えられる点が便利です。
公式ドキュメントでは、想定外の入力に備えて「その他」の選択肢を入れることを推奨しています。どの選択肢にも当てはまらない内容が届いても、無理に振り分けずに済むためです。
Scoreは、あらかじめ定義した段階のうち、どの段階に当てはまるかを評価する質問です。段階は、2〜10段階の範囲で設定できます。
ポイントは、各段階の意味を自分で定義する点にあります。たとえば顧客の不満度なら、「0:落ち着いている」「1:不満がある」「2:強い怒りがある」のように定めます。
不具合の深刻度や、応募者のスキルレベルの評価などに向いている形式です。
注意したいのは、返ってくる値の形式です。Scoreは、各段階の確率で重み付けした値を返します。そのため、0・1・2の3段階を定義しても、1.43のような小数になる場合があります。最も確率が高い段階を、そのまま返す形式ではありません。
Noulは、「この内容は正しいか」というYes/Noの問いに、0〜1の確率で答える質問です。1に近いほど「はい」、0に近いほど「いいえ」の可能性が高いことを示します。
個人情報が含まれているかの確認や、返金を求める問い合わせかどうかの判定などに使えます。単純な「はい/いいえ」ではなく、確率で返される点が特徴です。
Noulでは、ChoiceやScoreのような確信度は別途返されません。確率そのものが、答えの確からしさを示しているためです。0.5付近の値は、モデルが判断に迷っている状態を表します。
出典:Primitives (Questions)|TypeSafe Docs/API Reference|TypeSafe Docs
ChoiceとScoreの答えには、「確信度(confidence)」という0〜1の数値が付きます。確信度は、返された確率から計算される指標です。
確率と確信度の違いは、次のように整理できます。
Choiceでは、選択肢の数と最も高い確率から確信度を算出します。最も高い確率が、全選択肢に均等に割り振った場合の値と同じなら、確信度は0です。1つの選択肢に100%集中していれば1になります。選択肢の数が同じであれば、最大確率が同じときの確信度も同じになります。
Scoreでは、段階同士の距離も計算に使います。最も確率の高い段階から離れた段階に、多くの確率が割り振られるほど、確信度は低くなります。Choiceとは算出方法が異なる点に注意しましょう。
また、確信度は「正解である確率」そのものではありません。確信度0.9は、その回答が90%の確率で正しいという意味ではありません。この点も押さえておきましょう。
業務では、この確信度を「人に回すかどうか」の判断に使えることが重要です。具体的な使い方は、後ほど「業務フローへの組み込み方」の章で紹介します。
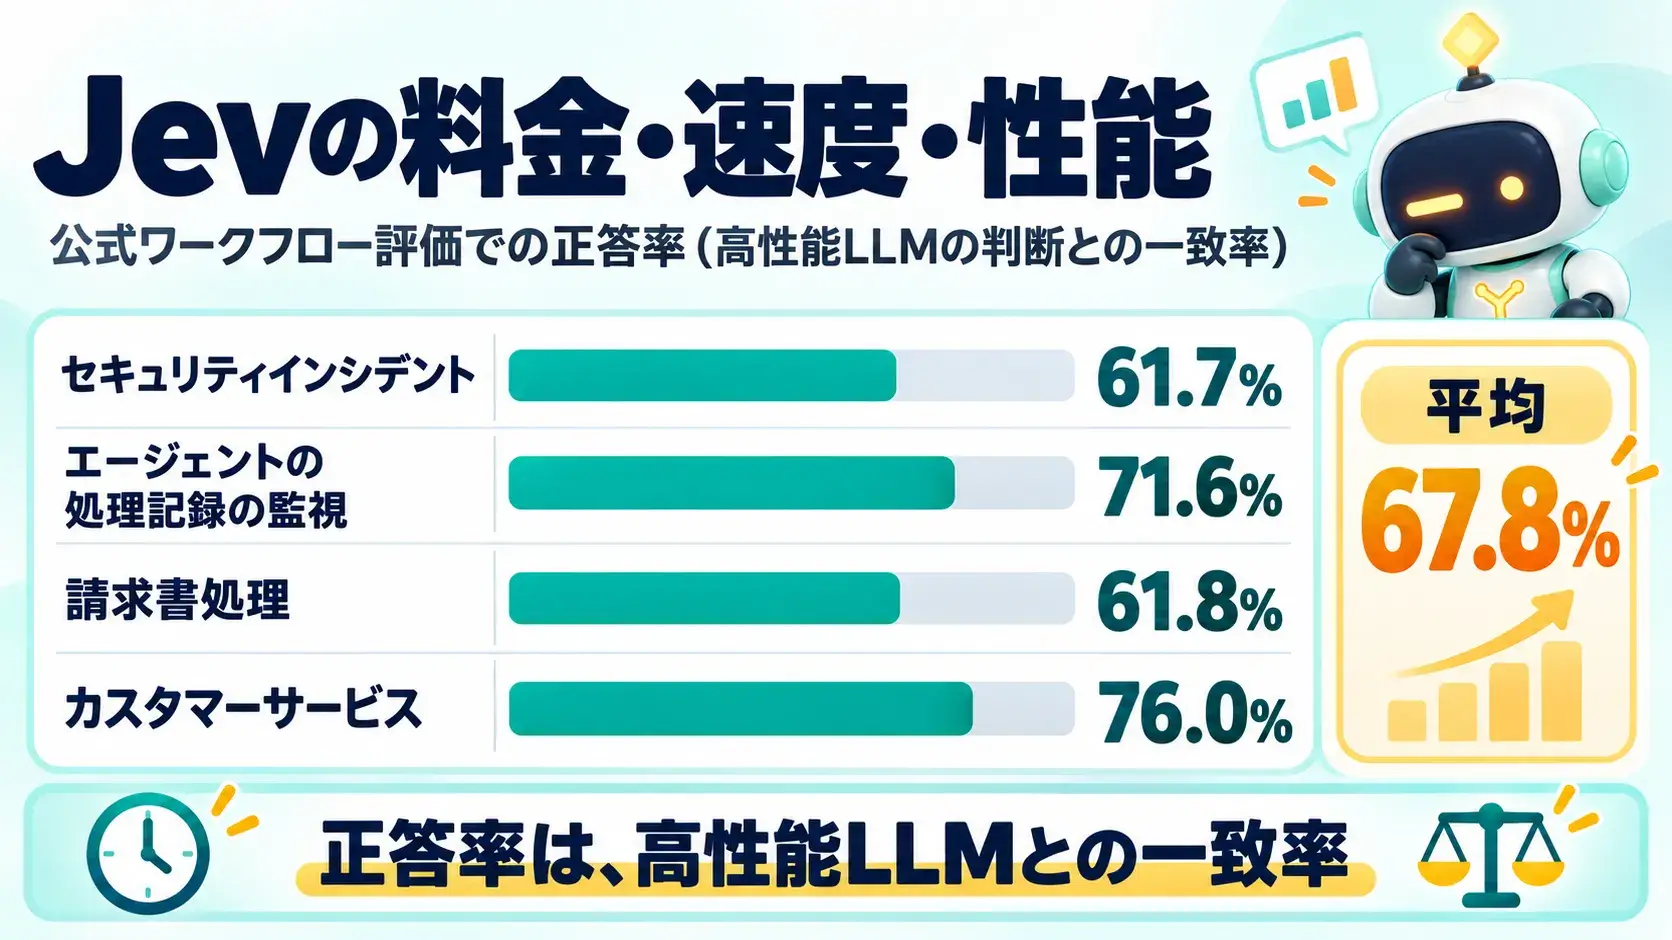
Jevの料金は、入力100万トークンあたり0.042ドルです。出力は無料で、応答時間は70〜500ミリ秒とされています。
トークンとは、AIが文章を処理するときの単位のことです。文章の長さが同じでも、トークンの数え方はモデルによって異なります。主な仕様を以下の表にまとめました。
| 項目 | 内容 |
| 入力料金 | 100万トークンあたり0.042ドル(10億トークンあたり42ドル) |
| 出力料金 | 無料 |
| 応答時間 | 70〜500ミリ秒 |
| 1リクエストの入力上限 | 64,000トークン(状態と最長の質問の合計は32,000トークンまで) |
| 入力できるデータ | テキストのみ(文字列・JSON・テキストの配列) |
| 現行モデル | jev-1.13.0(エイリアス:jev-latest) |
※TypeSafe AI公式サイト・公式ドキュメント(2026年10月6日時点)に基づきます。料金や条件は変更される可能性があるため、最新情報は公式サイトをご確認ください。
Jevは出力が無料のため、費用は「どれだけ入力したか」だけで決まります。見積もりの際は、判断材料の文章に加えて、質問文も入力量に含めておくと安心です。
具体的に試算してみましょう。1件あたりの入力を1,000トークンとし、月に10万件の問い合わせを判定するケースを考えます。
※公式の単価をもとにした編集部の試算です。実際のトークン数は、文章の長さや質問の数によって変わります。
この試算に含まれるのは、TypeSafe AIの直接APIの入力料金のみです。併用するLLMや外部サービス、システム開発・運用の費用は含みません。
それでも、10万件の判断にかかるJevの利用料は月数ドル程度に収まる計算です。大量の判断を低コストでこなせる点は、Jevの大きな強みと言えるでしょう。
公式サイトは、AnthropicのClaude Fable 5.1と入力単価を比べ、約238倍の差があると示しています。これは入力単価の比であり、業務全体の費用削減率ではありません。
Jevの速さについては、複数の数値が紹介されています。混同しやすいため、情報源と評価条件を整理しておきましょう。
| 数字 | 出どころ | 条件 |
| 40〜200倍速い | 公式ブログ | 判断系のタスクで、フロンティアLLMと応答時間を比較 |
| 193.6倍速い・444.6倍安い | 公式サイト | 業務ワークフローの評価でLLMと比較 |
| 70〜500ミリ秒 | 公式ブログ | Jevのエンドツーエンドの応答時間 |
※TypeSafe AI公式ブログ・公式サイト(2026年10月6日時点)に基づきます。
いずれも、TypeSafe AI自身が設計した評価に基づく数値です。公式ブログも、評価用のワークフローは自社のチームが作成したものであり、偏りが生じている可能性があると認めています。
自社の業務で同じ効果が出るとは限りません。あくまで参考値として受け止めるのが賢明です。
なお公式ブログでは、ゲーム「DOOM」をJevの判断で自動プレイするデモも紹介されています。このデモでは、画面の画像ではなく、ゲームの状態をテキストを含むデータとして渡しています。
出典:Introducing System One Models & Jev|TypeSafe AI/TypeSafe AI/Models|TypeSafe Docs
TypeSafe AIは、Jevの性能を4つの業務ワークフローで評価し、結果を公開しています。
評価では、2つの方式を比較しています。1つは、業務をプログラムのルールと小さな質問に分解する「workflow」方式です。もう1つは、1回の指示で業務全体を解かせる「prompt」方式です。下表には、Jevのworkflow方式での結果をまとめました。
| ワークフロー | 正答率 | 1件あたりコスト | 応答時間 |
| セキュリティインシデント | 61.7% | 0.0001ドル | 0.3秒 |
| エージェントの処理記録の監視 | 71.6% | 0.0003ドル | 0.5秒 |
| 請求書処理 | 61.8% | 0.0011ドル | 0.5秒 |
| カスタマーサービス | 76.0% | 0.0001ドル | 0.4秒 |
| 平均 | 67.8% | 0.0004ドル | 0.4秒 |
※TypeSafe AIのワークフロー評価(2026年10月6日時点)に基づきます。表はJevのworkflow方式の値です。
ここで注意したいのは、正答率の「正解」の決め方です。この評価では、高い推論設定で動かした2つの高性能LLMの回答を平均し、正解ラベルとして使っています。
つまり正答率は、「高性能LLMの判断とどれだけ一致したか」を示す数字です。「Jevは最上位のLLMと同じ精度を持つ」という意味ではありません。速さやコストの優位性と、判断の一致率とのバランスを見て、用途を決めるのが現実的でしょう。
第三者による評価も出始めています。2026年9月29日には、Jev(jev-1.13.0)を37のデータセットで評価した研究者のプレプリントが公開されました。プレプリントとは、査読を受ける前に公開される論文のことです。
報告によると、Choiceの確率はよく較正されていました。一方、Yes/Noの確率については、固定値の0.5で区切るよりも、データに合わせて調整したしきい値を使うほうが有効だったとされています。
ただし、公式評価とは条件が異なり、自社業務での性能を保証する結果ではありません。Noulを使う場合は、自社データでしきい値を決める参考として受け止めるとよいでしょう。
出典:Evaluating and Benchmarking the System One Model Jev|arXiv
Jevについては、「ハルシネーションしない」という説明をよく見かけます。ハルシネーションとは、AIが事実と異なる内容をもっともらしく出力してしまう現象のことです。
公式ブログでも、Jevは「ハルシネーションできない」と説明されています。ただしこれは、「定義した型や選択肢の外にある値が返らない」という意味です。たとえば「請求・技術・営業」から選ぶ質問に、「人事」という答えが返ることはありません。
一方で、「技術」と答えるべき問い合わせに「請求」を選んでしまう可能性は残ります。形式の正しさと、判断の正しさは別のものです。この違いを理解したうえで、運用を設計しましょう。
出典:Introducing System One Models & Jev|TypeSafe AI
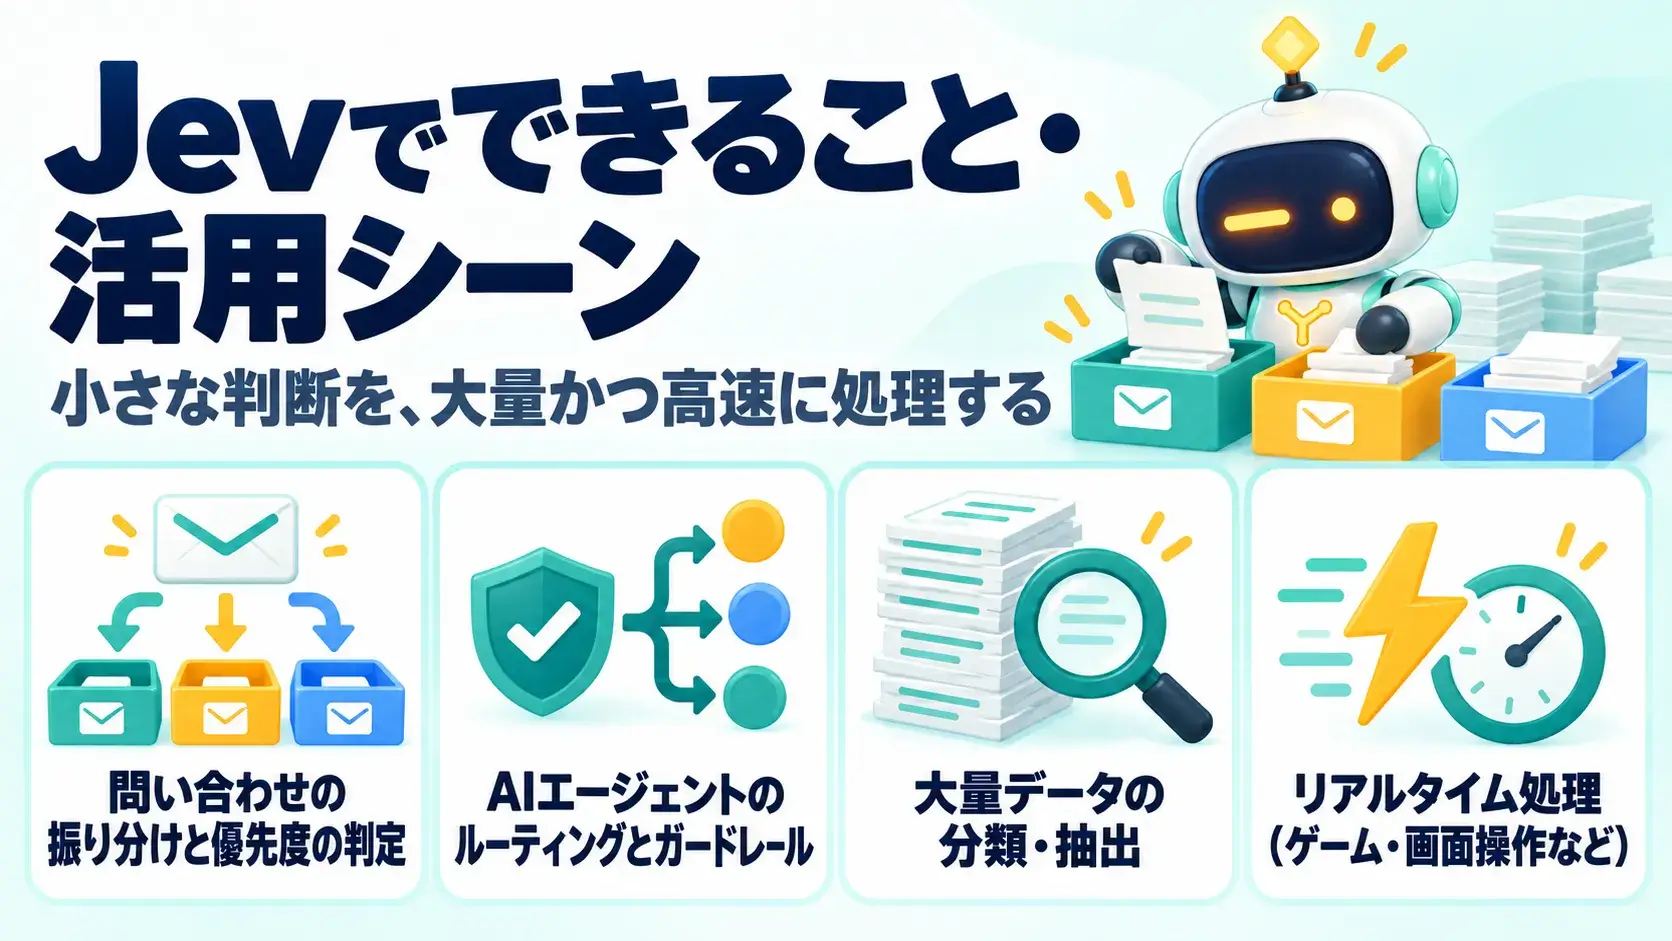
Jevが力を発揮するのは、人が1件ずつ行っている「小さな判断」を、大量かつ高速に処理する仕事です。反対に、文章の作成や判断理由の説明が必要な仕事には向きません。
公式ドキュメントには、幅広い活用例が挙げられています。たとえば検索、モデルの振り分け、採用、見込み顧客の獲得、カスタマーサポートなどです。保険金請求や金融犯罪対策、法務・コンプライアンスといった分野も含まれます。
これらをもとに、部署別の活用イメージを整理しました。
| 部署・業務 | Jevに任せる判断の例 | 使う質問形式 |
| カスタマーサポート | 問い合わせの担当部署・緊急度の判定 | Choice、Noul |
| 営業・マーケティング | 見込み顧客の優先度づけ | Score |
| 人事・採用 | 応募書類の評価項目ごとの採点 | Score |
| 法務・コンプライアンス | 規約違反や個人情報の有無の確認 | Noul |
| EC・プラットフォーム | 投稿や出品の審査(モデレーション) | Choice、Noul |
| 情報システム | AIの出力チェック(ガードレール) | Noul |
※公式ドキュメントの活用例をもとに、編集部が部署別に整理したものです。実際の精度や削減効果は、自社のデータで確認する必要があります。
最も分かりやすい活用例が、問い合わせ対応です。たとえば「サブスクリプションの料金が二重に請求されている」という問い合わせが届いたとしましょう。
Jevには、1回の呼び出しで次の3つの質問をまとめて送れます。
返ってきた値をもとに、プログラムが請求担当へ自動で転送します。緊急度が高ければ、優先して対応する問い合わせの列に加えることも可能です。担当者が1件ずつ読んで振り分ける手間を、大きく減らせるでしょう。
AIエージェントとは、目的に向けて自ら手順を考え、ツールを使いながら作業を進めるAIです。エージェントは処理の途中で、「次にどのツールを使うか」「この結果で先に進んでよいか」といった判断を何度も繰り返します。
こうした細かな判断をJevに任せると、処理全体の速度を上げ、費用を抑えられる可能性があります。公式も、モデルの振り分け(ルーティング)や情報検索の補助などを活用例に挙げています。
もう一つの用途は、ガードレールです。ガードレールとは、AIの入力や出力に問題がないかを確認する安全装置を指します。公式の実装例集(クックブック)では、LLMへの入力や出力を検査する例が紹介されています。脱獄(ジェイルブレイク)を狙う入力や有害な依頼を見つける、といった使い方です。
ただし、Jevによる検査にも誤判定はあります。単独で安全性を保証する仕組みとしては扱わず、ほかの対策と組み合わせましょう。
出典:Example Use Cases|TypeSafe Docs/Guardrails for LLMs|TypeSafe Docs
公式は、Jevの使い道の一つを「ビッグデータに対するAIのマップリデュース」と表現しています。大量の文書を1件ずつ判定し、分類したり絞り込んだりする処理のことです。
たとえば、過去の問い合わせ履歴を数十万件まとめて分類し、傾向を分析するといった使い方が考えられます。公式のクックブックでは、75の業種グループに分類する例も公開されています。この例では、確信度が低いものを別の処理に回す工夫も紹介されています。
出力が無料のJevは、件数が多い処理ほどコスト面の利点が出やすくなります。これまで費用の面でAIを使えなかった大量処理も、活用の候補になるでしょう。
応答の速さを生かし、即時性が求められる場面で使えるのもJevの特徴です。公式の活用例では、ゲームや画面に組み込まれたUIでの判断が挙げられています。
公式ドキュメントには、スマートホームへの依頼をJevで処理するデモも掲載されています。家電の操作など、利用者を待たせられない場面での活用をイメージしやすい例です。
ゲームや画面操作に使う場合も、Jevが直接画像を読むわけではありません。ゲームの状態や操作の候補を、テキストや構造化データにして渡します。
出典:Example Use Cases|TypeSafe Docs/Introducing System One Models & Jev|TypeSafe AI
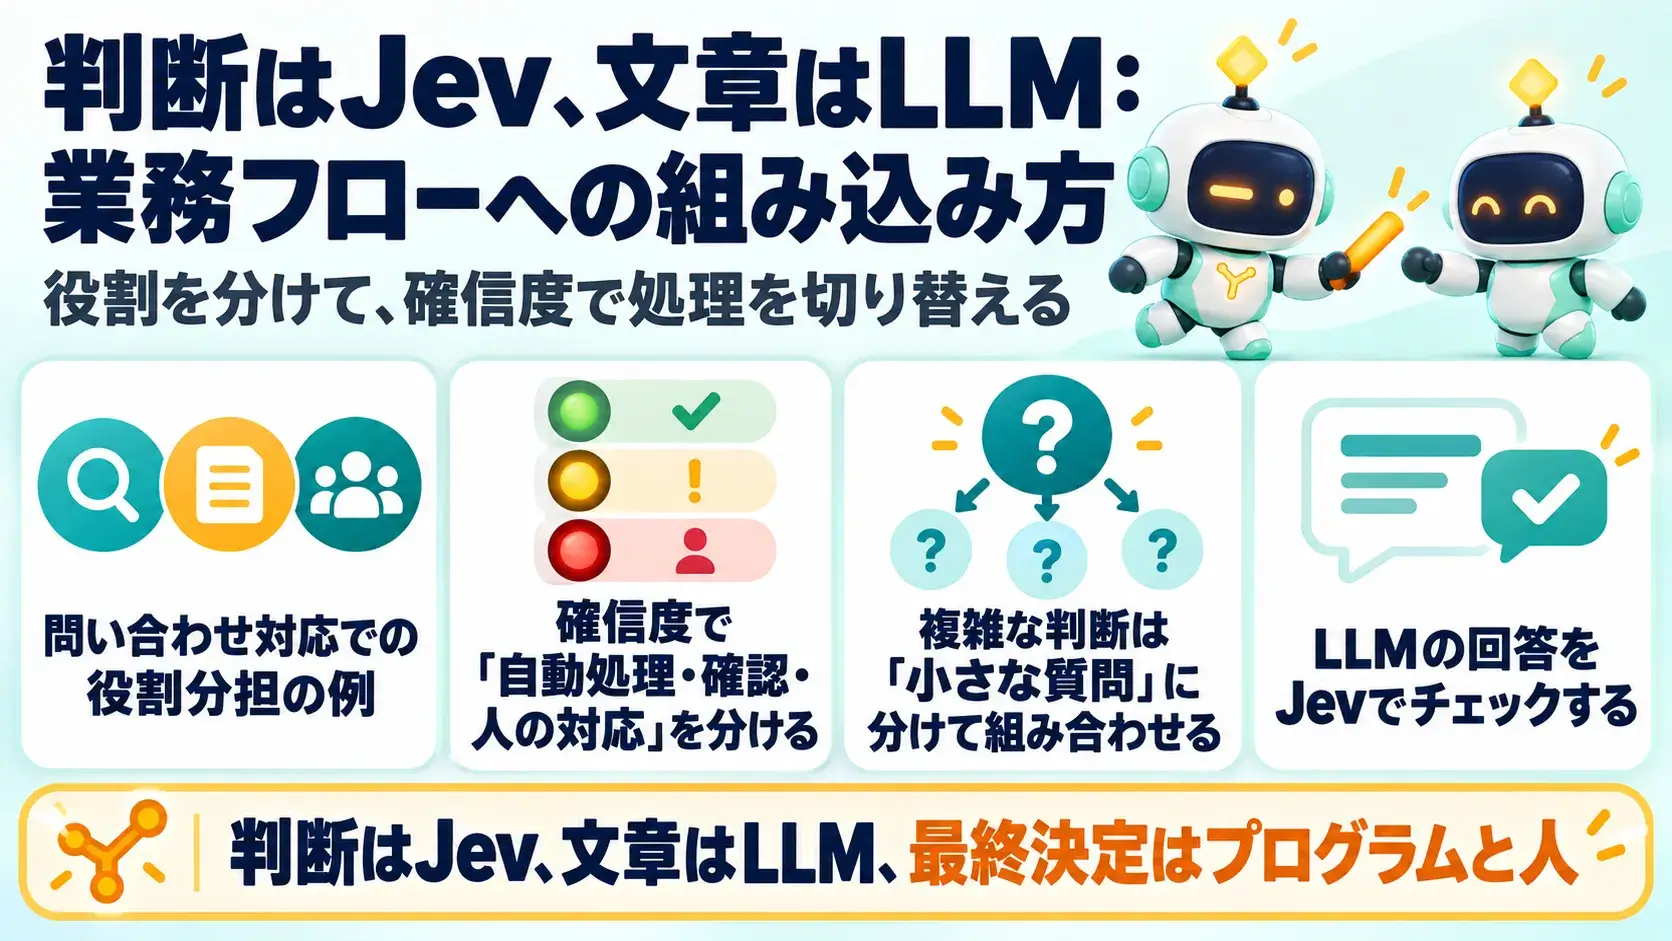
Jevは、単体で業務を完結させる道具ではありません。「判断はJev、文章はLLM、最終決定はプログラムと人」と役割を分けて使うのが基本です。さらに、確信度の高さに応じて、自動処理するか、人が確認するかを分けます。
公式ドキュメントも、Jevを「プログラムの中から呼び出す判断部品」として使うよう案内しています。ここでは、業務フローへの具体的な組み込み方を見ていきましょう。
問い合わせ対応を例に、Jev・LLM・人の役割分担を整理すると次のようになります。
Jevは判断の理由を返しません。LLMは、確認済みの事実や業務ルールをもとに返信文を作成できます。ただし、その文章を、Jevが判断した実際の理由として扱うことはできません。
説明責任がある業務では、入力情報・判定結果・適用したルールを記録しておきましょう。そのうえで、顧客に伝える説明を人が確認する仕組みにしておくと安全です。
公式ドキュメントでは、確信度に応じて処理を分ける「Confidence-Gated Routing」というパターンを紹介しています。これは、操作のリスクに応じて、必要な確信度の基準(しきい値)を変える考え方です。
公式の例は、音声で操作する銀行サービスです。残高照会のようにリスクの低い操作と、送金の承認のようにリスクの高い操作とで、基準を分けています。
| 確信度 | 残高照会(低リスク) | 送金の承認(高リスク) |
| 0.6未満 | 担当者に回す | 担当者に回す |
| 0.6〜0.85 | 自動で実行する | 利用者に確認する |
| 0.85超 | 自動で実行する | 自動で実行する |
※公式ドキュメントに掲載された実装例です。0.6や0.85は、正答率や安全性を保証する基準ではありません。実際のしきい値は、自社データでの検証と業務のリスクに応じて設定してください。
残高照会は、間違えても影響が小さい操作です。一方で送金は、誤ると大きな損失につながります。このように、取り返しのつかない操作ほど、高い確信度を求めることがポイントです。
公式も、しきい値は業務のリスクや許容度に応じて人が決めるものだとしています。まずは厳しめの基準で始め、実績を見ながら調整するとよいでしょう。
出典:Confidence-Gated Routing|TypeSafe Docs/Confidence|TypeSafe Docs
Jevに複雑な判断をさせたいときは、1つの質問に多くの条件を詰め込まないことが大切です。公式ドキュメントは、判断を単純な質問に分解し、結果をプログラムで組み合わせる方法を推奨しています。
公式が紹介する「Composite Scoring」の例は、エンジニアの採用選考です。まず、応募者を次の4つの観点で個別に採点します。
採点は、それぞれ0〜4の5段階です。そのうえで、職種ごとに重みを変えて合計点を計算します。
| 観点 | 上級エンジニア向けの重み | エンジニアリングマネージャー向けの重み |
| Pythonの習熟度 | 40% | 15% |
| チームを率いた経験 | 10% | 40% |
| システム設計の力 | 40% | 20% |
| 未知の分野を学ぶ力 | 10% | 25% |
※TypeSafe AI公式ドキュメントの例(2026年10月6日時点)をもとに作成しています。
観点ごとに採点しておけば、重みを変えるだけで別の職種にも使い回せます。どの観点で点数が伸びなかったのかも分かるため、判断の透明性を保ちやすいという利点もあります。
出典:Composite Scoring|TypeSafe Docs/Jev with Coding Agents|TypeSafe Docs
JevはLLMの「前」だけでなく、「後」に置く使い方もできます。LLMが作った回答に問題がないかを、Jevで確認する方法です。
公式は、これを「Universal Verification(あらゆるAIの検証)」という活用例として紹介しています。LLMへの入力や抽出結果、推論の過程、ツールの呼び出しなどを、低コストで検査するという考え方です。
公式のクックブックには、LLMの回答に含まれる引用を検証する例もあります。引用が元の資料に本当にあるか、主張を裏付けているかを確かめる使い方です。
RAGの仕組みにも応用できます。RAGとは、社内文書などを検索し、その内容をもとにLLMに回答させる仕組みのことです。公式では、検索で集めた文書を回答用のLLMに渡す前に、Jevで採点・選別する例を紹介しています。関連性や有用性に加え、プロンプトインジェクションの危険性も判定の観点に含まれています。
LLMの出力を人がすべて確認するのは大きな負担です。Jevによる自動チェックを挟めば、人が確認すべき回答を絞り込める可能性があります。ただし、チェックにも誤判定はあるため、見逃しがゼロになるわけではありません。
出典:Example Use Cases|TypeSafe Docs/Double-checking citations|TypeSafe Docs/Classifying RAG Passages|TypeSafe Docs
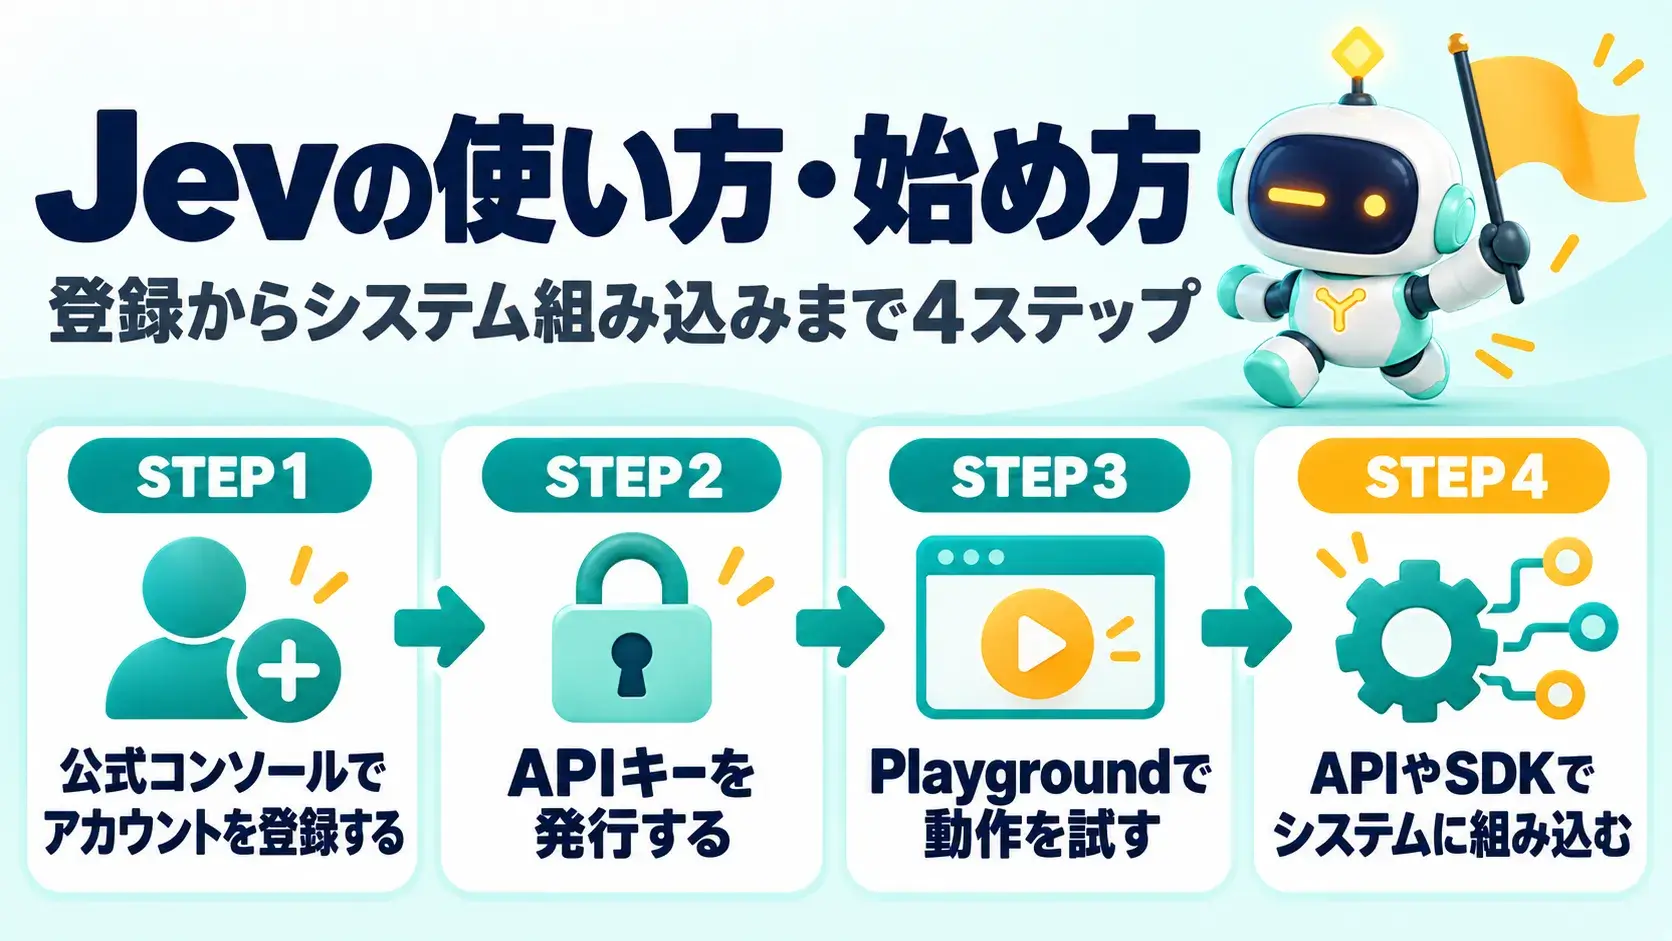
Jevは、公式コンソールでアカウントを作成し、APIキーを発行して使う仕組みです。利用方法は、ブラウザ上のPlayground、API、SDKの3つです。
基本的な流れを、次の4つのステップで紹介します。
APIキーとは、APIを利用する際に本人確認に使う文字列のことです。SDKは、特定のプログラミング言語からAPIを使いやすくするための道具一式を指します。
利用開始の手順は、公式コンソール(console.typesafe.ai)で確認できます。公式ドキュメントでは、コンソールのダッシュボードからAPIキーを発行する方法が案内されています。
なお、公式サイトではJevを早期アクセスとして案内しています。登録の受付状況や無料クレジットの有無は、申し込み時の表示をご確認ください。
出典:Quick start|TypeSafe Docs/TypeSafe AI
プログラミングをせずに試したい場合は、コンソール内のPlaygroundを使いましょう。ブラウザ上で判断材料の文章と質問を入力すると、Jevの答えを確認できます。
自社の問い合わせ文などを入れて、確率や確信度がどう返るかを見てみるのがおすすめです。PoC(概念実証)に進む前に、Jevの得意なことや苦手なことを把握できます。
本格的にシステムへ組み込む場合は、APIかSDKを使います。APIを使う場合は、専用のエンドポイントにリクエストを送ります。送り先のURLは「https://api.typesafe.ai/v1/systemone」です。モデルには「jev-latest」を指定します。
Pythonで使う場合は、公式のPython SDK(typesafe-sdk)を使うと手軽です。Python 3.10以上の環境で「pip install typesafe-sdk」を実行すると導入できます。APIキーは、環境変数「TYPESAFE_API_KEY」から自動で読み込まれます。
公式クイックスタートをもとにした、最小限のコード例は次のとおりです。問い合わせ文が緊急性を伝えているかを、Noulで判定しています。
Python
from typesafe_sdk import Noul, TypeSafeClient

client = TypeSafeClient()  # 環境変数 TYPESAFE_API_KEY を読み込む

response = client.system_one(
    state="本日中に請求書の再発行をお願いできますか。",
    questions={
        "urgency": Noul(instructions="このメッセージは緊急性を伝えているか"),
    },
)

print(response.answers["urgency"].noul)
実行すると、緊急性があると判断した確率を0〜1で確認できます。返り値は、質問IDの「urgency」を指定して取り出します。
JavaScript・TypeScript向けのSDKも用意されています。詳しい使い方は、公式ドキュメントのSDKのページを参照してください。
なお「jev-latest」は、最新の安定版を指す別名(エイリアス)です。新しいバージョンが出ると、この別名が指すバージョンも切り替わります。本番運用では「jev-1.13.0」のようにバージョンを直接指定すると、更新による挙動の変化を避けやすくなるでしょう。
出典:Quick start|TypeSafe Docs/Client SDKs|TypeSafe Docs/Models|TypeSafe Docs
Jevの判断の精度は、質問の書き方に大きく左右されます。公式ドキュメントの推奨事項と既知の弱点を踏まえると、次の点を意識するとよいでしょう。
たとえば「緊急で、かつ返金を求めていないか」と1問で聞くと、条件が絡み合って読み違えが起きやすくなります。この場合は「緊急か」「返金を求めているか」の2問に分けましょう。2つの答えを組み合わせた判断は、プログラム側で行います。
質問の書き方を変えたら、同じデータで再度テストし、精度が上がったかを確かめることも大切です。この改善の繰り返しが、Jevを業務で使いこなす近道になります。
出典:Primitives (Questions)|TypeSafe Docs/Jev 1.13 Jaggedness|TypeSafe Docs
Jevは、TypeSafeの公式APIだけでなく、外部のAIゲートウェイ経由でも利用できます。AIゲートウェイとは、複数のAIモデルを1つの窓口からまとめて利用できるサービスのことです。
Vercelは2026年9月16日、自社のAI GatewayでJevの提供を開始しました。9月21日には、TypeSafeの公式SDKやHTTP APIからの利用にも対応しています。料金はAI Gateway経由で請求されますが、TypeSafeのAPIキーを持ち込み、直接支払う方法も案内されています。
Netlifyも、2026年9月17日に自社のAI GatewayでJevの提供を発表しました。利用料はNetlifyのクレジットから差し引かれる仕組みです。すでにこれらのサービスを使っている企業なら、導入の手間を減らせるでしょう。
出典:TypeSafe AI’s Jev now available on AI Gateway|Vercel/AI Gateway now supports TypeSafe clients and an HTTP API for Jev|Vercel/TypeSafe API with AI Gateway|Vercel Docs/TypeSafe Jev now available in AI Gateway|Netlify
TypeSafe AIは、Claude Codeなどのコーディングエージェント向けのスキルを提供しています。このスキルを導入すると、エージェントはJevのAPIの使い方を理解したうえでコードを書けるようになります。
Claude Codeの場合は、プラグインとして追加する方法が案内されています。そのほかのコーディングエージェントにも、コマンド1つで導入できる手順が用意されています。導入方法は複数あります。公式ドキュメントでは、重複して導入しないよう注意を促しています。この点も覚えておきましょう。
ただし、JevはClaude CodeやCursorの裏側で動くLLMの代わりにはなりません。公式ドキュメントもこの点を明記しています。Jevは、文章もコードも書けないためです。
正しい使い方は、コーディングエージェントにJevを呼び出すプログラムを書かせることです。そのプログラムの中で、振り分けや採点といった判断をJevに任せます。
出典:Jev with Coding Agents|TypeSafe Docs/Agent Skill|TypeSafe Docs
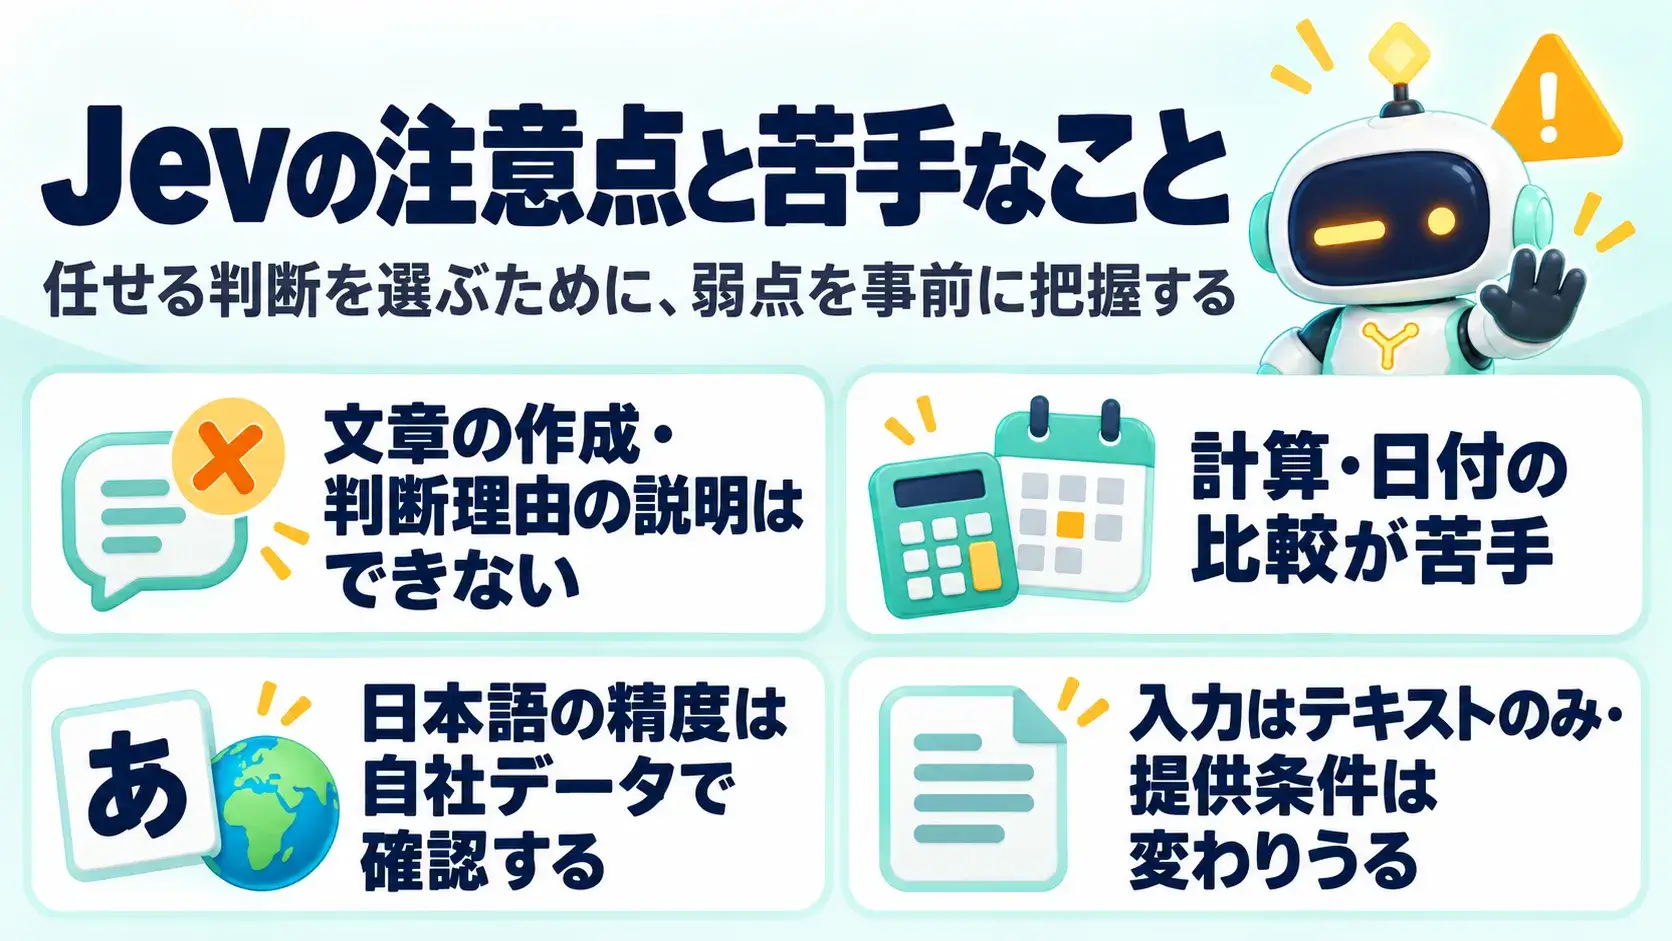
Jevは文章を書けず、計算や日付の比較も苦手です。日本語の精度も、英語ほど高くはありません。TypeSafe AIは、現行モデル「jev-1.13」の既知の弱点を公式ドキュメントで公開しています。どの判断を任せるかを選ぶために、事前に把握しておきましょう。
公式が挙げる9つの弱点を、業務で起こりうる失敗例に置き換えて整理しました。
| 公式が挙げる弱点 | 業務で起こりうる失敗例 | 対策 |
| 条件を字義どおりに読む | 省略した前提や暗黙の例外が判断に反映されない | 条件と境界の例を明記し、複雑な判断は質問に分ける |
| 計算・数値が苦手 | 請求金額の合計や大小の比較を誤る | 計算はプログラムで行う |
| 日付・時刻の比較が苦手 | 期限切れかどうかを誤って判定する | 日付の比較はプログラムで行う |
| 回りくどい指示が苦手 | 二重否定の質問で精度が落ちる | 単純な質問に分解する |
| 無関係な情報が多い入力 | 長いやり取りの履歴に引っぱられて誤る | 判断に必要な部分だけを渡す |
| 悪意ある入力に影響される | 問い合わせ文に仕込まれた指示で判定が変わる | 基準を明確にし、本番前に十分テストする |
| 指示と選択肢の矛盾 | 判定がぶれる | 指示と選択肢の定義をそろえる |
| 選択肢の順番による偏り | 先頭の選択肢が選ばれやすい | 順番を入れ替えて結果を確認する |
| 文章の生成 | 返信文や要約は作れない | 文章はLLMに任せる |
特に注意したいのが、計算と日付の比較です。公式は「Jevは計算機ではない」と明言しています。請求額の照合や期限の判定など、業務で任せがちな判断も、苦手な領域に含まれます。この点は見落とさないようにしましょう。
選択肢の順番による偏りも、見落としやすい弱点です。公式によると、jev-1.13は先頭にある選択肢を選びやすい傾向があります。重要な判断では、選択肢の順番を入れ替えても結果が変わらないかを確かめておくと安心です。
出典:Jev 1.13 Jaggedness|TypeSafe Docs(2026年10月6日確認)
Jevが返すのは、値と確率だけです。「なぜその判断になったのか」を文章で説明することはできません。
LLMで説明文を作ることはできますが、それはJevの実際の判断理由ではありません。理由の説明が求められる業務では、前述のとおり、記録と人による確認を前提に設計しましょう。
日本語で使う場合は、精度を自社のデータで確かめることが欠かせません。公式ドキュメントには、言語について次のように書かれています。
過去の問い合わせなど、自社の日本語データを使って検証しましょう。人の判断との一致率に加え、どんな内容で誤判定が起きやすいかも確認しておくと安心です。
Jevに入力できるのは、テキストだけです。画像や音声、動画を直接読み込ませることはできません。
レート制限(一定時間内に利用できる量の上限)にも注意が必要です。公式ドキュメントによると、上限は需要に応じて動的に調整され、予告なく変更される可能性があります。大量の処理を予定している場合は、上限に達したときの対応も考えておきましょう。
また、Jevはまだ公開から間もないモデルです。稼働率の保証(SLA)などの条件は、公式ドキュメントでは確認できませんでした。基幹業務に組み込む場合は、営業窓口に確認しておくと安心です。
出典:Models|TypeSafe Docs(2026年10月6日確認)
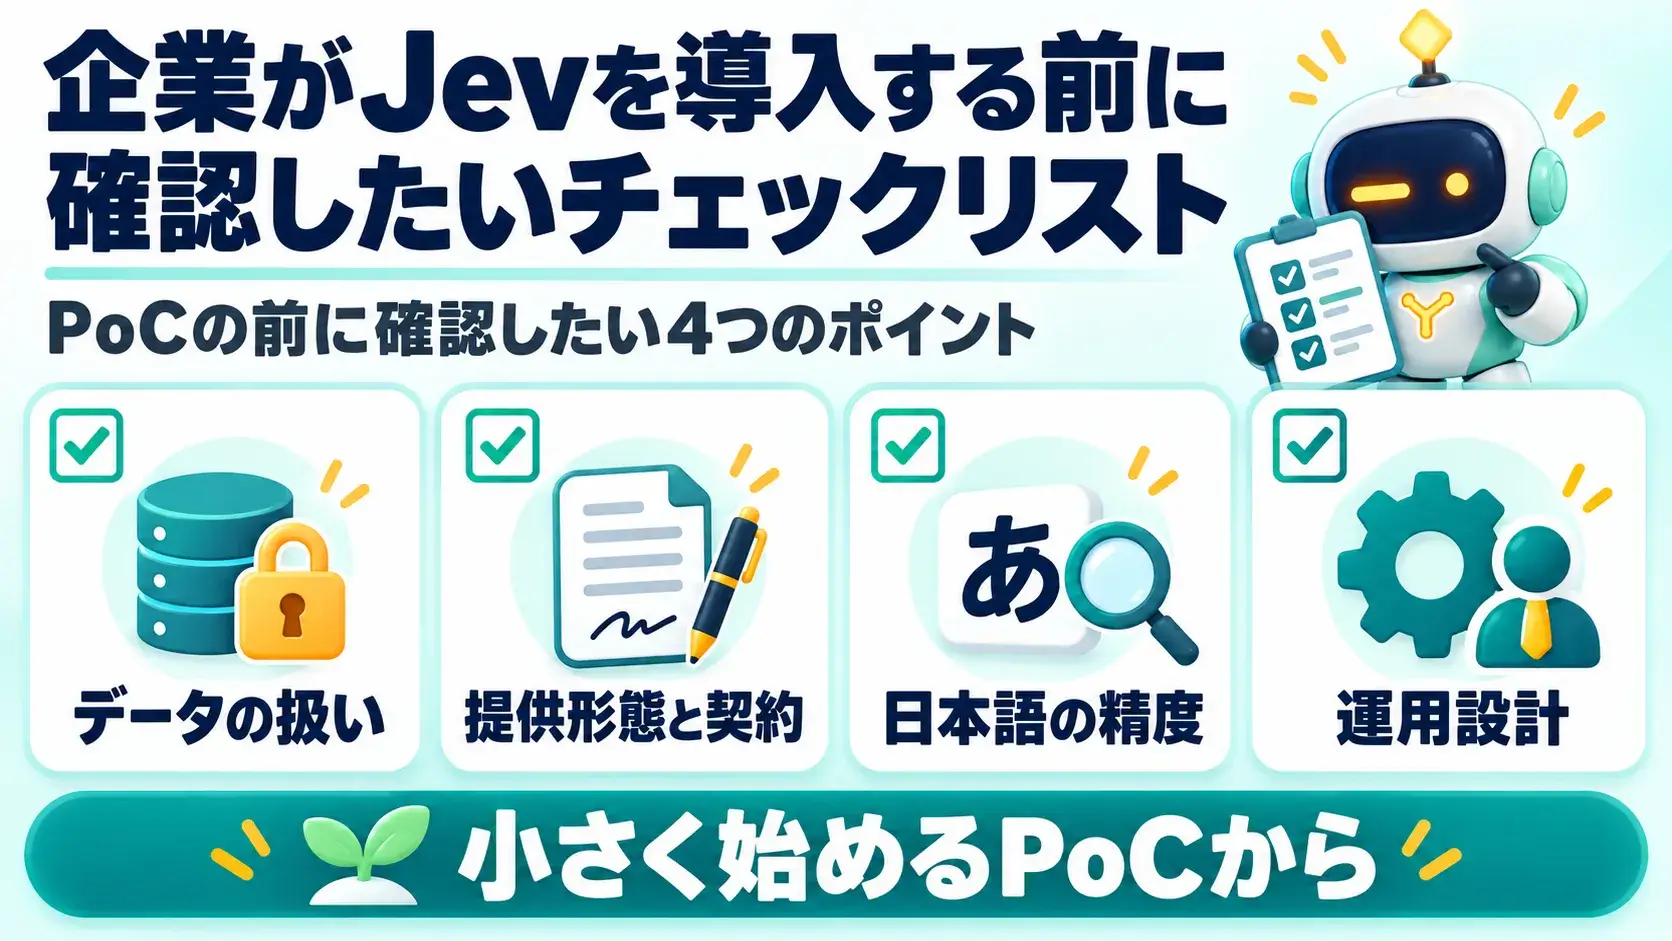
企業でJevを導入するなら、PoCの前に次の4点を確認しておきましょう。「データの扱い」「提供形態と契約」「日本語の精度」「運用設計」です。事前に整理しておけば、情報システム部門や法務部門への説明もスムーズに進みます。
公式情報と、社内で確認したいポイントを表にまとめました。
| 確認項目 | 公式情報(2026年10月6日時点) | 社内での確認ポイント |
| 顧客データの学習利用 | 顧客のリクエスト・レスポンスをモデルの学習に使わないと明記 | プライバシーポリシーの該当箇所を法務と確認する |
| データの保持 | エンタープライズ顧客向けにゼロデータ保持(ZDR)の提供を案内 | 対象データや適用条件を営業窓口に確認する |
| 提供形態 | クラウドのAPIで提供 | 社外のAPIへのデータ送信が社内規程で認められるか |
| 規約・契約 | 利用規約、マスター顧客契約、データ処理契約などを公開。マスター顧客契約の準拠法はカリフォルニア州法および米国法 | 海外事業者との契約として、法務の確認が必要か |
| 入力できるデータ | テキストのみ。1リクエストあたり64,000トークンまで、うちstateと最長の質問の合計は32,000トークンまで | 渡す情報の範囲(個人情報を含める必要があるか)を決める |
| 日本語の精度 | 英語が最も高精度で、日本語は同等ではない | 自社データで人の判断と照合する |
| 処理能力 | レート制限は予告なく変わりうる | ピーク時の件数と、止まったときの代わりの手段 |
※TypeSafe AIの公式ドキュメント・規約ページ(2026年10月6日時点)に基づきます。
注意したいのは、「学習に使わない」ことと「データを保持しない」ことが異なる点です。TypeSafe AIは、顧客のリクエストやレスポンスをモデルの学習に使わないと説明しています。一方、データの保持条件については、別途確認が必要です。
ZDR(ゼロデータ保持)は、一般に送信内容を事業者側で保存しない取り扱いを指します。ただし、TypeSafe AIのZDRの対象データや適用条件は、公開ページからは確認できませんでした。公式ドキュメントに記載の営業窓口(sales@typesafe.ai)に確認しましょう。外部のAIゲートウェイを使う場合は、その事業者の条件も確認する必要があります。
社内規程との整合も、早めに確認しておきたいポイントです。顧客の問い合わせ文には、氏名や連絡先などの個人情報が含まれることがよくあります。海外の事業者が提供するAPIに個人情報を送ってよいかは、企業ごとの規程や契約によって判断が分かれます。
判断に必要のない個人情報を、Jevに渡す前に取り除いておくことも有効な手段でしょう。たとえば、部署の振り分けに氏名や電話番号は必要ありません。渡す情報を最小限に絞れば、リスクを抑えつつ導入を進めやすくなります。
出典:Models|TypeSafe Docs/Legal|TypeSafe Docs/Privacy Policy|TypeSafe AI/Master customer agreement|TypeSafe AI/Data processing addendum|TypeSafe AI(2026年10月6日確認)
Jevの導入は、1つの業務に絞って小さく始めるのがおすすめです。次の5つのステップで進めると、効果とリスクを見極めやすくなります。
ステップ3の初期検証では、代表的な問い合わせと、迷いやすい例外ケースを集めましょう。質問やしきい値の調整に使うデータと、最終評価に使うデータは分けておきます。調整に使ったデータだけで評価すると、実際の性能よりも高く評価しやすいためです。
本番導入を判断する際は、件数だけでなく、誤判定が起きたときの影響とケース別の結果も確認してください。
PoCでは、次の2つの数値をあわせて測ることが大切です。
しきい値を下げれば自動化率は上がりますが、誤り率も上がりやすくなります。両者のバランスを見ながら、自社が許容できる水準を探りましょう。
確信度ごとの正答率も確認しておくと、しきい値を決めやすくなります。たとえば「確信度0.9以上の判断は、人の判断と何%一致したか」を集計する方法です。確信度が高いほど正答率も高い傾向が見られれば、確信度を目安にした運用を組み立てやすくなるでしょう。
あわせて、Jevが使えないときは人の処理に切り替える仕組みも最初から用意しておきましょう。提供条件が変わりやすい時期だからこそ、サービスが停止しても業務を続けられる設計が重要です。
最後に、Jevの利用前に確認しておきたい疑問に回答します。
Jevは、入力100万トークンあたり0.042ドルの従量課金制で、出力は無料です。無料クレジットの有無や付与条件は、申し込み時に公式コンソールで確認してください。
出典:Models|TypeSafe Docs(2026年10月6日確認)
代わりにはなりません。ChatGPTやClaudeは文章を作るAIで、Jevは判断を返すAIです。
文章の作成や要約はLLM、分類や振り分けはJevというように、併用するのが基本です。それぞれの強みを生かせる業務に使い分けましょう。
出典:Jev with Coding Agents|TypeSafe Docs(2026年10月6日確認)
使えます。ただし公式は、英語が主な学習言語で、日本語は英語ほどの精度ではないとしています。業務で使う前に、自社の日本語データで検証しましょう。
出典:Models|TypeSafe Docs(2026年10月6日確認)
今回確認した公式資料では、社内サーバーで動かす方法は案内されていません。案内されているのは、クラウドのAPIを利用する方法です。
なお、エンタープライズ向けのZDRはデータの保持に関する条件であり、オンプレミス提供とは異なります。ZDRを使う場合も、データは外部のAPIに送信されます。
出典:Models|TypeSafe Docs/Legal|TypeSafe Docs(2026年10月6日確認)
試すだけなら、プログラミングは不要です。公式コンソールのPlaygroundを使えば、ブラウザ上で動作を確認できます。
一方で、業務システムに組み込んで自動化するには、開発が必要です。社内に開発体制がない場合は、AIの開発会社に相談するのも一つの方法です。
Jevの入力はテキストのみのため、画像を直接判断することはできません。PDFの場合は、文字を取り出してテキストにしてから渡す必要があります。
出典:Models|TypeSafe Docs(2026年10月6日確認)
あります。Vercelは2026年10月1日、Convai Innovationsの判断モデル「Laya」の提供を発表しました。AI GatewayからBoundless経由で利用する場合、2026年10月31日まで無料です。期間終了後は、無料専用のIDでの提供は停止し、標準のIDは課金に切り替わると案内されています。
Layaも、Yes/No・選択・採点の質問に対して、確率付きの構造化された答えを返すモデルです。判断に特化したモデルは、新しいカテゴリとして広がり始めていると言えるでしょう。
出典:Laya decision model now available on AI Gateway|Vercel(2026年10月6日確認)
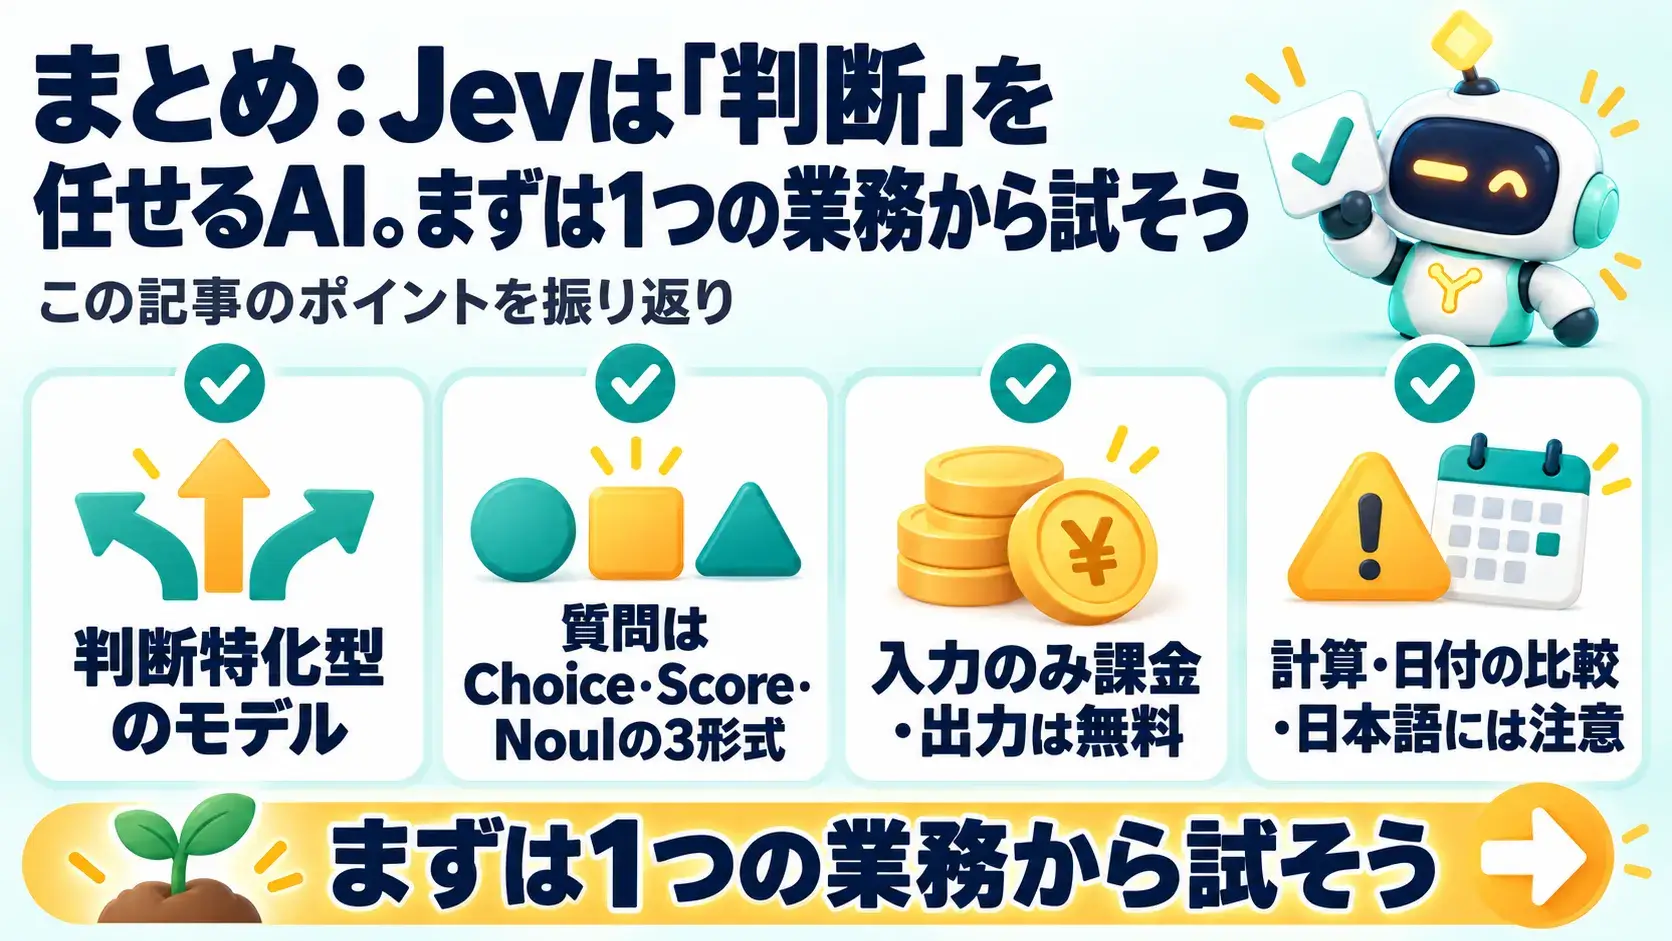
Jevは、文章生成よりも、ソフトウェアで利用する判断に特化したAIモデルです。本記事のポイントを振り返ります。
まずは、自社の業務から「Jevに任せられる小さな判断」を1つ選んでみましょう。問い合わせの振り分けや、書類の一次チェックなどが候補になります。Playgroundで試し、手応えがあればPoCへ進むのがおすすめです。
問い合わせの振り分けやAIエージェントの導入を検討する方は、AIsmileyで関連サービスを比較できます。資料請求の際は、対象業務、日本語データの評価、既存システムとの連携、運用支援の範囲を確認しましょう。
アイスマイリーでは、生成AI のサービス比較と企業一覧を無料配布しています。課題や目的に応じたサービスを比較検討できますので、ぜひこの機会にお問い合わせください。
業務の課題解決に繋がる最新DX・情報をお届けいたします。
メールマガジンの配信をご希望の方は、下記フォームよりご登録ください。登録無料です。


FOLLOW US
SNSをフォローして、最新情報をチェックできます!


AI製品・ソリューションの掲載を
希望される企業様はこちら