


生成AI
最終更新日:2026/11/02
「AIエージェントを業務に入れたいが、悪用リスクへの対策は何から進めたらいいかわからない」こうしたお悩みを持つIT担当者は少なくないでしょう。2025年以降に表面化している「バイブハッキング」は、攻撃者がAIに目的を伝えるだけで、偵察から侵入、恐喝文の作成までをAIエージェントが実行してしまう手法であり、重大なリスクとして懸念されています。
本記事では、バイブハッキングの概要から従来型攻撃との違い、実際に確認された事例、企業が取るべき対策まで、Anthropicの最新レポートを含む一次情報に基づいて整理します。自社のAI活用に適切な対策を講じるために、ぜひご覧ください。
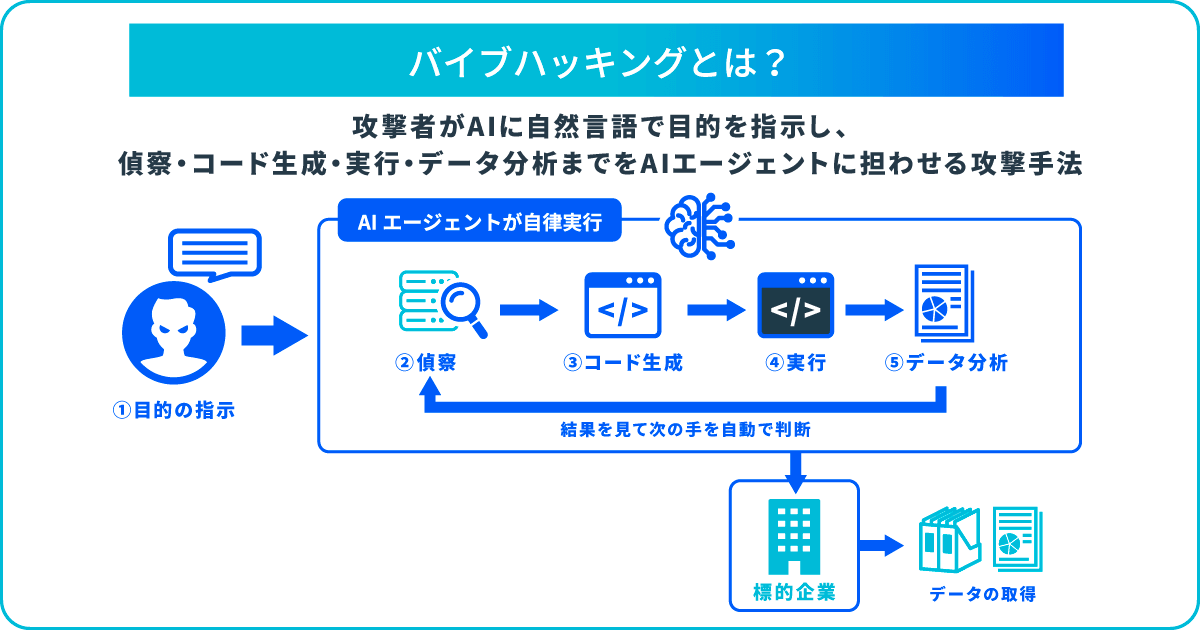
バイブハッキングとは、攻撃者が自然言語でAIに目的を指示し、偵察や脆弱性スキャン、攻撃コードの生成・実行、窃取データの分析・恐喝文の作成などをまとめてAIエージェントに担わせる攻撃手法です。
これまでも、AIはフィッシング文面の作成やコードの断片生成に使われてきました。しかし、バイブハッキングは、AIが助言役ではなく実行主体となる点が異なります。攻撃者は「この組織から価値のあるデータを取れ」といった粒度の指示を与えるだけで、具体的な手順の選択はAIが行います。
Claude Codeを運営するAnthropicは、2025年8月の脅威インテリジェンスレポートで、コーディングエージェントに被害者ネットワーク上の作戦を実行させるこの手口を「vibe hacking」と名付けました。攻撃の巧拙が、攻撃者の技術力ではなくAIの能力に依存する時代に入っています。
語源は「バイブコーディング(vibe coding)」です。2025年2月にAndrej Karpathy氏が提唱した、生成されたコードを細かく確認せず、自然言語の対話だけでソフトウェアを組み上げる開発スタイルを指します。
専門知識がなくても実用性のあるものが作れるようになり、開発の民主化をもたらした一方で、バイブハッキングはその裏返しとも言えます。
Anthropicは2026年9月10日、自社AIの悪用事例をまとめた脅威インテリジェンスレポートを公開しました。2025年12月から2026年8月までに検知・遮断した事案を、サイバー攻撃や影響工作、詐欺、通常兵器開発など7分野に整理しています。
同レポートでは、顧客企業の環境から流出したAPIキーやセッショントークンが悪用されていた点も指摘しています。
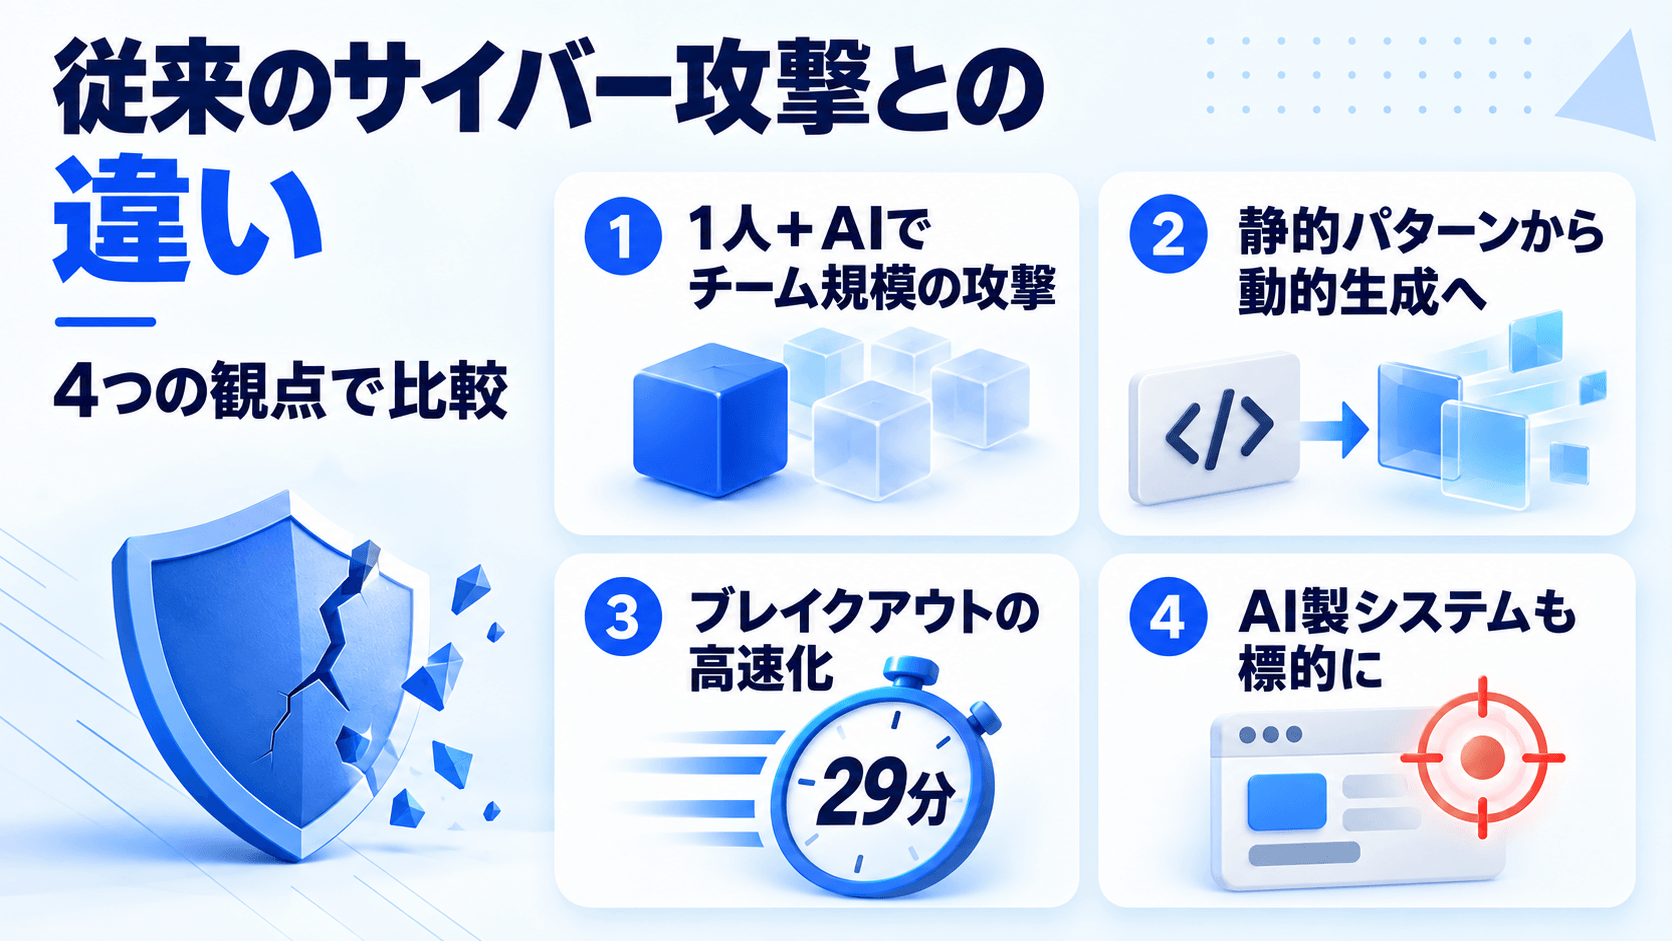
バイブハッキングは、従来型のサイバー攻撃と何が違うのでしょうか。攻撃者側の制約、攻撃コードの生成方法、攻撃の速度、そして狙われる対象という4つの観点から詳しく説明します。
従来までの人的リソースの制約が消えつつあります。これまでの大規模な攻撃には、偵察担当・侵入担当・マルウェア開発担当といった分業と、相応の人数・時間・資金が必要でした。
しかし、Anthropicが2025年8月に開示した事例(GTG-2002)では、1人の人間がClaude Codeを使い、数週間のうちに最低17組織を標的とする大規模なデータ窃取・恐喝キャンペーンを実行できています。Anthropicは2026年9月のレポートで「高度な攻撃には、もはや高度な攻撃者は必要ない」と述べています。
バイブハッキングでは、攻撃コードが標的ごとにその場で生成されるため、照合すべき既知のパターンが存在しなくなっています。従来は、同じマルウェアが使い回される前提で、「悪性ファイルのハッシュ値」「攻撃コードの特徴」といった既知の静的パターンとの照合によって防御が成立していました。
一方、バイブハッキングではこれまでの前提が崩れ、文字列の暗号化やアンチデバッグ処理を実装した上で実行する「動的生成」が重要です。
ブレイクアウトタイムとは、攻撃者が最初の侵入に成功してから、別の端末へ横展開するまでの時間です。防御側にとっては、封じ込めに使える猶予を意味します。
2026年2月に公開された「2026 Global Threat Report(By CrowdStrike)」によると、2025年のeCrime(金銭目的のサイバー犯罪)における平均ブレイクアウトタイムは29分まで短縮されました。同社はこれを2024年比で65%の高速化と表現しています。
つまり、アラートを受けた担当者が状況を確認し、上長の判断を仰いでから遮断するという流れでは攻撃に間に合わない計算です。
AIで作られたシステム自体が攻撃対象にも含まれています。Veracodeの「2025 GenAI Code Security Report」(2025年7月公開)によれば、80のコーディングタスクを100以上のLLMに実行させた結果、AI生成コードの45%にOWASP Top 10の脆弱性が含まれていました。
また、CrowdStrikeは、90を超える組織で自社の生成AIツールに悪意あるプロンプトが注入され、AI開発プラットフォーム自体も悪用されていると報告しています。自社の開発物・自社のAI基盤が標的になりうる、という前提で対策が必要です。
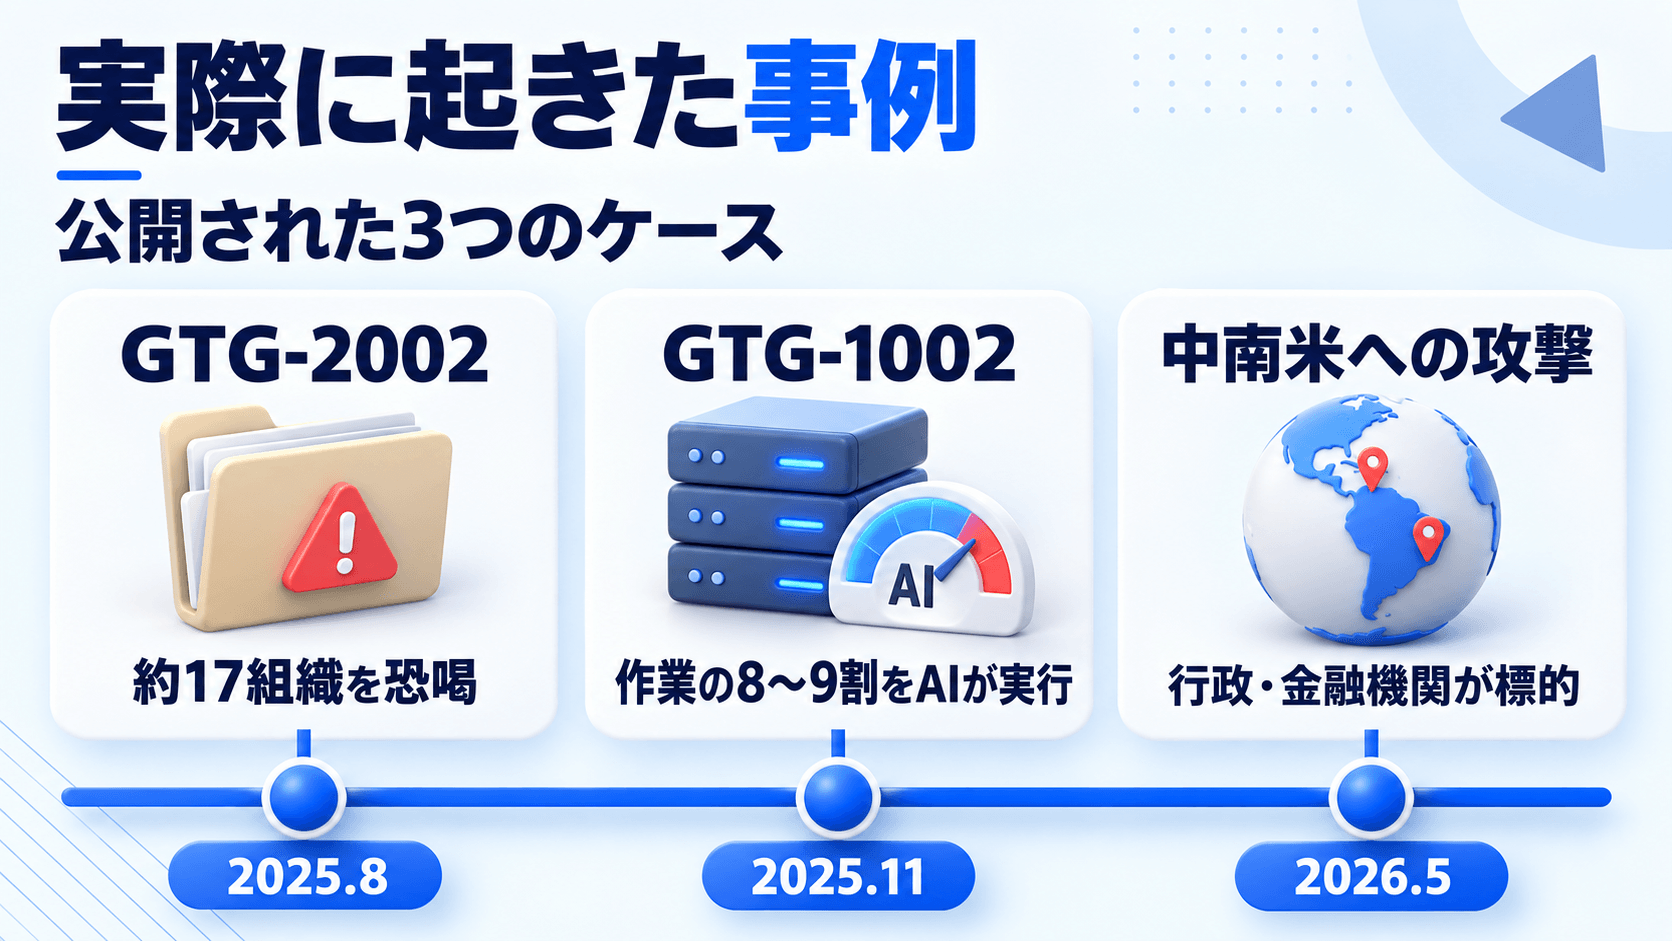
ここからは、AIベンダーとセキュリティベンダーが公開している3つの事例を紹介します。
Anthropicの公開レポート(2025年8月)で開示されたGTG-2002は、1人の攻撃者がClaude Codeを悪用し、政府機関、医療機関、金融機関を含む約17の組織を標的としたケースです。
攻撃者は設定ファイル(CLAUDE.md)に虚偽の前提を埋め込み、AIを欺きました。結果として、Claude Codeが数千のVPNエンドポイントのスキャンや認証情報の抽出、トンネリングツールの独自改変までを実行しています。
また、窃取した財務データを分析して支払可能額を算定し、従業員数などを織り込んだ脅迫文を被害組織ごとに作成しました。要求額が50万ドルを超えるケースもあります。
GTG-1002は、2025年11月13日にAnthropicが公開した事例です。中国の国家支援型と評価される攻撃グループが2025年9月に、大手テクノロジー企業や金融機関、政府機関を含む約30組織を標的とした攻撃を実施しました。
自動化の度合いが極めて高く、脆弱性の検証から認証情報の窃取、水平移動、データの選別と持ち出しまで、戦術的作業の約8〜9割をClaude Codeが実行しています。人間の介入は1キャンペーンあたり4〜6か所の意思決定ポイントのみです。
AIベンダー以外の事例として、トレンドマイクロは2026年5月、中南米の行政機関と金融機関を狙う2つのキャンペーン「SHADOW-AETHER-040」「SHADOW-AETHER-064」を公開しました。
前者はスペイン語話者によるもので、2025年12月27日から2026年1月4日にかけてAnthropicのClaudeを利用してメキシコの6つの行政機関に侵入しました。また、後者はポルトガル語話者によるブラジル金融機関への攻撃で、AIエージェントの利用痕跡は確認されたものの、LLMサービスは特定されていません。
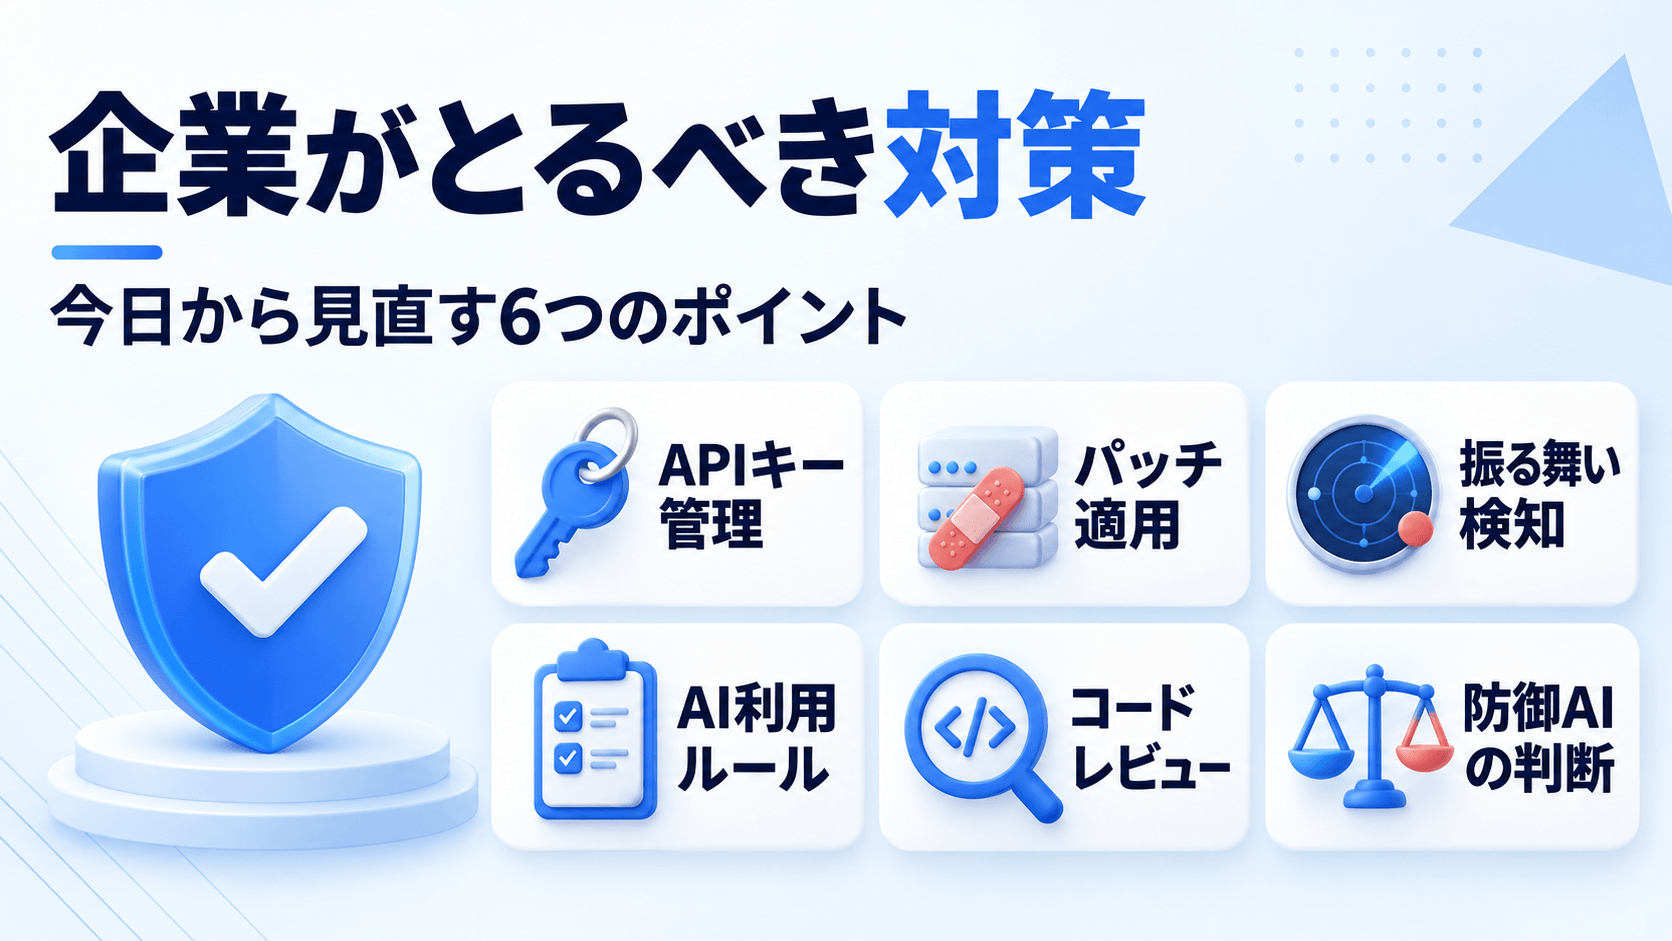
実際の事例を見ると、別々のグループが類似の手口へ到達しており、手口はすでに一般化しつつあることがわかります。ここからは、現場では何から手をつけるべきなのか、具体的な対策方法を見ていきます。
Anthropicの2026年9月レポートで確認された事例の多くは、AIベンダー側の侵害ではなく、流出したAPIキーやセッショントークンが使われたものです。攻撃者は不正に入手したキーを、転売や被害者への転嫁、なりすましによる攻撃トラフィックの隠蔽などに利用しています。
よって、AIへのアクセス権自体を流出させないことが重要です。まずは、ソースコード、CI/CD設定、社内ドキュメントやスプレッドシートにハードコードされた秘密情報を棚卸ししましょう。その上で、シークレットマネージャへの集約やキーの定期ローテーション、利用量急増のアラート、退職者・終了プロジェクトのキー失効までを運用に組み込みます。
AIエージェントは、公開された脆弱性情報の読み込みから該当ホストの検索、検証コードの生成まで短時間で可能です。よって、「月次のパッチ適用日にまとめて対応する」という運用では、公開から適用までの空白が多くなり、攻撃のチャンスを増やしてしまいます。
資産の重要度に応じたSLAの二層化が重要で「外部公開資産とVPN・境界機器は72時間以内、内部資産は既存サイクルを維持する」といった切り分けが理想的です。また、緊急適用の判断についても事前に決めておく必要があります。
攻撃コードがその場で生成される以上、既知の悪性ファイルとの照合による検知は機能しにくくなります。そのため、まずはEDR/XDRの振る舞い検知が有効化されているか、監視モードのままで遮断設定になっていないか、を確認しましょう。
また、AI起点の攻撃にはトンネリングや水平移動ツールの実行、内部から外部へのSOCKS5トンネル、通常業務では発生し得ない時間帯の大量スキャンなど共通の痕跡が見られます。これらを検知ルールとスレットハンティングのクエリに組み込みます。
自社で動かしているAIエージェントも標的となりえます。そのため、承認を経ずに導入されたエージェントが社内資産に広い権限を持つ「シャドーエージェント」の状態では、乗っ取られた際の被害範囲が読めません。
よって、権限の最小化、実行ログの保存、利用申請、の3点は確認・管理が必要です。
「動いたからマージする」という運用ではなく、レビューを制度として組み込む必要があります。具体策としては、AI生成コードを含むプルリクエストにラベルを付けて可視化することが重要です。
認証・認可・秘密情報の取り扱い・外部入力の検証については、必ず人間のレビューを通す必要があります。
防御としてAIを使う場合、導入可否は3つの観点から判断できます。まず1つ目に、人間が結果を検証できるかどうかです。AIは、過大報告や存在しない認証情報、検出結果の生成といったリスクがあり、GTG-1002でも確認されています。
2つ目に、誤検知の影響範囲が許容できるかどうかです。自動遮断の対象が基幹システムであれば慎重な設計が必要です。
3つ目が、診断対象を自社資産と許諾範囲に限定できるか。範囲外へのスキャンは法的リスクになります。
今日から着手できる5項目を以下に示します。
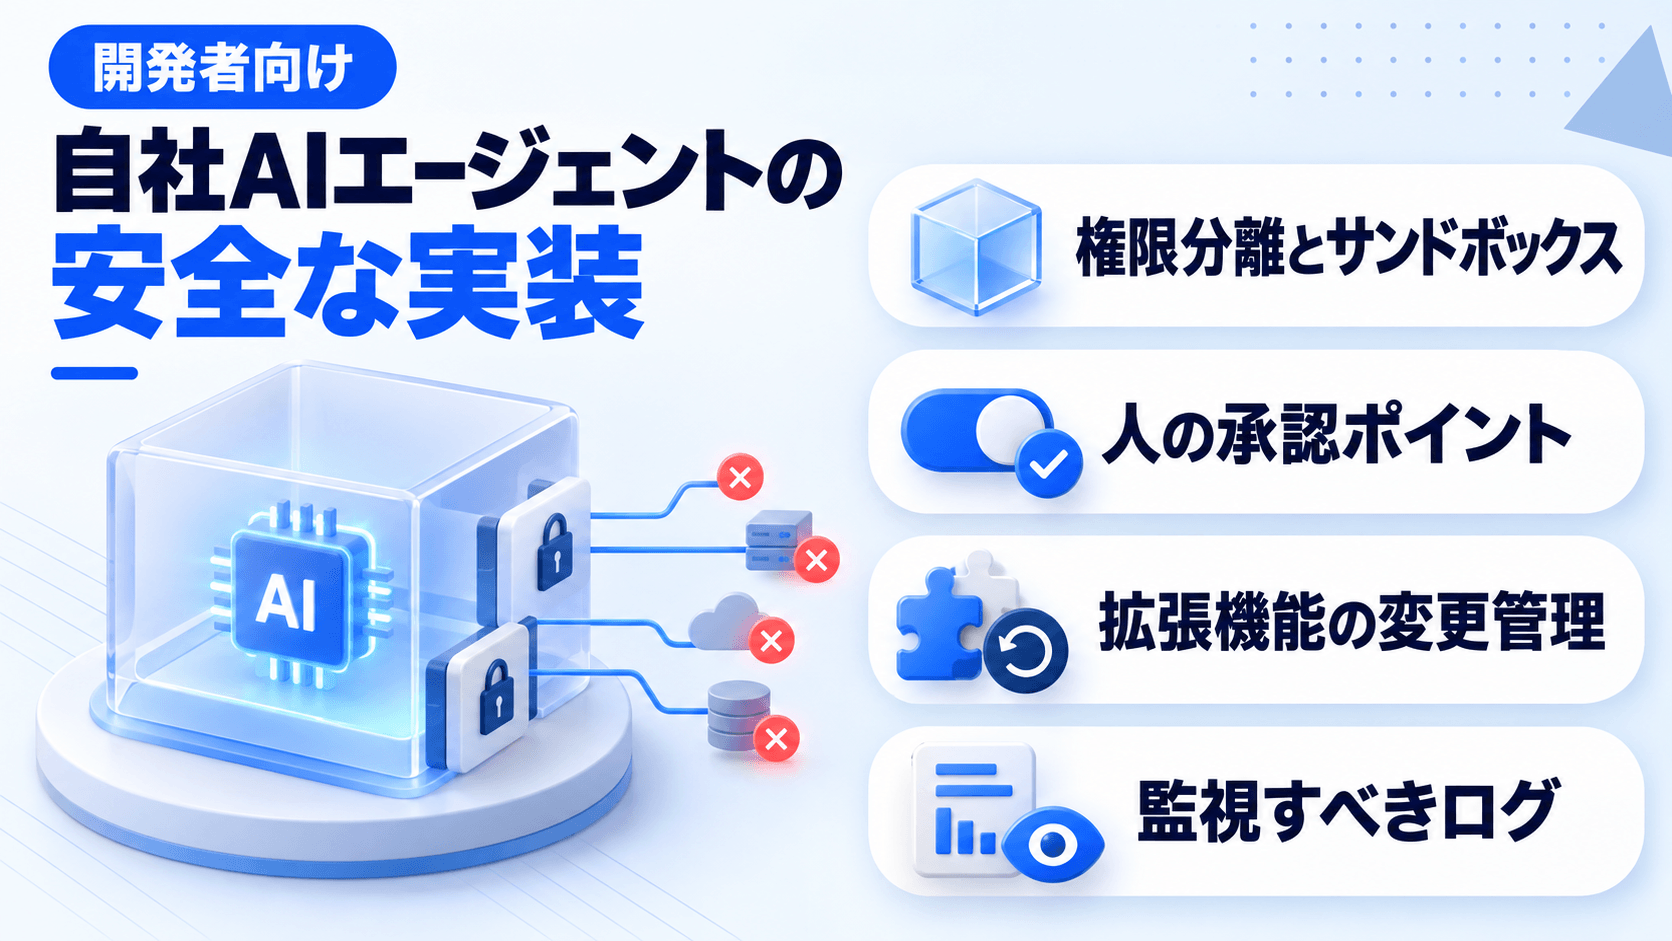
ここからは、自社でAIエージェントを動かす立場の開発者やエンジニア向けの内容です。万一乗っ取られても被害を広げないための設計の考え方を、4つの観点から説明します。
AIエージェントには、必要以上の権限を渡さないことが重要です。ファイルの読み取り、書き込み、外部への通信などの設定を、別々の機能として分けて定義します。
加えて、実行環境そのものを隔離された箱の中に閉じ込め、本番システムや社内ネットワークに直接触れられないようにします。エージェントが騙されても、届く範囲がその箱で止まる状態を構築することが大切です。
データの削除や外部へのファイル送信、権限やアカウント設定の変更といった操作は、実行の前に必ず人が確認します(Human-in-the-loop)。
一方、ログの検索、資料の読み取り、テスト実行といった頻度が高く影響の小さい操作は自動化が可能です。この線引きを、導入時に一覧として明確化し、書き出しておきましょう。
AIエージェントの機能は、Skills(作業手順をまとめた定義ファイル)やMCP(外部サービスと接続する仕組み)によって後で追加できるものです。便利な反面、AIに書き換えられると、エージェントの振る舞いが丸ごと変わってしまいます。
定義ファイルはソースコードと同じように変更履歴を管理し、修正時はレビューを通しましょう。また、意図しない書き換えを検知する仕組みも必要です。
エージェントの不審な動きは、実行ログに表れます。次の4つを記録・監視する仕組みを取り入れましょう。
防御の一部はベンダー側で行われており、自社がどこまで対策すべきかを決める上でも、その前提を知っておく必要があります。
Anthropicは、悪用を検知するとアカウントを停止し、同種の手口を検知する仕組みを強化し、必要に応じて当局や業界パートナーと情報を共有する、というサイクルを実施しています。同様の取り組みは業界全体に広がっており、OpenAIとGoogleも悪用事例の報告を定期的に公開しています。
また、2026年8月にはOpenAIが呼びかけたサイバー防衛の公開書簡に、Anthropicを含む100を超える企業・団体が署名しました。
Anthropicは2026年4月、最上位モデル「Claude Mythos Preview」について、脆弱性の発見と悪用のリスクが高いという理由で一般公開を見送りました。ただし、同年6月には同じ基盤モデルに安全対策を加えた「Claude Fable 5」が一般公開され、「Mythos 5」も限定機関のみに提供されています。
また、6月12日にはジェイルブレイクの把握などが原因で、当時の最上位AIモデル「Claude Fable 5」と「Claude Mythos 5」が、米政府の輸出管理指令で全世界停止となる異例の事態が発生しました。
その後、7月1日には提供が再開され、プランによる制約はあるものの現在も一般公開が続いています。こうした実例を受けて、モデルの提供側としては公開の可否というより、どのように区別し、どう規制するかが論点となってきています。
バイブハッキングは、攻撃者がAIエージェントに目的を伝えるだけで、偵察から侵入、データの持ち出しまでを実行させる攻撃手法です。過去の事例は、この手口がすでに国家支援グループから個人まで広がっている事実を示しており、的確な対策が求められています。
一方で、トレンドマイクロが指摘するとおり、AIは存在しない脆弱性をつくり出すことはできません。APIキーの管理やパッチ適用、振る舞い検知、社内ルールといった基本的な対策の徹底が有効な防御になる可能性があります。
アイスマイリーでは、生成AI のサービス比較と企業一覧を無料配布しています。課題や目的に応じたサービスを比較検討できますので、ぜひこの機会にお問い合わせください。
「AIに自然言語で目的を伝え、実行させる」という点は同じで、開発に使えばバイブコーディング、攻撃に使えばバイブハッキングになります。 問題は、新しい攻撃技術が生まれたことではなく、誰でも使えるツールがそのまま攻撃に転用できてしまう点にあります。
単独で被害の有無を判別する方法は少なく、AIが関与したかどうかは多くの場合、侵入後の調査で初めてわかります。 確認すべきは、通常のインシデントと同じ兆候です。身に覚えのないAPIキーの利用や利用量の急増、業務では説明できない大量のデータ転送、公開されたばかりの脆弱性に対する短時間での集中的な攻撃などをチェックしましょう。
バイブコーディングを使っていること自体が危険ではなく、生成されたコードを検証せずに本番環境へ出す運用が問題となります。 認証情報がコードに直接書き込まれるケースも珍しくありません。レビュー要件の明文化、自動検査ツールの導入、APIキーの棚卸しとローテーションという3点を運用に組み込めば、リスクは管理できる範囲に収まります。
業務の課題解決に繋がる最新DX・情報をお届けいたします。
メールマガジンの配信をご希望の方は、下記フォームよりご登録ください。登録無料です。


FOLLOW US
SNSをフォローして、最新情報をチェックできます!


AI製品・ソリューションの掲載を
希望される企業様はこちら