


生成AI
最終更新日:2026/11/17
Grok 4.7は、2026年9月21日にSpaceXSIが公開したAIモデルです。コーディングや長時間のエージェントタスク、知識労働に重点を置いて開発され、前世代のGrok 4.6よりも長時間タスクへの対応力や自己検証能力が強化されています。
本記事では、導入を検討している企業のDX担当者や開発者に向けて、性能の違い、料金、導入方法、活用時の注意点を整理します。
\ AIエージェントの活用事例を、無料でチェック /
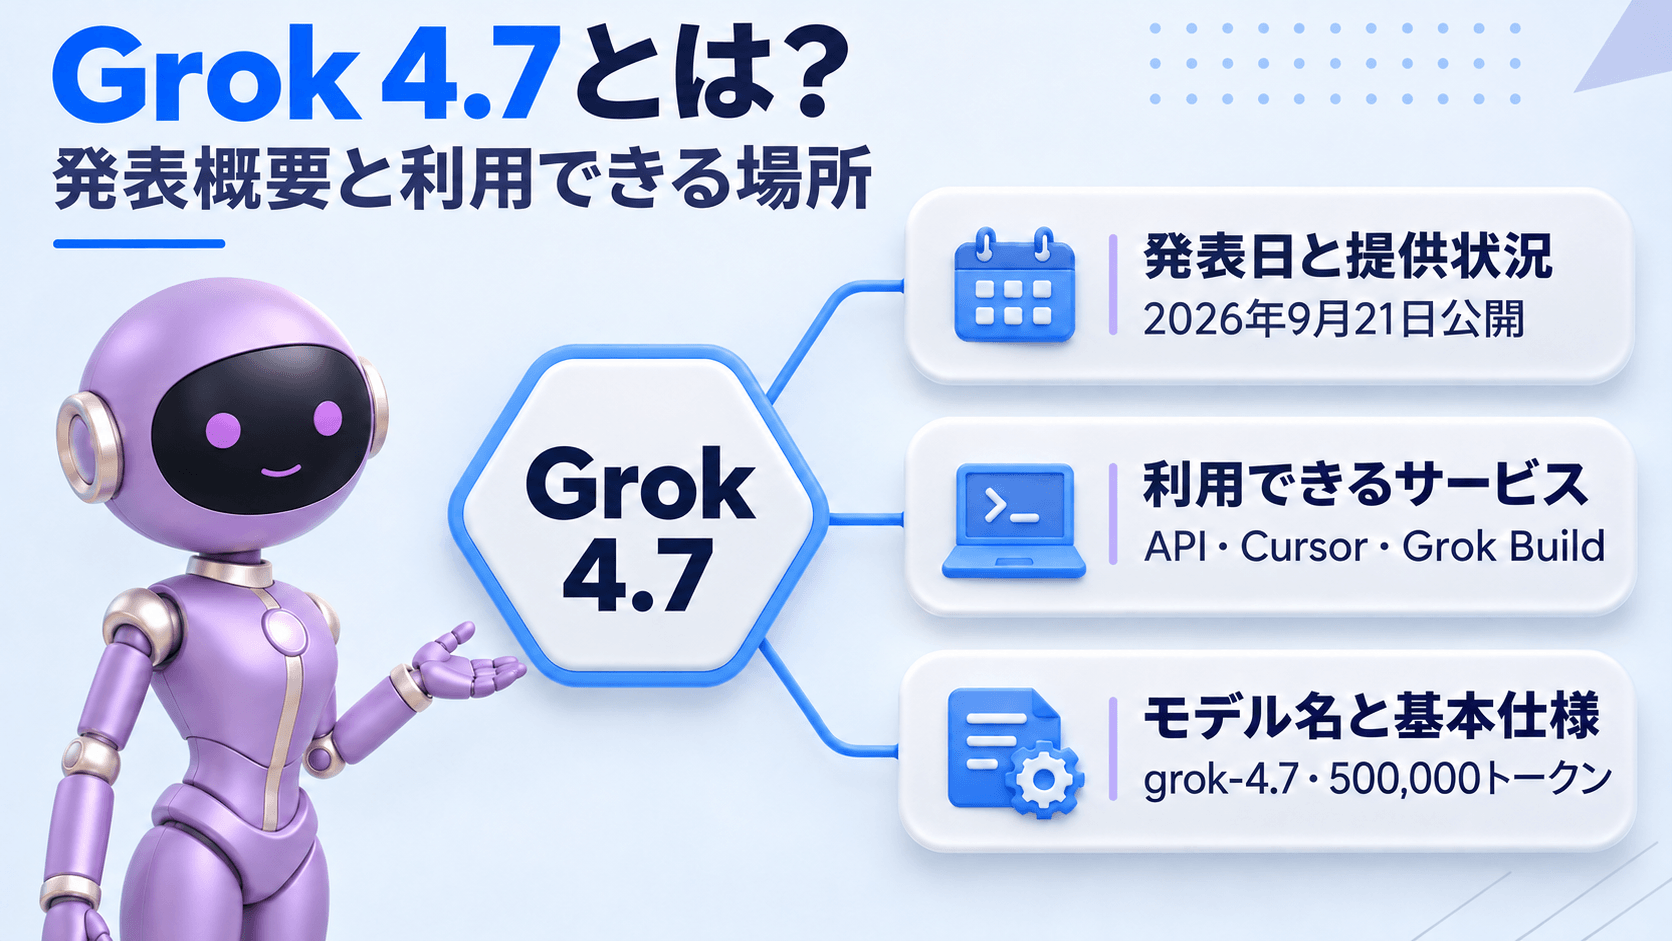
Grok 4.7は、一般向けGrokサービスの機能名ではなく、APIや開発ツールから指定できるモデルの名称です。利用するサービスによって、モデルの指定方法や料金は異なります。
開発元の表記についても補足します。SpaceXは2026年2月2日にxAIを買収しました。xAIは同年7月にSpaceXAIへ改称し、10月にはブランド名をSpaceXSIへ変更しています。法人名はSpaceXAI LLCです。本記事では2026年10月現在のブランド名に合わせてSpaceXSIと表記します。
Grok 4.7は2026年9月21日に公開されました。公式発表によると、同日からCursorとGrok Buildで利用可能になり、xAI API(公式発表での表記はGrok API)、サードパーティ製のコーディングハーネス、モデルルーターやクラウドプラットフォーム経由でも提供されると説明されています。
前世代のGrok 4.6は2026年8月12日の公開だったため、およそ6週間での更新となります。
関連記事:Grok 4.6とは?性能・料金・使い方・導入前の注意点を解説
Grok 4.7の利用入口は、次の3つが中心です。
このほか、OpenRouterやVercel、Cloudflareなどのモデルゲートウェイ経由でも利用可能です。
GitHub Copilotでも、公開当日の2026年9月21日から段階的に提供が始まりました。対象はPro、Pro+、Max、Business、Enterpriseの各プランで、VS CodeやJetBrainsなどのモデル選択画面から選べます。さらに、2026年9月28日からはAmazon Bedrockでも利用できます。AWS環境で生成AIを運用している企業は、既存の権限管理やガードレールと組み合わせて試せます。
ただし、grok.comの一般チャットでGrok 4.7を選択できるかどうかは、利用プランや提供状況によって異なります。利用可能なモデルは、実際の選択画面や公式案内で確認してください。
関連記事:Grok(グロック)とは?特徴・料金・使い方を解説〖2026年最新〗
APIでのモデルIDは「grok-4.7」です。コンテキストウィンドウは500,000トークンで、テキストと画像を入力し、テキストを出力します。公式のモデル仕様では、テキストの最大出力トークン数に固定の上限は設定されていません。推論レベルは4段階から選べます(詳しくは後述)。
なお、Grok 4.7の知識カットオフは2026年5月であり、それ以降のニュースや為替、製品発表を内蔵知識として答えることはできません。最新情報を扱いたい場合は、Web検索やX検索といったサーバー側ツールを有効にします。
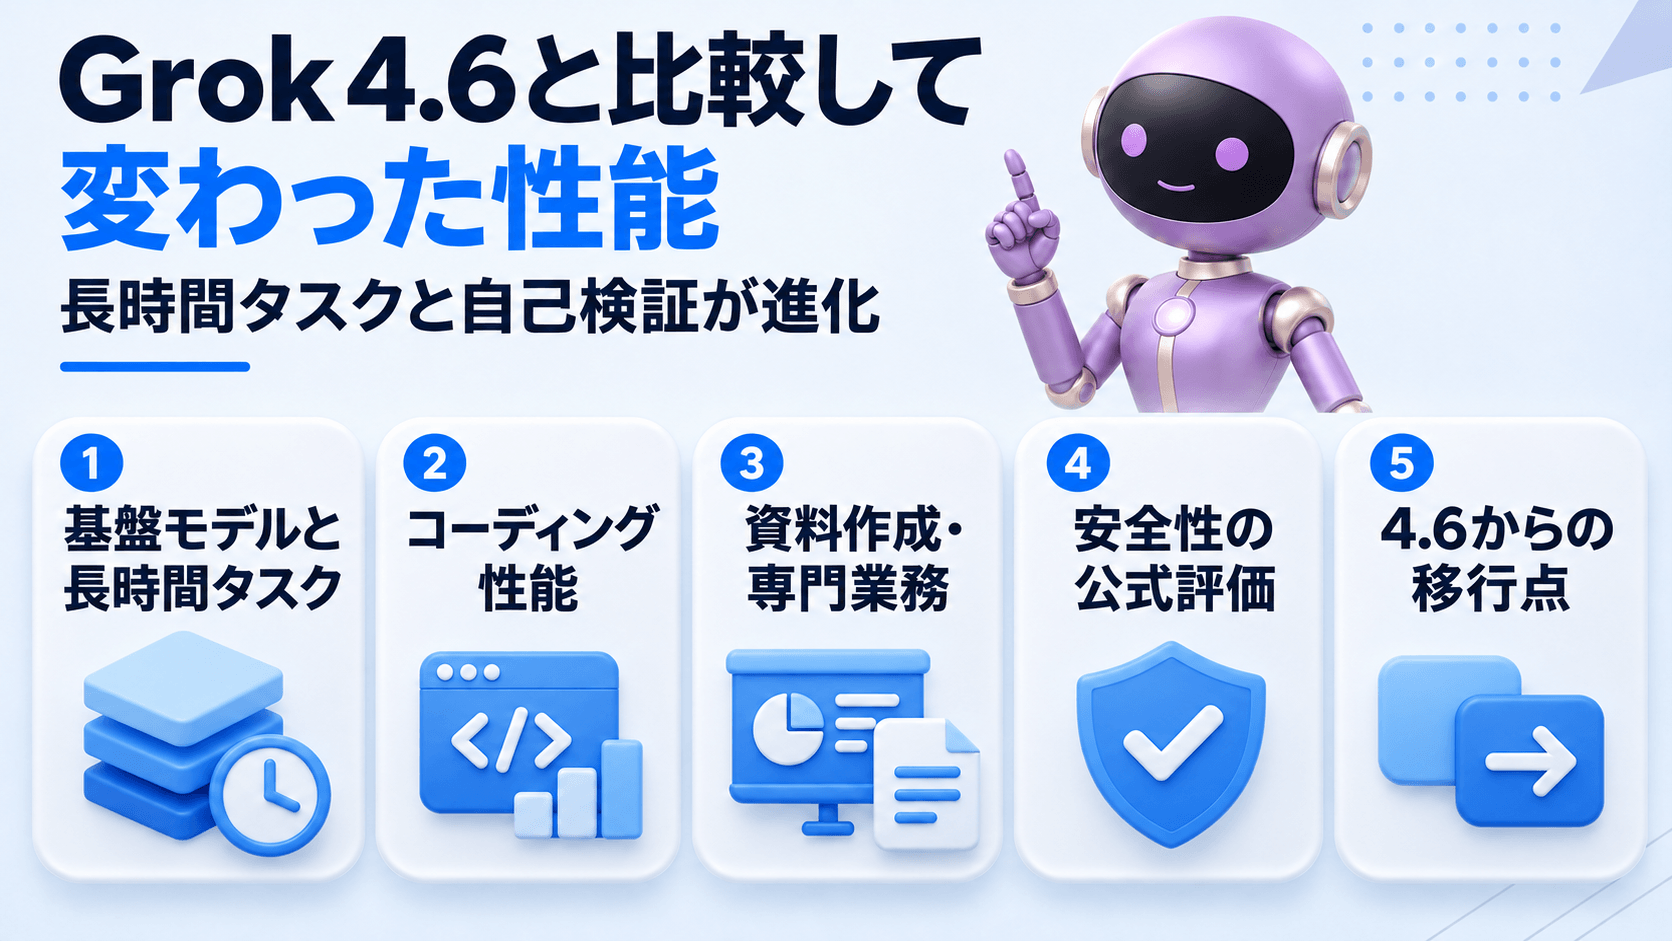
Grok 4.6とGrok 4.7は、料金体系や基本的なAPI仕様が共通しています。一方、Grok 4.7では、長時間の作業への対応力や自己検証能力が強化されています。ここでは、基盤モデルの変化、ベンチマーク結果、安全性、移行時の変更点の順に整理します。
Grok 4.7はGrok 4.6より大きな基盤モデルを採用しています。強化学習の期間が長くなり、数時間かかるような難しい課題を重視した学習が行われています。あわせて、自分の作業結果を検証する能力と、長い文脈を扱う能力が強化されました。
さらに、Grok Botのハーネスを理解できるよう学習されており、対話を伴うタスクや知識労働での性能向上につながると説明されています。こうした改良により、複数の手順を要する作業や、途中で方針を見直すタスクにも対応しやすくなっています。
コーディング性能について、SpaceXSIは複数のベンチマーク結果を公表しています。ただし、測定時の推論設定はGrok 4.7がxhigh、Grok 4.6がhighで、条件は揃っていません。
| 評価指標(SpaceXSI公表値) | Grok 4.7(xhigh) | Grok 4.6(high) |
| CursorBench 4.0 | 46.3% | 40.4% |
| Terminal-Bench 4.0 | 37.6% | 20.3% |
| EEBench | 64.0% | 53.0% |
| AA Briefcase v1.1 | 1,657 | 1,546 |
出典:SpaceXSI|Introducing Grok 4.7
CursorBench 4.0は、長時間にわたるコーディングタスクを測る指標で、Terminal-Bench 4.0はターミナル操作を含む複数ステップの作業を評価します。CursorBenchでは5.9ポイント、Terminal-Benchでは17.3ポイント、Grok 4.7がGrok 4.6を上回っています。この結果から、長時間のコーディングやターミナル操作を伴う作業で性能が向上したと考えられます。
知識労働に関する評価でも、Grok 4.7はGrok 4.6を上回っています。数時間規模のオフィス業務を評価するAA Briefcase v1.1では1,657対1,546、電気工学の専門課題を評価するEEBenchでは64.0%対53.0%という結果でした。
この結果についてSpaceXSIは、資料作成やプレゼンテーションの品質が改善したと説明しています。調査から構成、清書までを一続きで任せる用途に向くといえるでしょう。
もっとも、ベンチマークの結果が実務での性能を保証するわけではありません。自社業務での検証方法は「Grok 4.7の導入前に確認したいこと」で紹介します。
Grok 4.7では、安全性を確保するための仕組みが刷新されました。SpaceXSIは、不適切な要求への拒否判断や、ジェイルブレイクへの耐性について、同社がこれまでに評価したモデルの中で最も高い性能を示したと説明しています。
デュアルユース(軍民両用)領域での評価も公開されています。LatchBioの生物安全性ベンチマークでは、62.4%を記録しました。サイバー領域では、危険な依頼をどこまで通すかを測るHackerBench v0.3で、リスクのあるデュアルユース・プロンプトを通した割合が3.3%にとどまっています。正当なセキュリティ業務を過度に拒否しない点もあわせて示されています。
とはいえ、企業が導入を判断するうえでは、安全性ベンチマークの結果に加え、利用目的や付与する権限、監査方法まで含めて検討することが大切です。
公式発表によると、Grok 4.7の価格と提供速度はGrok 4.6と同等です。
移行作業でまず変更が必要なのはモデルIDです。APIのリクエストで指定する文字列を「grok-4.7」に変更します。
次に押さえたいのが、Responses APIの挙動です。Grok 4.7では、includeに指定しなくても「reasoning.encrypted_content」が自動的に返却されます。会話履歴を自前で管理している場合は、返ってきたreasoningの項目を改変せず、次のリクエストのinputにそのまま引き継いでください。
Grok 4.6とGrok 4.5も、APIドキュメントに現在も掲載されており、引き続き利用できます。
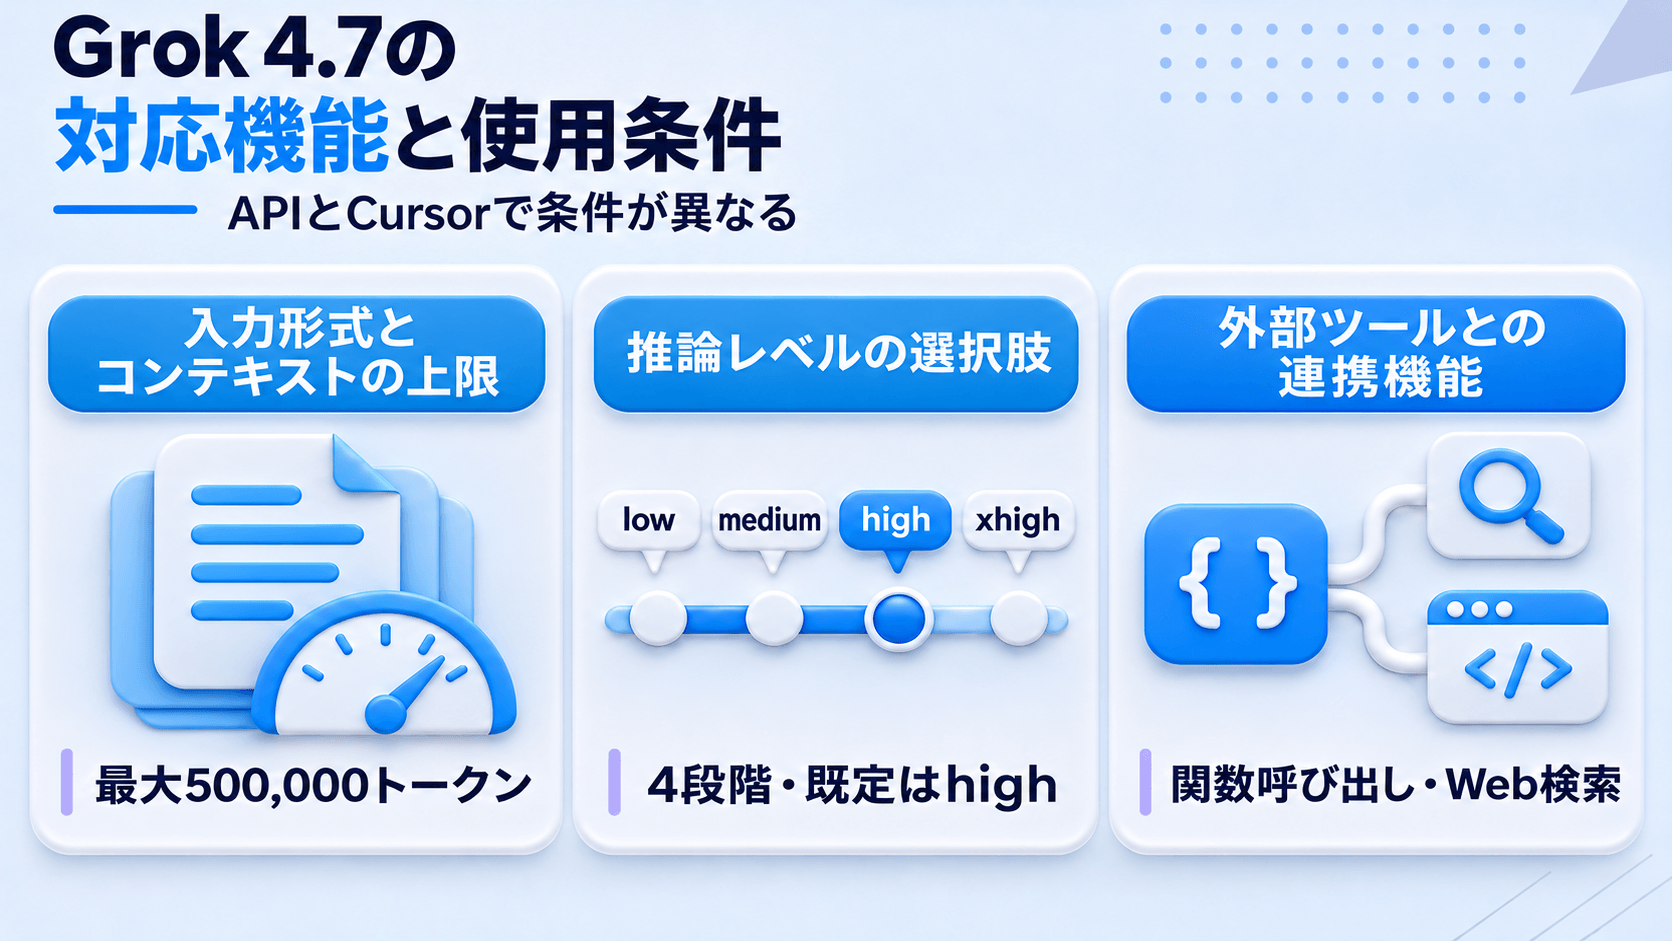
Grok 4.7は、APIで使うか統合開発環境で使うかによって、利用できる機能や料金区分が変わります。利用前に、それぞれの対応機能と条件を確認してください。
APIのコンテキストウィンドウ(500,000トークン)は、大量のコードや仕様書をまとめて渡す用途に対応します。
Cursor経由の場合は条件が変わり、標準のコンテキストは256,000トークン、長文コンテキストとして500,000トークンまで使える区分が用意されています。APIの上限である500,000トークンを前提にすると、Cursorの標準コンテキストには収まらない場合があります。
推論レベルはlow、medium、high、xhighの4段階で、既定値はhighです。xhighはGrok 4.6以降で利用可能です。
推論レベルの設定は、回答品質や応答時間、トークン使用量に影響します。lowは速度を優先する処理や単純なツール呼び出し、mediumは長文の推論やデータ分析に向いています。highは複数段階の論理的な推論、xhighは処理時間よりも回答品質を重視する難しい課題に適しています。Cursorでも同じ4段階が選べますが、プランによってはmedium固定・標準速度となる場合があります。
APIの主な機能は、関数呼び出しと構造化出力です。関数呼び出しを使うと、モデルがAPI呼び出しに必要な引数を返し、アプリ側で実行できます。構造化出力では、JSONなど指定した形式で結果を返せるため、ほかのプログラムでもデータを処理しやすくなります。このほか、Web検索、X検索、コード実行もサーバー側ツールとして提供されています。
なお、Cursor上のファイル操作やブラウザ操作はCursor側の機能です(詳しくは「Cursorで試す手順」で解説します)。
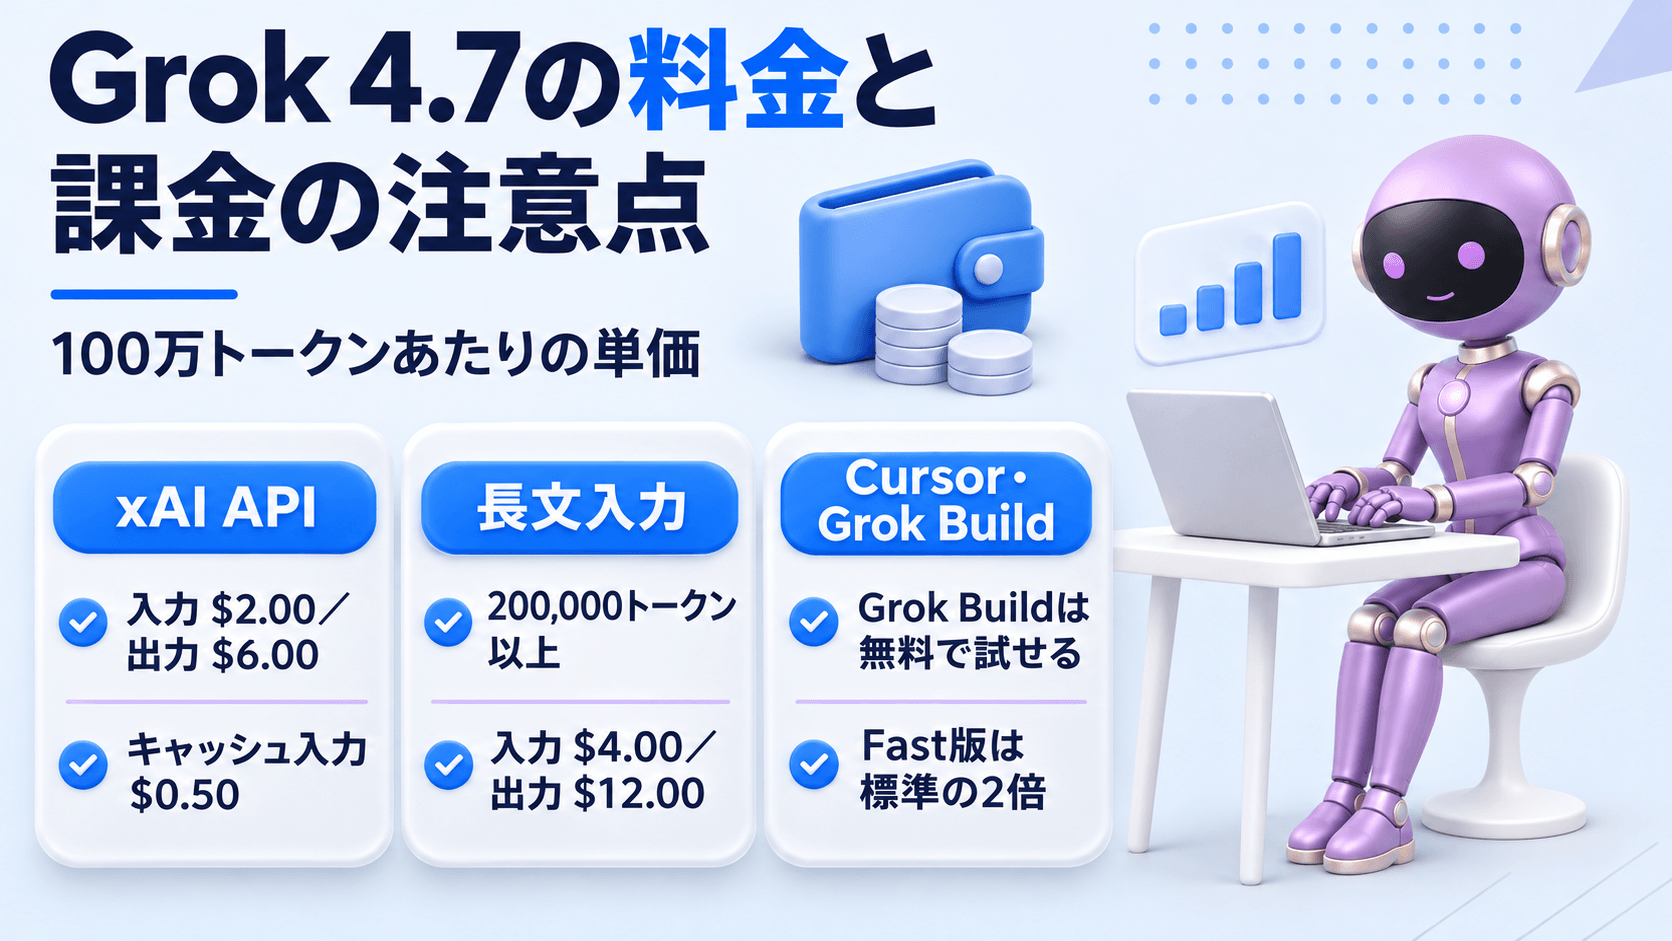
Grok 4.7の料金体系は、xAI APIのトークン従量課金と、CursorやGrok Buildのプラン課金の2つに分かれます。請求元や利用条件も異なるため、以下ではそれぞれ分けて解説します。
APIの料金は、入力、キャッシュ済み入力、出力の3区分で設定されています。長文を入力する場合は、通常と異なる単価が適用されます。
100万トークンあたりの単価は次のとおりです。
| 区分 | 100万トークン当たり | 適用の考え方 |
| 入力 | $2.00 | 標準コンテキストのAPI入力 |
| キャッシュ済み入力 | $0.50 | キャッシュが有効となった入力 |
| 出力 | $6.00 | 生成された出力トークン |
出典:SpaceXSI|Grok 4.7
キャッシュ済み入力の単価は入力の4分の1になるため、同じシステムプロンプトや参照文書を繰り返し使う業務ほど差が出ます。
Grok 4.7のAPI料金は、入力が200,000トークン以上になると長文料金が適用されます。100万トークンあたりの単価は、入力4.00ドル、キャッシュ済み入力1.00ドル、出力12.00ドルです。長い仕様書やコードベース全体を入力するなら、200,000トークンを超えるかどうかで費用が大きく変わります。
Cursorでは、Grok 4.7が有料プランに含まれるモデルプールから消費されます。プールを超えた追加利用は、次の単価が適用されます。
| Cursorの区分 | 入力/100万トークン | キャッシュ入力 | 出力/100万トークン |
| 標準(256K以下) | $2 | $0.50 | $6 |
| Fast(256K以下) | $4 | $1 | $12 |
| 長文500K(標準) | $4 | $1 | $12 |
| 長文500K(Fast) | $6 | $1.50 | $18 |
Cursorの長文判定は256,000トークンです。xAI APIの200,000トークンとは基準が異なるため、混同しないよう注意しましょう。
なお、Cursorの長文課金は入力長のみで判定され、256,000トークン以下ならリクエスト全体が標準単価で計算されます。
Grok Buildでは、通常版のGrok 4.7を無料で試せます。
Fast版は、この無料枠に含まれません。Fast版は同じモデルを高速な基盤で提供するもので、料金は標準の2倍、長文リクエストでは1.5倍になります。提供範囲はCursorとGrok Buildに限られ、公開されているxAI APIでは利用できません。
単価が同じでも、1業務あたりの費用が一定になるとは限りません。推論に使われるトークン量と、ツール呼び出しの回数によって変動します。推論トークンも課金対象に含まれるため、xhighを常用すると出力側の費用が膨らみます。
実際の利用料金は、APIレスポンスのusageに含まれる「cost_in_usd_ticks」で確認できます。1ドルは10,000,000,000ティックとして表され、リクエスト単位の実費がそのまま返ります。キャッシュ割引やサーバー側ツールの呼び出しも反映済みです。この値はターンをまたいで累積しないため、会話全体の費用を知りたい場合は手動で合算します。
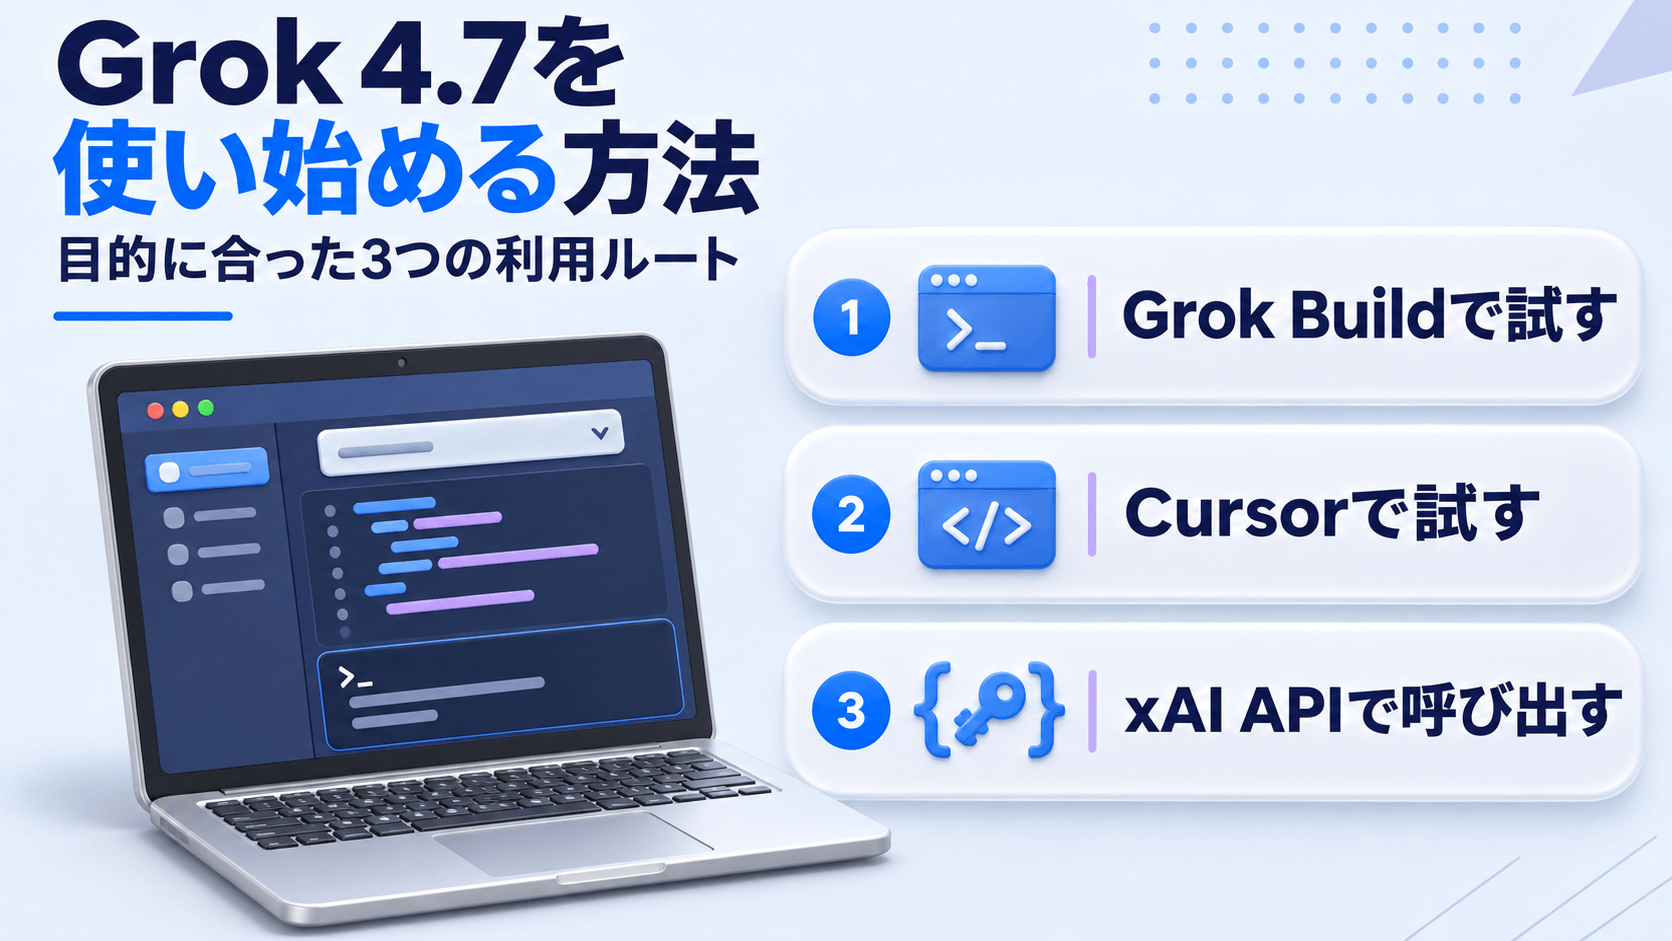
Grok 4.7の利用方法は、APIから直接呼び出す方法と、Grok BuildやCursorなどの開発ツールを使う方法に大別できます。APIを利用する場合は初期設定が必要ですが、開発ツールではモデルの選択など、ツール側の操作が中心になります。
Grok Buildは、SpaceXSIのコーディングエージェントです。公式サイトの案内から利用を開始し、作業対象のフォルダーを指定して指示を出します。Grok 4.7はこのエージェントの既定モデルになっています。
試す際は、作業フォルダーと権限の範囲を先に確認してください。書き込み可能な範囲を絞っておけば、意図しないファイル変更を避けられます。
Cursorでは、モデル選択画面からGrok 4.7を選び、修正したいコードに対して指示を出します。修正後は変更差分を確認し、テストを実行して問題がないか検証します。
このとき、ファイル編集やブラウザ操作はCursorのエージェント機能が担っています。評価の際は、モデルの性能とツールの出来を切り分けて見ましょう。混同したままだと、別の環境に移したときに期待どおりに動かないおそれがあります。
APIを使う場合は、まずconsole.x.aiでアカウントを作成し、クレジットを追加します。次にAPIキーを発行し、環境変数XAI_API_KEYに設定してください。その後、Responses APIのリクエストでモデルID「grok-4.7」を指定すると、APIを呼び出せます。
実装では、会話ごとにprompt_cache_keyを指定するとキャッシュが効きやすくなります。推論に時間がかかる処理では、ストリーミングを有効にするとともに、処理時間に応じてタイムアウトを設定します。
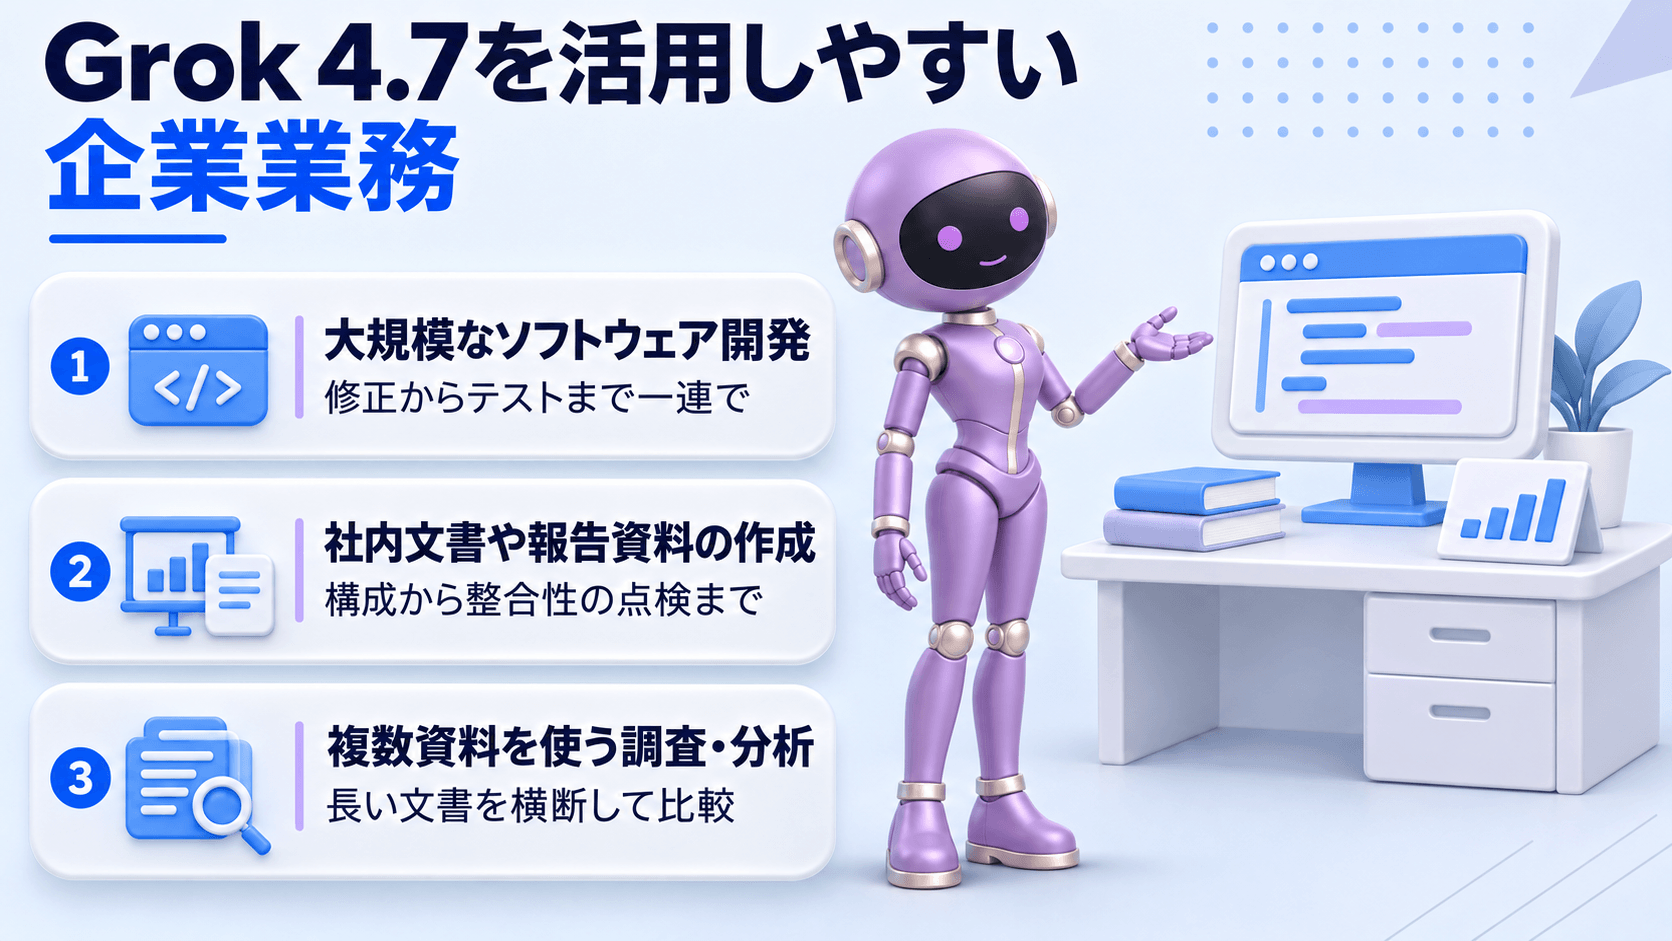
Grok 4.7は、複数の工程にまたがる作業への対応を強化したモデルです。業務に導入する際は、AIに任せる作業の範囲と、人が確認する工程をあらかじめ決めておくと運用が安定します。
複数ファイルにまたがる不具合の修正、コードレビュー、テストの再実行といった作業が代表例です。原因の調査から修正、検証までを一連の作業として進められるため、調査と実装の往復にかかる時間の短縮が期待できます。
ただし、修正を採用する前には、単体テストの実行や変更範囲・権限の確認が必要です。モデルが自己検証を行う場合でも、本番環境への反映は人が判断する運用としてください。
調査メモから構成を組み立て、資料全体の整合性を点検し、社内向けのドラフトにまとめる用途にも活用できます。章ごとのトーンを揃えたり、数値の食い違いを見つけたりする作業は、長い文脈を扱えるモデルの得意分野です。
一方で、成果物に誤りが混じることもあるため、最終的な数値、出典、社外秘情報の扱いについては、担当者による再確認が必要です。
長い文書や画像を含む資料から観点を抽出し、比較表に整理するような使い方も可能です。500,000トークンの文脈長は、複数資料の横断的な比較に向いています。
前述のとおり、モデル自体の文脈長と、各ツール上で実際に使える上限は一致しません。また、長文料金が適用される場合もあるため、入力する資料のトークン数を確認し、必要な費用を見積もってください。
関連記事:Grok Botとは?料金・使い方・セキュリティを徹底解説
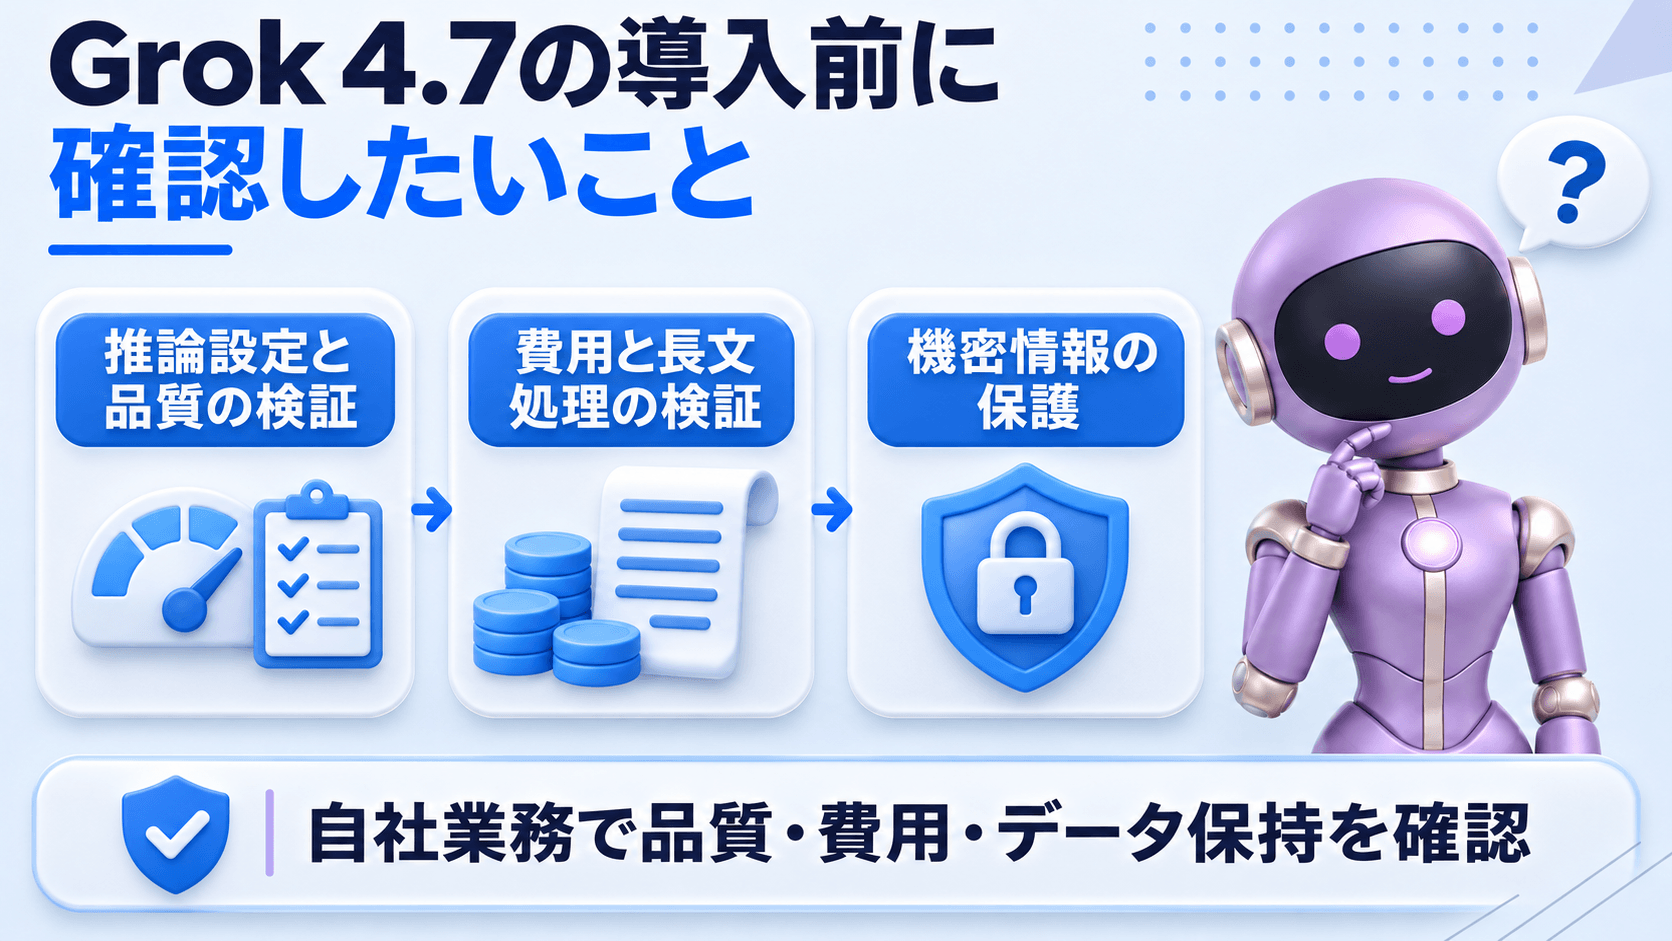
導入の判断には、公開ベンチマークだけでなく、自社業務での正確性や再現性、運用費の検証が欠かせません。以下では、3つの確認項目を紹介します。
同じ業務課題を使い、lowからxhighまでの各推論レベルで結果を比較します。評価する項目は、成功率、応答時間、トークン使用量の3つです。設定を変えると結果も費用も変わるため、条件を揃えた比較表を作っておくと判断しやすくなります。
運用時は、既定値に任せず推論レベルを明示的に指定しておくと、費用と待ち時間を制御しやすくなります。既定はhighですが、タスクの難易度に合わせて意図的に選ぶ形が基本です。
Grok 4.7は、入力が一定の長さを超えると単価が上がる長文料金を採用しており、その基準はAPIが200,000トークン、Cursorが256,000トークンと異なります。同じ内容でも利用環境によって料金が異なるため、実際の入力トークン数と請求額を確認する必要があります。あわせて、キャッシュの効き方とリクエスト単位の請求額も測っておくと、見積もりの精度が上がります。
APIの既定では、リクエストとレスポンスが不正利用の監査目的で30日間保存され、そのデータで学習されることはありません。より厳しい要件がある場合は、ゼロデータ保持(ZDR)を有効にする選択肢があります。ただし、ZDRを有効にすると、状態を保持するResponses APIやFiles、Collections、Batch APIなどが使えなくなるため、利便性とのトレードオフを踏まえて判断するとよいでしょう。
運用面では、アクセス権の管理、監査ログの取得、成果物の確認体制をまず整えておきます。また、コードや社内資料を入力する際の承認手順を定め、ログを定期的に確認する運用も検討してください。
Grok 4.7は、コーディングと知識労働に重点を置いて開発されたSpaceXSIのAIモデルです。Grok 4.6と同等の価格・提供速度を維持しながら、長時間タスクへの対応力や自己検証能力を高めています。ベンチマークのスコアは向上していますが、推論設定が異なる測定もあるため、条件とあわせて読む必要があります。
料金は、APIが入力100万トークンあたり2.00ドル、出力6.00ドル、キャッシュ入力0.50ドルです。入力が200,000トークン以上になると長文料金が適用され、Cursorは256,000トークンを境に単価が変わります。Fast版はCursorとGrok Buildに限られます。
導入前には、自社の業務で出力品質を比べ、長文入力時の費用やデータの保持条件もあわせて確認しておくと安心です。
アイスマイリーでは、生成AI のサービス比較と企業一覧を無料配布しています。課題や目的に応じたサービスを比較検討できますので、ぜひこの機会にお問い合わせください。
\ AIエージェントの活用事例を、無料でチェック /
業務の課題解決に繋がる最新DX・情報をお届けいたします。
メールマガジンの配信をご希望の方は、下記フォームよりご登録ください。登録無料です。


FOLLOW US
SNSをフォローして、最新情報をチェックできます!


AI製品・ソリューションの掲載を
希望される企業様はこちら