


生成AI
最終更新日:2026/10/05
 RLHFとは?
本記事では、AIモデルを人間の意図に沿うよう調整する技術であるRLHF(Reinforcement Learning from Human Feedback)について解説します。
意味や学習ステップ、ファインチューニングとの違いに加え、メリット・活用事例・課題・代替手法まで取り上げるので、AIモデルの開発や導入の検討にお役立てください。
RLHF(アールエルエイチエフ)とは、Reinforcement Learning from Human Feedbackの略で、「人間のフィードバックからの強化学習」を意味する技術です。人間の意図や価値基準に沿った出力をするように、AIモデル、特に大規模言語モデル(LLM)を強化学習によって微調整(ファインチューニング)する手法を指します。
RLHFの基礎となる手法は、2017年にOpenAIとDeepMind(現Google DeepMind)の研究者が論文で発表しました。当初は、ゲームやロボットの動作のシミュレーションを対象に、人間が2つの動きを見比べた結果から学習させる手法でした。その後、OpenAIが言語モデルの調整に応用し、対話型AIの開発で広く使われるようになっています。
強化学習は機械学習の一種であり、試行錯誤を通じて与えられた課題を処理する学習方法です。
強化学習の基本的な仕組みは以下の通りです。
例えば、チェスのAIを強化学習で訓練する場合、エージェントはチェスのAI、環境はチェスのゲーム盤面、行動は駒の動かし方、報酬は勝利や有利な局面の獲得などになります。AIは多数の対局を通じて、どの行動が高い報酬につながるかを学習し、徐々に強くなっていきます。
強化学習の特徴は、明示的な教師データを必要としない点です。代わりに、試行錯誤を通じて最適な行動の選び方を見つけ出します。これにより、複雑な問題や動的な環境に対しても柔軟に対応できるモデルを作れます。RLHFは、この強化学習の枠組みに「人間のフィードバック」という要素を加えたものといえます。
ファインチューニングとは、事前学習済みのモデルに追加の学習を行い、特定のタスクや目的に合わせて調整することです。RLHFもファインチューニングの手法の一つです。ただし、単に「ファインチューニング」という場合は、通常、正解データを使って学習させる教師ありファインチューニング(SFT:Supervised Fine-Tuning)を指します。
教師ありファインチューニングとRLHFの主な違いは以下の通りです。
| 項目 | 教師ありファインチューニング(SFT) | RLHF |
|---|---|---|
| 学習の目的 | 特定のタスクに対するモデルの性能向上 | 人間の価値観や意図に沿った出力を生成 |
| 学習データ | タスク固有のラベル付きデータセット | 人間からのフィードバック(評価や順位付け等) |
| 学習プロセス | 通常の教師あり学習(損失関数の最小化) | 強化学習(報酬の最大化) |
| 適用範囲 | 主に特定のタスクや領域に対する性能向上 | モデルの全般的な振る舞いや倫理的側面の改善 |
例えば、感情分析タスクのためにBERTモデルを教師ありファインチューニングする場合、感情ラベル付きのテキストデータを使用して学習を行います。一方、RLHFを用いてChatGPTの応答を改善する場合、モデルの出力に対する人間の評価を基に学習を進めます。
教師ありファインチューニングとRLHFは、どちらか一方を選ぶものではありません。ChatGPTのような対話型のLLMでは、まず教師ありファインチューニングで指示に沿って答える形を学ばせ、その後にRLHFで人間の好みに合わせて調整する手順がとられます。
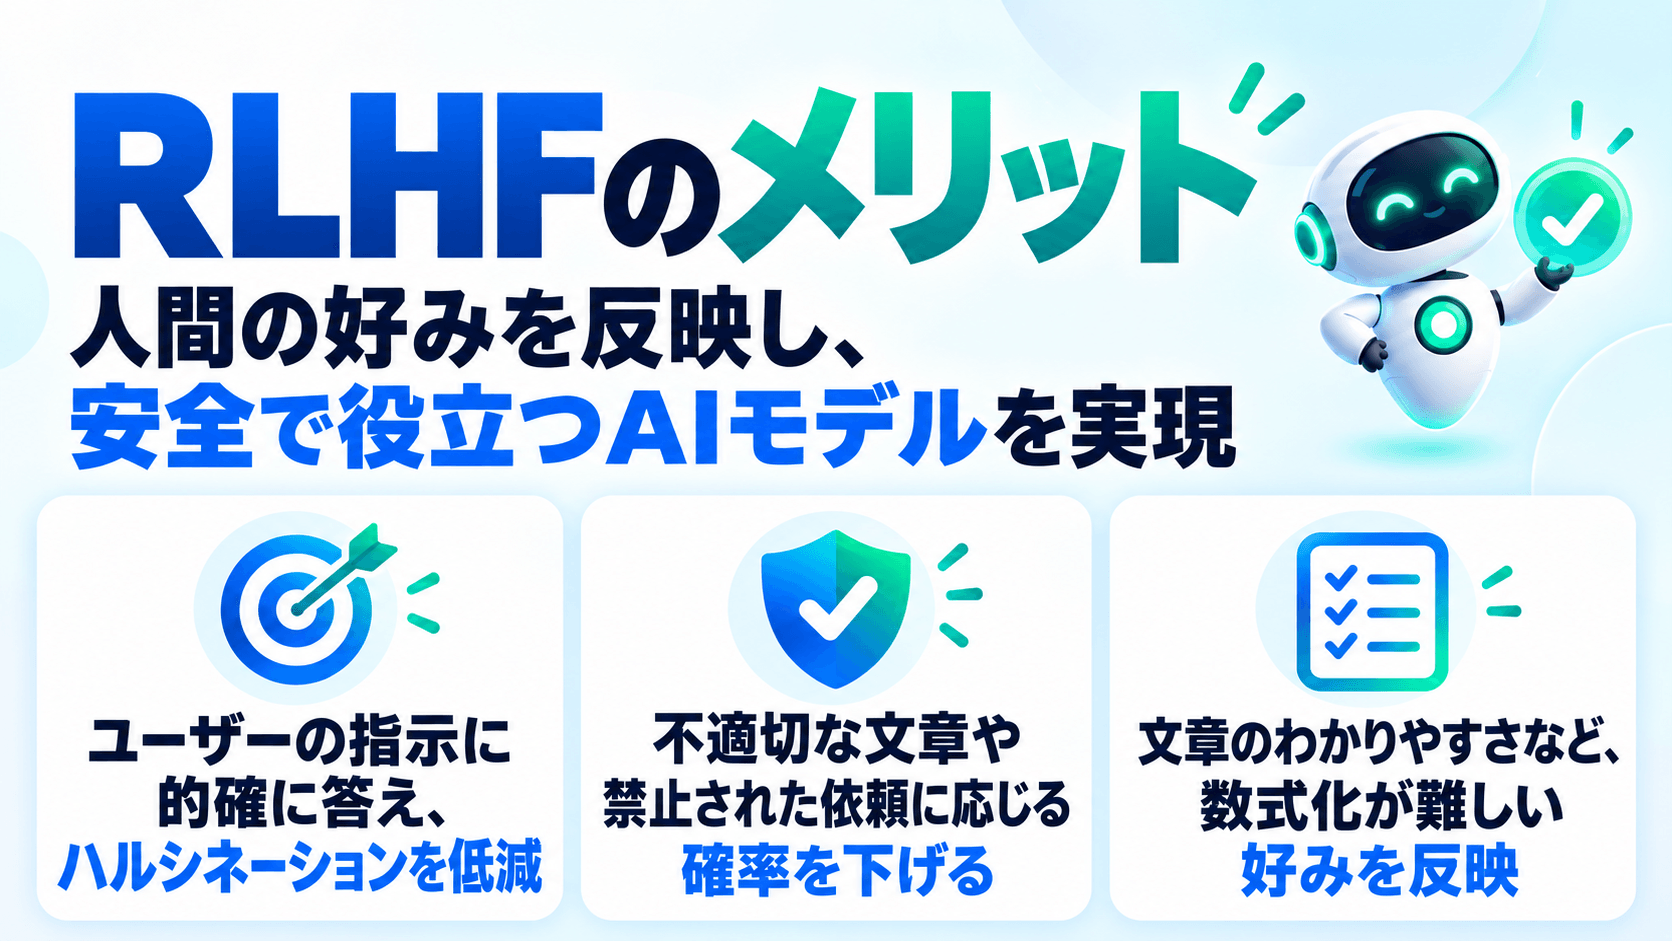
大規模な事前学習を終えた言語モデルは、大量の文章から次に来る単語を予測する力を身につけています。ただし、その力だけでは、ユーザーの指示に沿って役立つ回答をしたり、有害な依頼を断ったりするとは限りません。RLHFは、事前学習で得た知識を生かしたまま、回答の仕方を人間の好みに近づけるための工程です。
OpenAIは2022年1月、GPT-3をRLHFで調整した「InstructGPT」を発表しました。評価者が回答を比べたところ、パラメータ数13億のInstructGPTの回答が、100倍以上大きい1,750億パラメータのGPT-3の回答よりも好まれたと報告されています。
また、論文によると、要約など入力文をもとに答えるタスクでは、入力にない情報を作り出すハルシネーションの割合も、GPT-3の41%からInstructGPTでは21%に下がりました。
言語モデルはインターネット上の大量の文章で学習するため、そのままでは不適切な文章を生成することもあります。評価の基準に安全性を含めてRLHFを行えば、事前学習をやり直さずに、有害な出力を抑えるようにモデルを調整できます。
OpenAIの発表によると、2023年3月に発表したGPT-4ではRLHFの学習中に有害な出力を減らすための報酬を追加するなどの対策により、禁止された内容の依頼に応じる確率がGPT-3.5より82%減りました。
文章のわかりやすさや感じのよさは、数式やルールで定義するのが難しい性質です。教師ありファインチューニングでは、人間が理想の回答を一つずつ書いて正解データを用意する必要があり、作成に手間がかかります。
一方、複数の回答を読み比べてよいほうを選ぶだけなら、理想の回答を一から書くより人間にとって判断しやすくなります。RLHFはこうした比較の結果をもとに学習するため、正解を一つに決めにくいタスクでも、人間の好みに近い回答を増やせます。
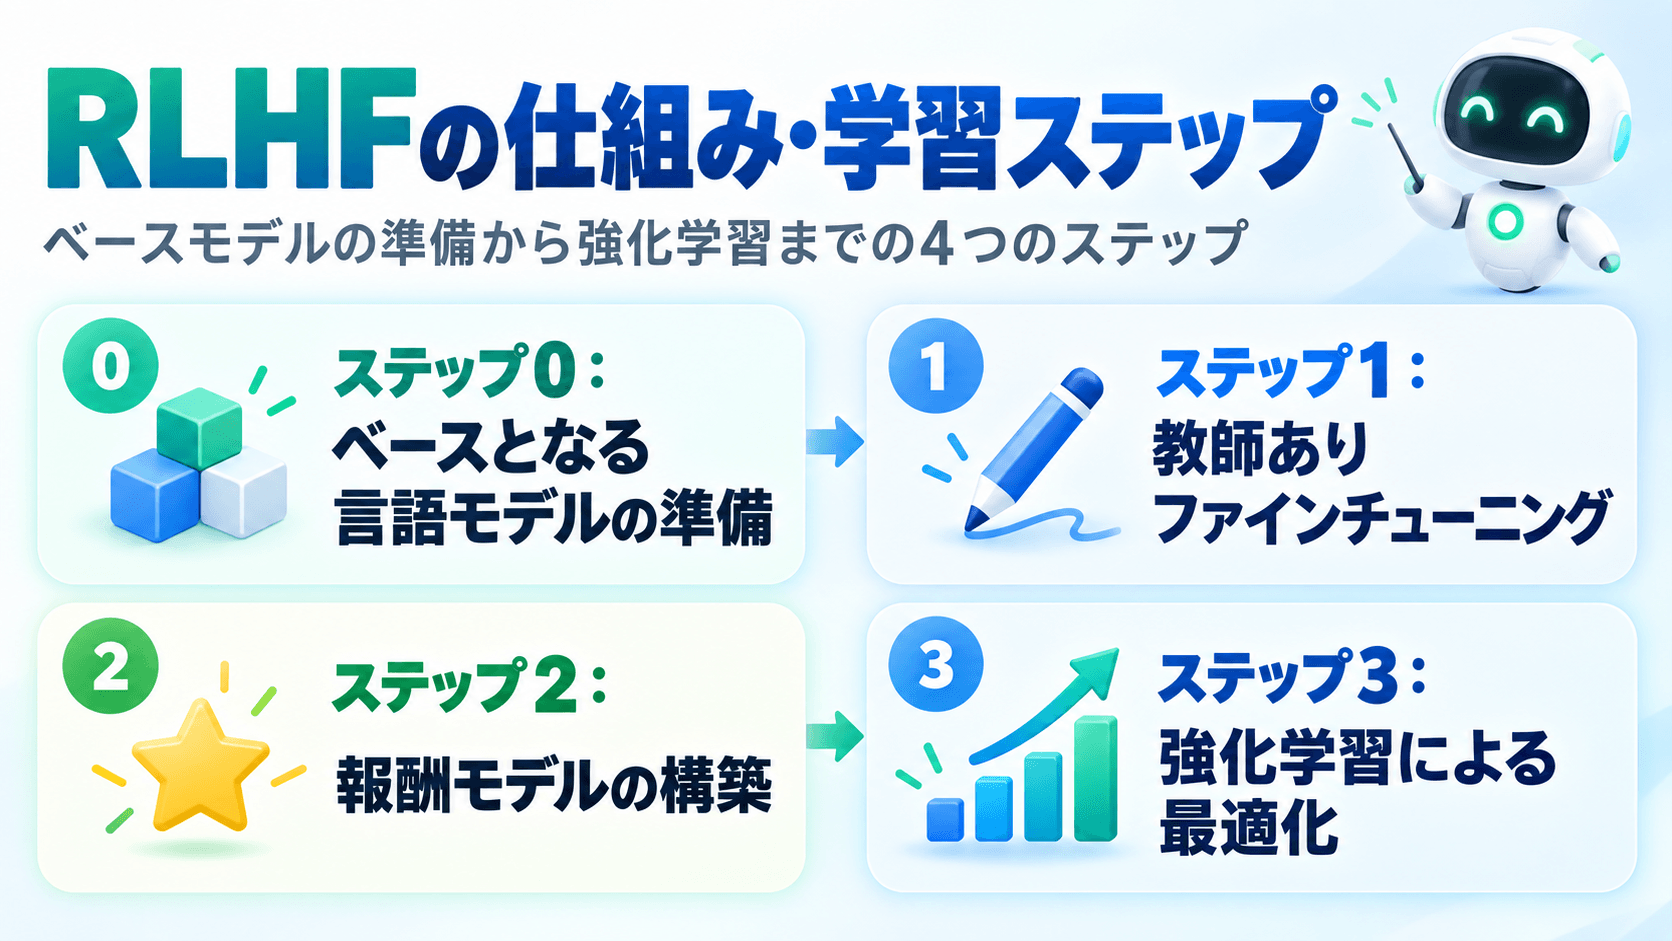
RLHFの学習は、出発点となる言語モデルの準備を含めて、次の4ステップで進みます。ステップ1〜3の流れは、OpenAIがInstructGPTやChatGPTの開発で公開した手順と同じです。
学習ステップ0はRLHFの準備段階で、事前学習済みの言語モデルを用意します。自社で事前学習したモデルのほか、MetaのLlamaやGoogleのGemmaなど、重み(パラメータ)が公開されているオープンモデルから、タスクの性質やモデルの規模を考慮して選ぶ方法もあります。十分なGPUやメモリなどの計算リソースも確保します。
また、モデルの評価や微調整に使用するデータセットを用意し、モデルの性能を測るための評価指標を決定します。さらに、後のステップで回答の評価(アノテーション)を担当する人間の評価者を確保し、どのような回答を高く評価するかを示すガイドラインも決めておきます。
学習ステップ1では、選択したベースモデルに対して初期の微調整を行います。まず、タスクに関連する多様なプロンプト(AIへの指示文)を用意し、それぞれに対する理想的な回答を人間の専門家が作成します。これらのプロンプトと回答のペアを正解データとして、ベースモデルを追加で学習させます。
学習率やバッチサイズなどのハイパーパラメータの調整も行い、学習の効率と効果を最適化します。過学習を防ぐため、検証データセットを使用してモデルの汎化性能を監視しながら学習を進めます。最後に、微調整されたモデルの性能を評価し、後続のステップでの改善を測る基準となる指標を記録します。
学習ステップ2では、人間のフィードバックを基に報酬モデルを構築します。まず、ステップ1とは別の多様なプロンプトを用意し、微調整したモデルを使って各プロンプトに対する複数の応答を生成します。次に、人間の評価者がこれらの応答を読み比べ、よいと思う順に並べます。応答ごとに点数を付ける方法もありますが、Hugging Faceの解説によると、点数は評価者ごとに基準がそろいにくく、複数の応答を比べた順位のほうが学習データとして扱いやすいとされています。
この評価データを使用して、応答の質を予測する報酬モデルを訓練します。報酬モデルは、プロンプトと応答のペアを入力として受け取り、その応答の「よさ」を数値化して出力します。最後に、訓練された報酬モデルの性能を検証し、必要に応じて調整を行います。
学習ステップ3では、ステップ2で構築した報酬モデルを使用して、言語モデル(強化学習の用語では、行動の選び方を決める「方策」にあたります)を最適化します。多様な入力プロンプトを含むデータセットを用意し、現在の言語モデルを使ってそれらのプロンプトに対する応答を生成します。生成された応答は報酬モデルによって評価され、スコアが付与されます。
このスコアを基に、言語モデルのパラメータを更新します。この過程では通常、PPO(Proximal Policy Optimization)などの強化学習アルゴリズムが使用されます。このステップを繰り返すことで、言語モデルは徐々に改善され、より高品質な応答を生成できるようになります。
ただし、報酬を高めることだけを目指して更新を続けると、言語モデルの出力が元のモデルから大きく離れ、不自然な文章になることがあります。そのため、強化学習を始める前のモデルの出力から離れた度合い(2つの確率分布の違いを測る指標「KLダイバージェンス」)に応じて報酬を差し引く「KLペナルティ」を加え、自然な文章の書き方を保ちながら調整します。
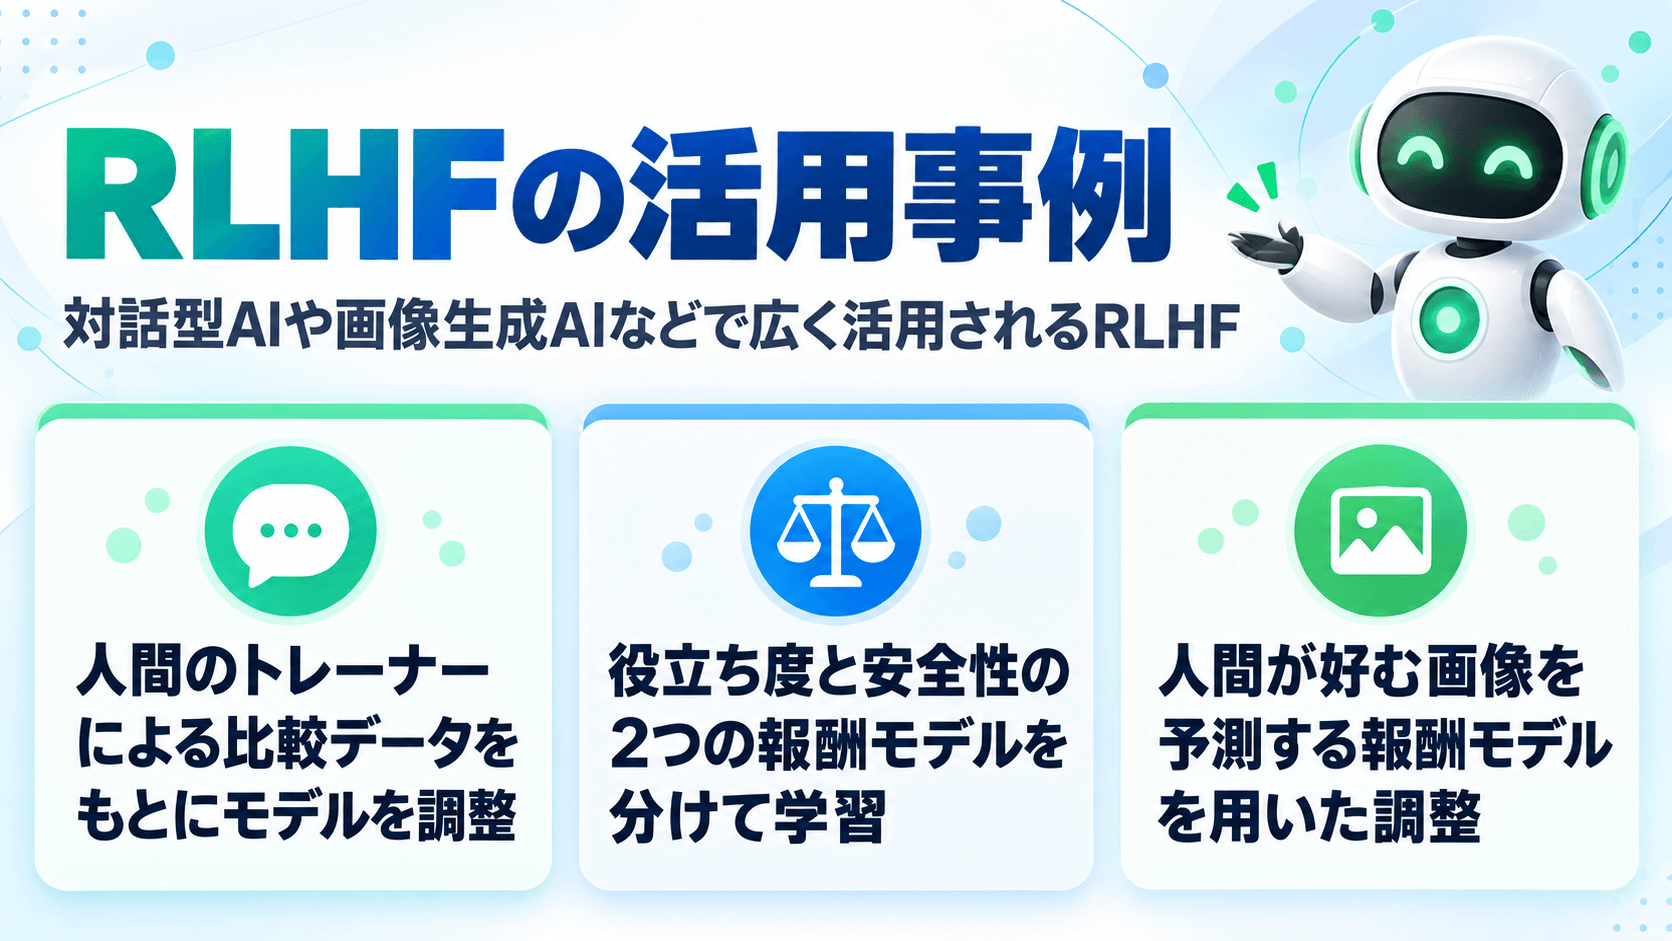
RLHFは、対話型のAIを中心に、人間の好みや安全性の基準を出力に反映させたい場面で使われています。評価データの集め方や報酬モデルの作り方は、開発元によって異なります。
OpenAIが2022年11月に公開したChatGPTは、RLHFが広く知られるきっかけになったサービスです。OpenAIの発表によると、GPT-3.5シリーズのモデルをもとに、InstructGPTと同じRLHFの手法で調整されました。
教師ありファインチューニングでは、人間のAIトレーナーがユーザーとAIアシスタントの両方の役を演じて会話データを作成しています。報酬モデルの学習には、トレーナーがモデルの複数の回答を品質順に並べた比較データを使いました。比較データの収集からPPOによる調整までを、何度か繰り返しています。
Metaが2023年7月に公開したLlama 2では、対話向けモデル「Llama 2-Chat」の調整にRLHFが使われました。論文によると、人間が2つの回答を比べた100万件以上のデータを集め、回答の役立ち度(Helpfulness)を評価する報酬モデルと、安全性(Safety)を評価する報酬モデルを別々に学習させています。
報酬モデルを分けたのは、役立ち度と安全性は一方を高めるともう一方が下がる場合があり、一つの報酬モデルで両方を正しく評価するのが難しいためです。強化学習では、PPOに加えて、複数の回答から報酬の高いものを選んで学習し直す「棄却サンプリング(Rejection Sampling)」も組み合わせました。
画像生成AIにRLHFの考え方を応用する場合は、同じプロンプトから生成した複数の画像を人間が比べて評価し、その結果から人間が好む画像を予測する報酬モデルを作ります。
中国の清華大学などの研究チームが2023年4月に発表した「ImageReward」は、専門家による13万7,000件の比較データで学習した、画像生成向けの報酬モデルです。論文では、ImageRewardを使って画像生成モデルを調整する手法も提案されています。
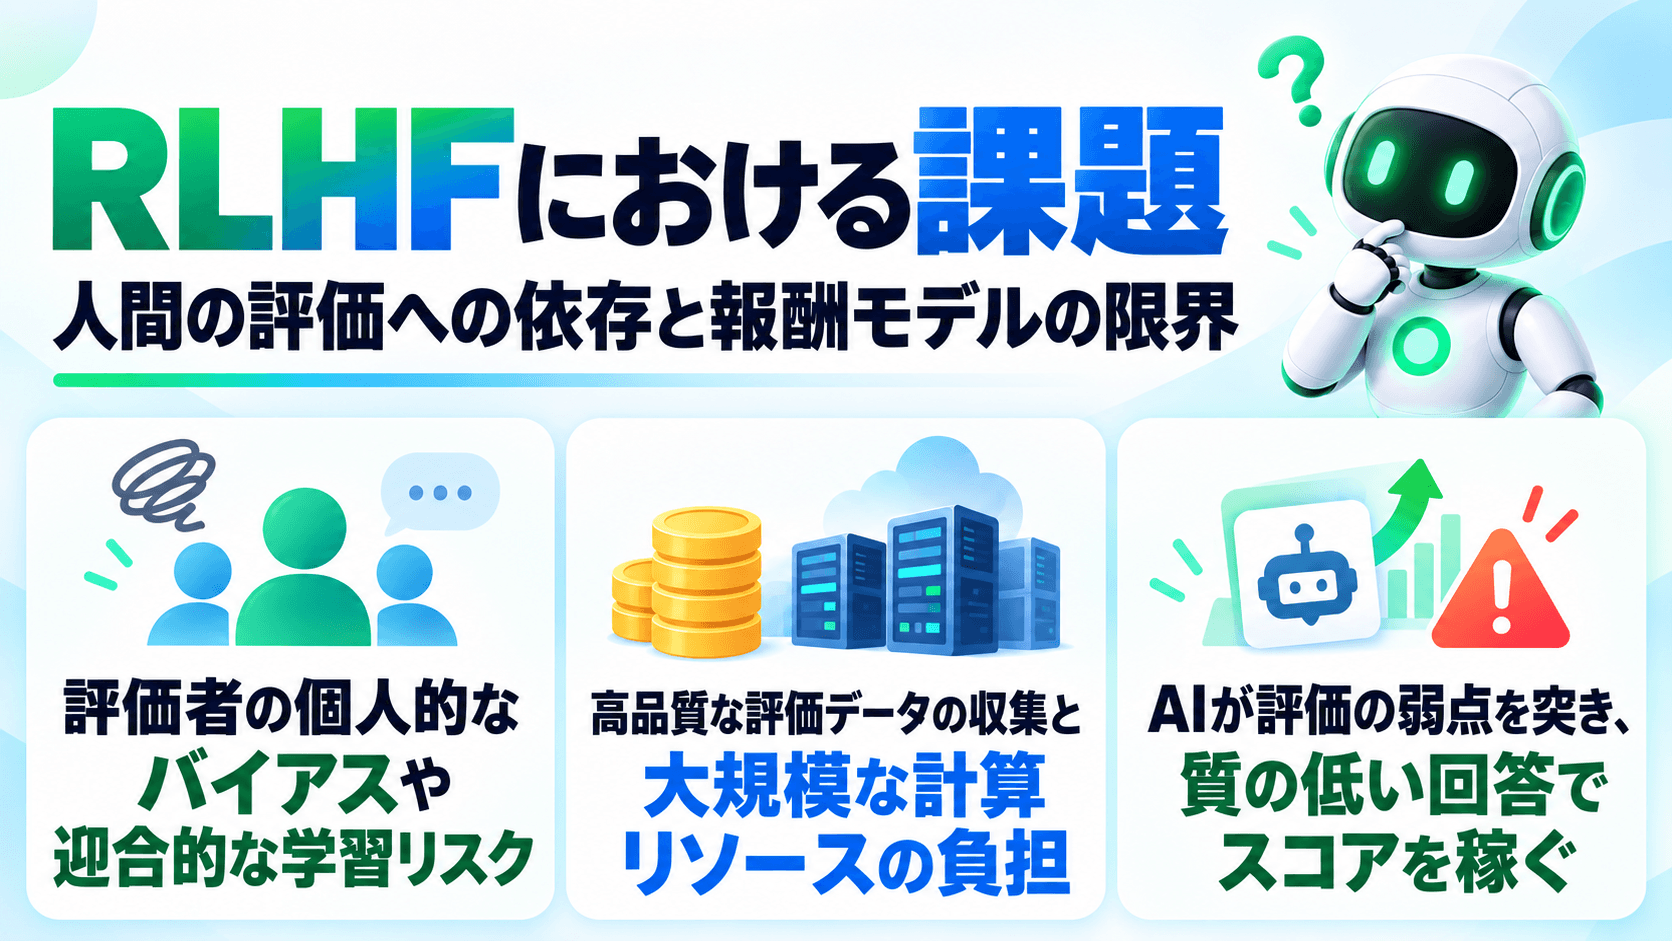
RLHFでは、人間の評価と、その評価を学んだ報酬モデルがモデルの振る舞いを決めます。そのため、評価する人の側と、報酬モデルで採点する仕組みの側の両方に課題があります。
人間のフィードバックの質は、モデルの性能に直接影響します。不適切または偏ったフィードバックは、モデルの行動に悪影響を及ぼす可能性があります。例えば、評価者の個人的なバイアスがAIの学習に反映されてしまうことや、評価者によって判断が一貫しないことも問題です。
対策として、評価の基準を細かく定めたガイドラインを用意し、評価者の選定と訓練を厳密に行って、フィードバックの質を高める取り組みが行われています。
評価する側が、自分の意見に同意する回答や耳に心地よい回答を高く評価すると、モデルがユーザーに迎合する方向に学習してしまうこともあります。OpenAIは2025年4月25日のGPT-4oアップデートによって迎合的な回答が目立つようになったため、4月28日から更新の取り消しを始めました。OpenAIの説明によると、ユーザーの高評価・低評価のデータに基づく報酬の追加などの変更が重なり、迎合を抑えていた主な報酬の影響が弱まったとみられています。
また、モデルの能力が上がるほど回答の誤りは見つけにくくなり、人間だけで正確に評価するのは難しくなります。OpenAIは2024年6月、RLHFの評価者がChatGPTの回答の誤りを見つけやすくするため、回答への指摘を書くモデル「CriticGPT」を発表しました。ChatGPTが書いたコードを確認する実験では、CriticGPTの支援を受けた人の指摘が、支援のない人の指摘より好まれる割合は60%を超えたとしています。
高品質なフィードバックの収集には、多大な時間・労力・費用がかかります。特に専門知識が必要な分野では、適切な評価者の確保が困難で高コストになります。さらに、学習自体にも大規模な計算リソースが必要です。PPOを使う場合は、学習中の言語モデルに加えて、報酬モデルや比較用の元のモデルも用意し、生成した回答を一つずつ報酬モデルで採点しなければなりません。
報酬ハッキングとは、言語モデルが報酬モデルの弱点を突き、人間から見ると質の高くない回答で高いスコアを得るようになる現象です。報酬モデルは人間の評価を近似したものにすぎません。強化学習で報酬を高め続けると、報酬モデルが評価しがちな特徴だけが強まることがあります。
例えば、報酬モデルが長い回答を高く評価する傾向を持っていると、学習後のモデルの回答が必要以上に長くなることが研究で指摘されています。対策としては、学習ステップ3のKLペナルティで元のモデルから離れすぎないようにするほか、新しい回答で評価データを集め直し、報酬モデルを更新する方法がとられています。
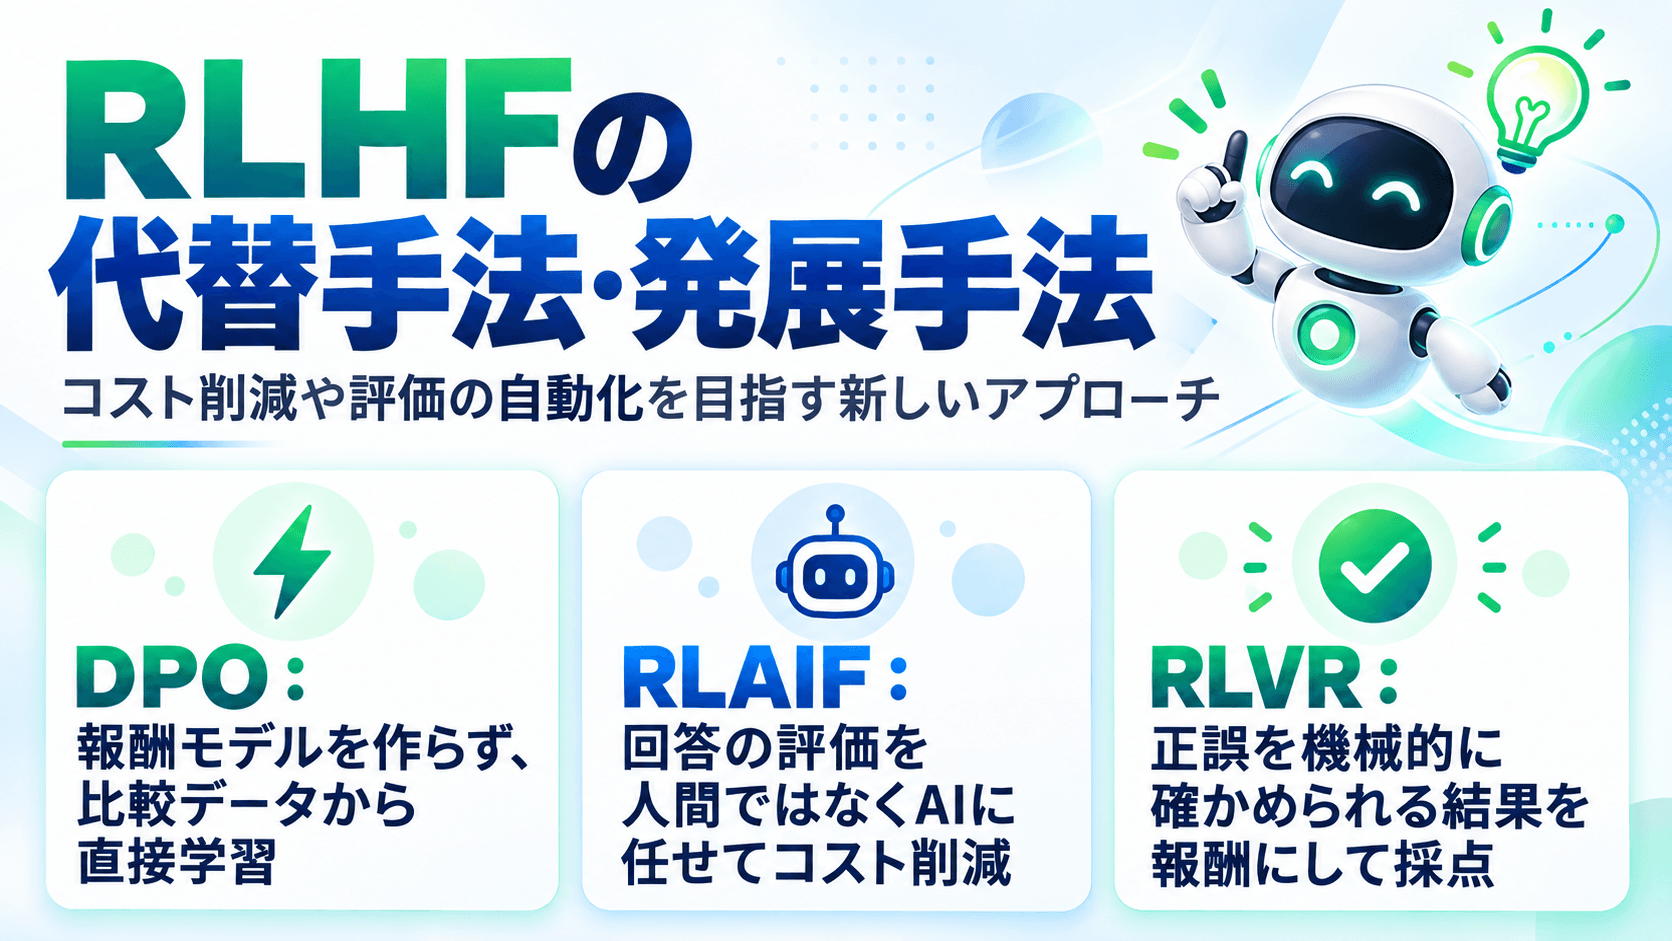
RLHFの課題を補うため、2022年末以降、人間の評価や報酬モデルへの依存を減らす手法が相次いで発表されています。現在の開発では、RLHFだけでモデルを調整するのではなく、目的に応じて複数の手法を組み合わせるのが一般的です。
DPO(Direct Preference Optimization)は、2023年5月にスタンフォード大学の研究者らが発表した手法です。RLHFと同じく「2つの回答のうちどちらが好ましいか」を示す比較データを使いますが、報酬モデルを別に作らず、強化学習も使わずに、比較データから直接言語モデルを学習させます。
仕組みが単純なため、PPOを使うRLHFより実装しやすく、計算の負担も小さく抑えられます。論文では、要約や対話のタスクで、PPOを使うRLHFと同等以上の性能を示したと報告されています。
RLAIF(Reinforcement Learning from AI Feedback)は、回答の評価を人間ではなくAIに任せる手法です。代表的な例が、Anthropicが2022年12月に表した「Constitutional AI」です。有害かどうかの判断では、人間は「有害な内容を避ける」といった原則のリスト(憲法)を用意するだけで、AIが原則に照らして回答を比べた結果を報酬モデルの学習に使います(役立ち度の評価には人間の比較データも使われています)。
人間による評価の手間を減らせる一方、評価するAIに偏りや誤りがあれば、そのまま学習に反映されます。
RLVR(Reinforcement Learning with Verifiable Rewards)は、数学の答えが合っているか、プログラムがテストを通るかといった、正誤を機械的に確かめられる結果を報酬にする手法です。Allen Institute for AI(Ai2)が2024年11月に公開したオープンモデル「Tulu 3」の論文で名付けられました。Tulu 3は、教師ありファインチューニング・DPO・RLVRの順に学習させています。報酬モデルではなくルールで採点するため、報酬ハッキングを避けやすい点が特長です。
中国のDeepSeekが2025年1月に公開した推論モデル(回答の前に考える過程を生成するモデル)「DeepSeek-R1」も、同じ考え方で学習しています。論文によると、数学やプログラミングの問題を正誤と出力形式のルールで採点し、GRPO(同じ問題への複数の回答の点数を比べて学習する強化学習の手法)で推論する力を高めました。開発チームは、ニューラルネットワークによる報酬モデルは大規模な強化学習で報酬ハッキングを受けやすいとして、推論の学習には使っていません。
ただし、DeepSeek-R1も最終段階では、役立ち度と安全性を評価する報酬モデルを使って人間の好みを反映させています。RLVRが力を発揮するのは正解のある課題で、文章の自然さや感じのよさといった好みの反映には、引き続きRLHFやDPOが使われています。
RLHFで調整された言語モデルのことです。GPT-3をもとにRLHFで調整したInstructGPTのほか、ChatGPT・Llama 2-Chatが該当します。これに対し、事前学習だけを終えて調整を加えていないモデルは「ベースモデル」などと呼ばれ、区別されます。
RLHFの主な役割は、新しい知識を加えるのではなく、事前学習で身につけた能力を、指示に沿って答える形で使えるようにすることです。OpenAIはGPT-4の発表で、モデルの能力は主に事前学習で身につくとみられ、試験問題の成績はRLHFでは向上しない(工夫しなければむしろ下がる)と説明しています。一方で、事前学習だけのモデルは、質問に答えるべきだと理解させるだけでもプロンプトの工夫が必要だとも述べています。
公開中のオープンモデルをベースにすれば、自社でも取り組めます。Hugging Faceのオープンソースライブラリ「TRL」には、教師ありファインチューニング・報酬モデルの学習・DPOなどを実行する機能があります(RLHFで使われるPPOは実験的な機能の扱いです)。
まずは自社の用途でどのような回答をよいとするかの基準を決め、評価者が回答を比べたデータを集めましょう。報酬モデルと強化学習を使うRLHFは手順が多く計算リソースも必要になるため、同じ比較データで学習できるDPOから試すのも選択肢の一つです。
RLHFは、人間が回答を比べて評価した結果をもとに、強化学習でAIモデルを調整する手法です。ファインチューニングの一種で、教師ありファインチューニングの後に行うのが一般的です。人間の意図に沿った回答の生成や有害な出力の抑制につながり、InstructGPT・ChatGPT・Llama 2などの開発で使われてきました。
学習は、ベースとなる言語モデルの準備から始まり、教師ありファインチューニング・報酬モデルの構築・強化学習による最適化の順に進みます。強化学習の段階では、KLペナルティによって元のモデルから離れすぎないように調整します。
一方で、フィードバックの質・評価者の偏り・コスト・報酬ハッキングといった課題もあります。現在は、DPO・RLAIF・RLVRなどの手法と組み合わせ、目的に応じて使い分けられています。
アイスマイリーでは、生成AIのサービス比較と企業一覧を無料配布しています。課題や目的に応じたサービスを比較検討できますので、ぜひこの機会にお問い合わせください。
業務の課題解決に繋がる最新DX・情報をお届けいたします。
メールマガジンの配信をご希望の方は、下記フォームよりご登録ください。登録無料です。


FOLLOW US
SNSをフォローして、最新情報をチェックできます!


AI製品・ソリューションの掲載を
希望される企業様はこちら