


生成AI
最終更新日:2026/10/22
「Muse Voice Transcribe」は、Meta Superintelligence Labsが2026年9月1日に発表した音声認識AIです。Metaにとって初のリアルタイム音声認識モデルとなります。話しているそばから文字起こしが進み、誰が話したかまで自動で見分けてくれる点が特徴です。
「結局何ができるのか」「料金はいくらか」「自社の会議やコールセンターで今すぐ使えるのか」と気になっている方も多いのではないでしょうか。
本記事ではMuse Voice Transcribeの機能・仕組み・料金を整理します。あわせて、Gemini 3.5 Transcribeなど競合モデルとの違いや、企業が導入を検討する際のポイントも解説します。
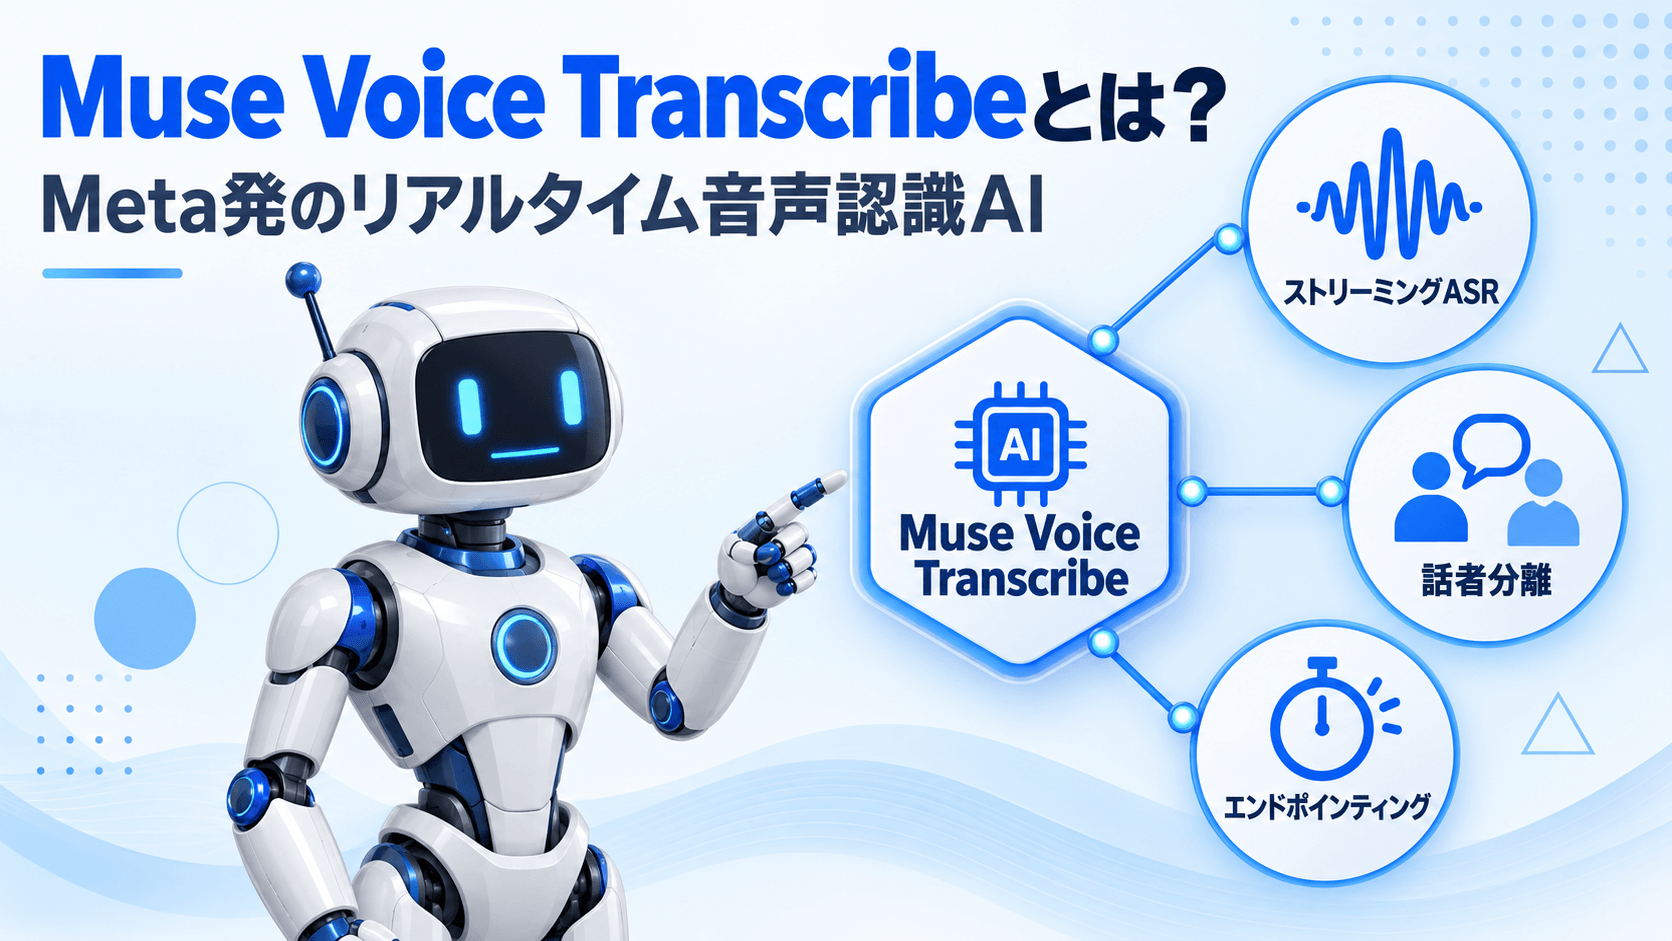
Muse Voice Transcribeとは、Meta Superintelligence Labsが開発した「リアルタイム音声知覚モデル」です。話し終わるのを待ってからまとめて処理する従来型の文字起こしとは違い、音声が流れてくる最中にテキストへと変換していきます。
最大の特徴は、3つの処理を1つのモデルだけで同時にこなせる点です。逐次的に音声を認識する「ストリーミングASR」、話者ごとに発言を振り分ける「話者分離」、発話の始まりと終わりを検出する「エンドポインティング」の3つです。
従来はこれらを別々のモデルで段階的に処理する必要があり、受け渡しのたびに遅延や誤りが積み重なるという課題がありました。Muse Voice Transcribeはこの構成を1本化し、リアルタイム性と精度の両立を狙っています。
開発元のMeta Superintelligence Labsは、Metaの研究部門です。
マルチモーダル推論モデル「Muse Spark」ファミリーを展開しており、Muse Voice Transcribeもこのファミリーに属する自己回帰型のモデルにあたります。
出典:Introducing Muse Voice Transcribe|Meta AI Research
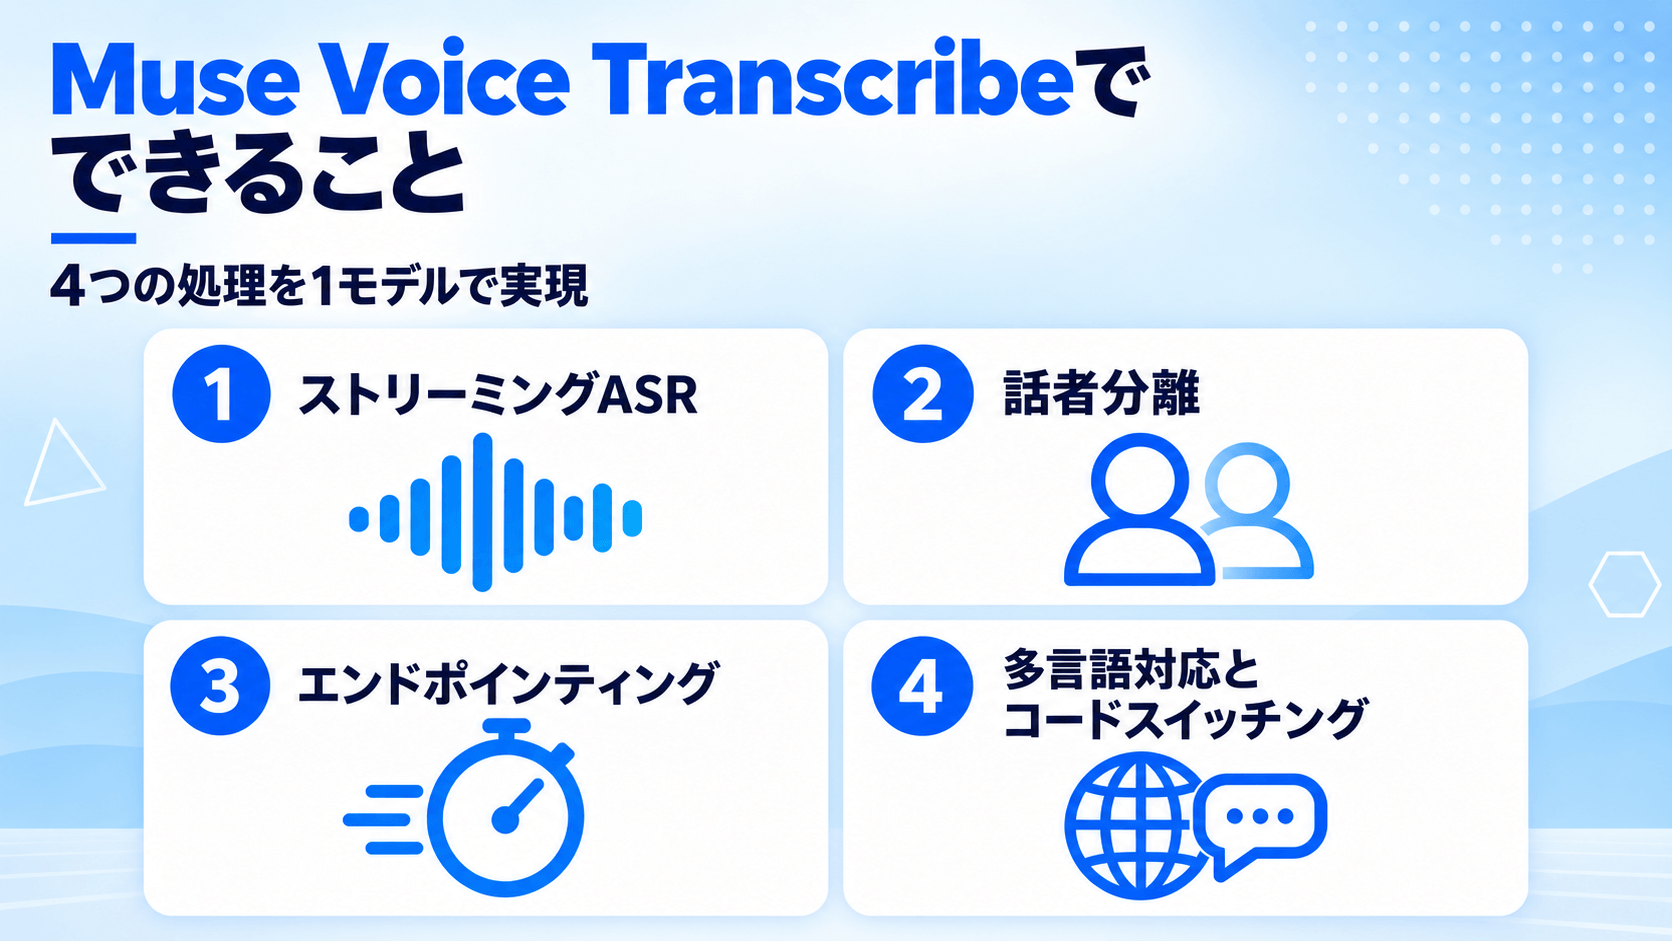
Muse Voice Transcribeが対応する処理は、大きく次の4点に整理できます。
これらの処理はすべて後処理なしで実行できる点も特徴です。1時間を超える長時間の音声や20人を超える多人数の会話であっても、録音後に話者ラベルを付け直す必要はありません。区切りを手作業で調整する手間もかかりません。
Muse Voice Transcribeは70以上の言語で学習されています。そのうち日本語を含む25言語が重点的に検証済みです。
バイリンガルの話者が会話の中で複数の言語を切り替える「コードスイッチング」にもネイティブで対応しています。文単位はもちろん、一文の中での言語の切り替えも自然に処理できるとされています。
出典:Introducing Muse Voice Transcribe|Meta AI Research
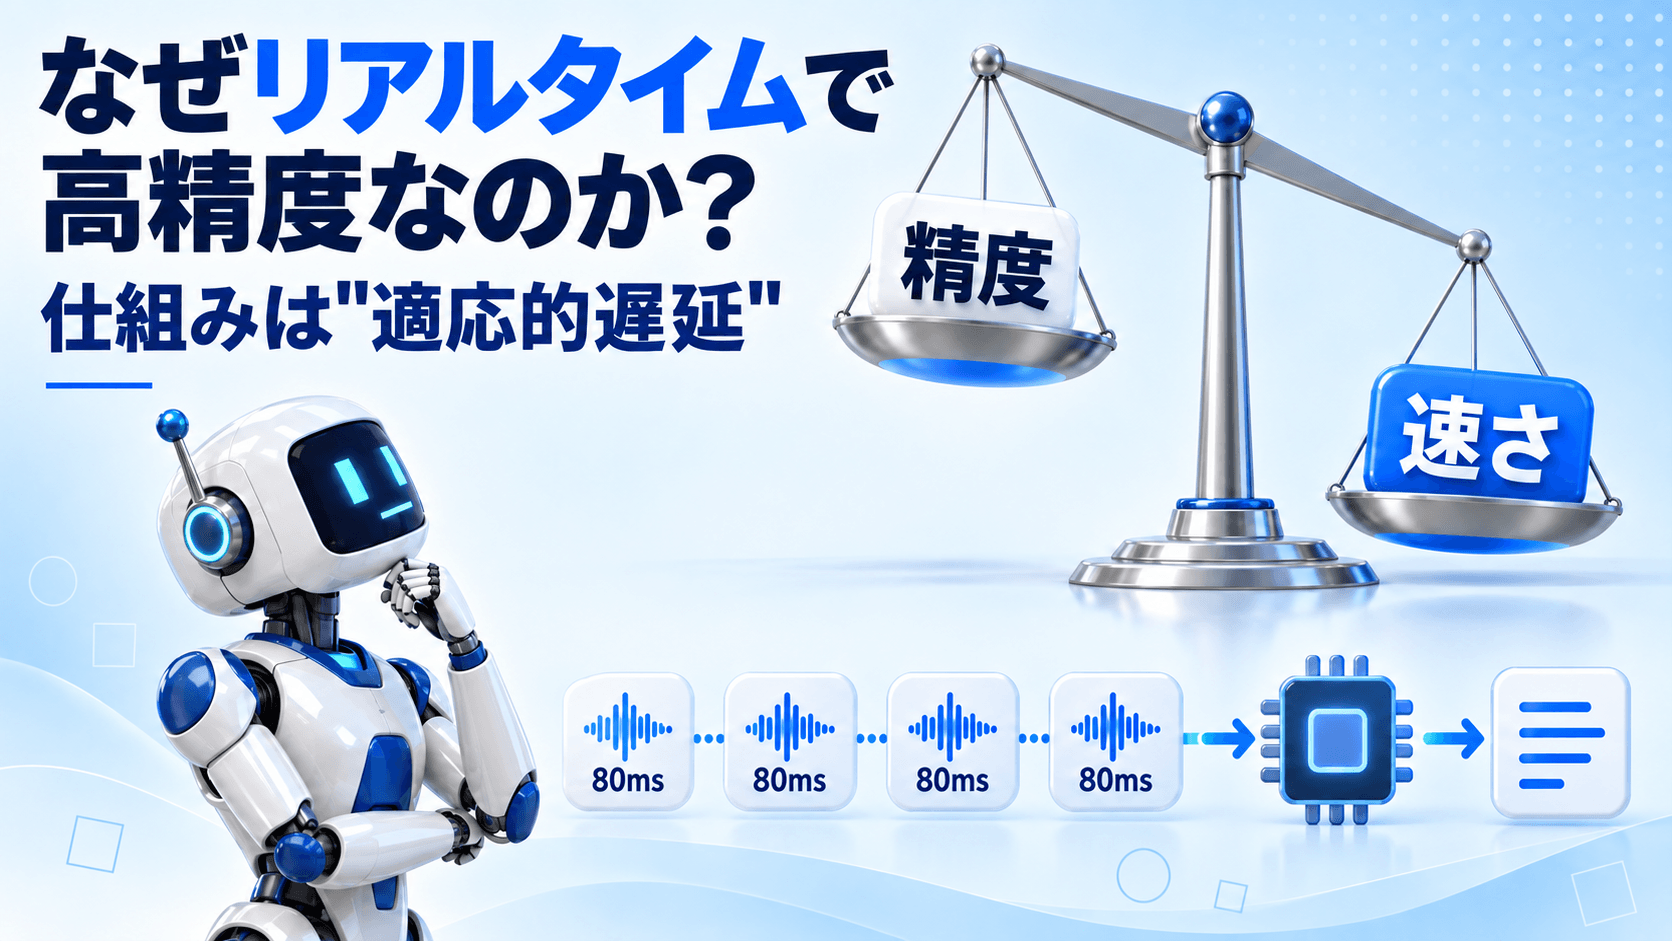
Muse Voice Transcribeは、音声を80ミリ秒という細かい単位で受け取りながら、その都度「もう少し聞いてから判断するか」「ここでテキストとして書き出すか」をモデル自身が判断する仕組みで動いています。
文字起こしの精度と応答の速さは、本来トレードオフの関係にあります。長く聞いてから判断すれば精度は上がりますが、その分応答が遅くなります。逆に早く書き出せば応答は速くなりますが、誤りが増えやすくなります。
Muse Voice Transcribeは、単語ごとの認識の難しさに応じてこの「聞く時間」を動的に変える「適応的遅延」という仕組みを備えており、単語誤り率への報酬と遅延への報酬を組み合わせた強化学習によって、この判断能力を獲得したとされています。
話者分離や発話終了検出についても、同じ音声処理の流れの中に専用の目印となるトークンを組み込むことで実現しており、後から別モデルを継ぎ足す構成にはなっていません。
出典:Introducing Muse Voice Transcribe|Meta AI Research
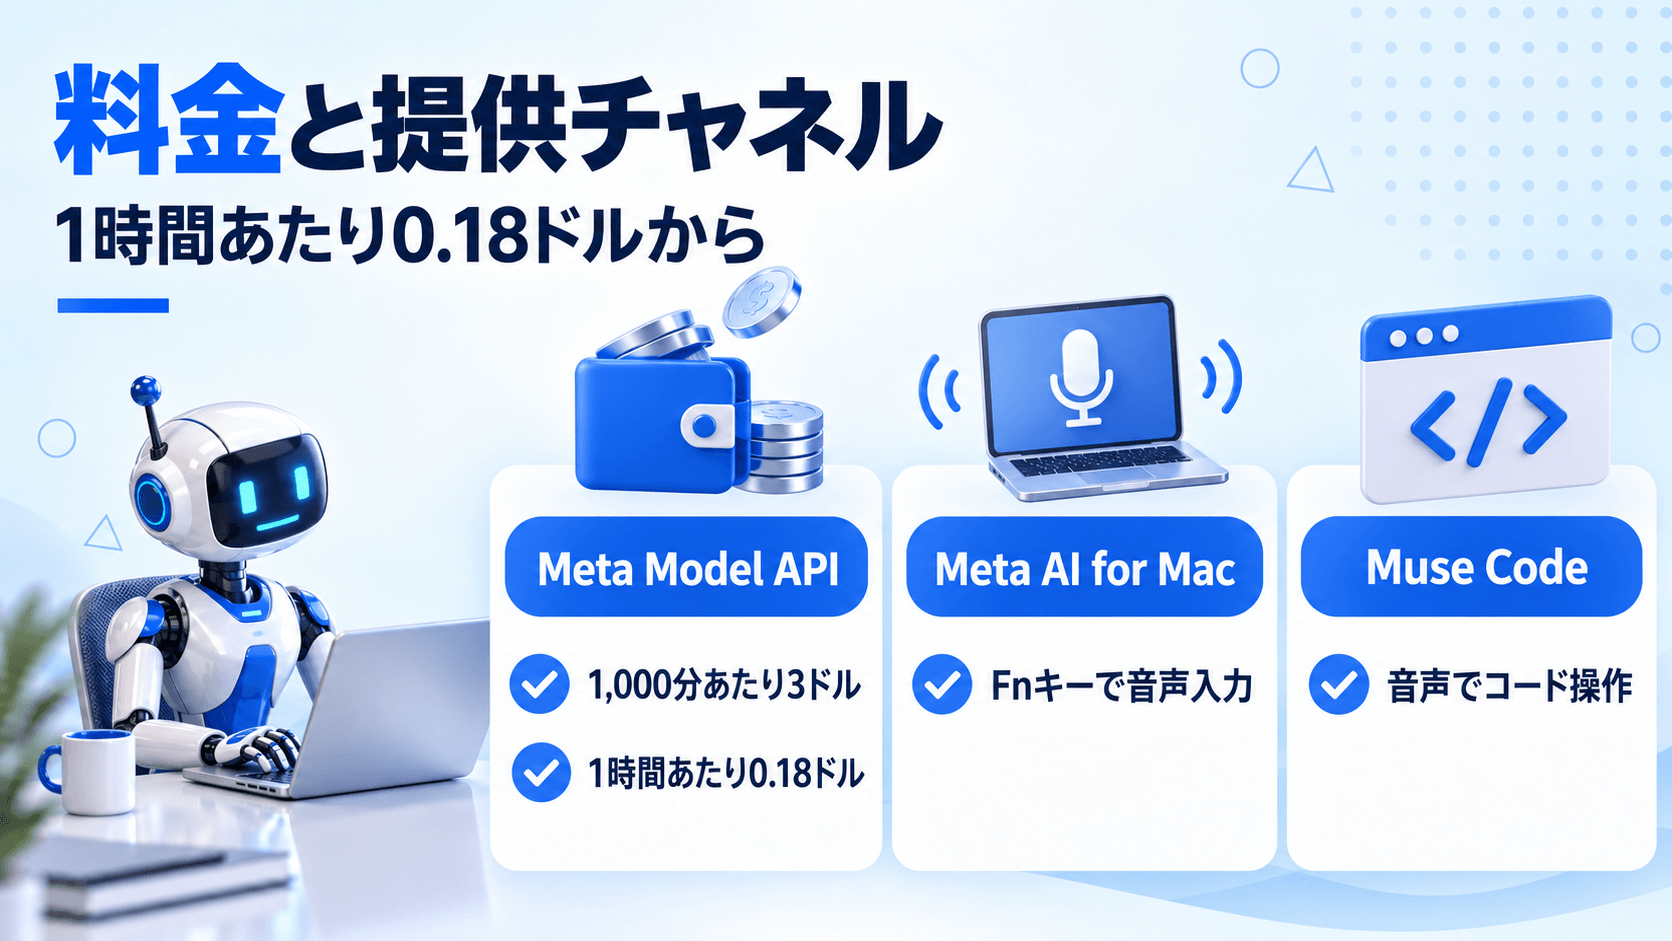
Muse Voice Transcribeは、開発者向けの「Meta Model API」を通じて、1,000音声分あたり3ドル、1時間あたりに換算すると0.18ドルで提供されています(変更の可能性があるため、最新の料金は公式サイトをご確認ください)。
提供チャネルは現時点で3つに分かれています。
| チャネル | 想定される使い方 |
| Meta Model API | 開発者が自社のアプリやサービスに音声認識機能を組み込む用途 |
| Meta AI for Mac | Mac版アプリで[Fn]キーを押している間、任意のアプリ上で音声入力ができる |
| Muse Code | Metaのコーディング支援ツールで、音声による操作に利用される |
Mac版のMeta AIとMuse Codeでは、既存の音声入力機能がすでにMuse Voice Transcribeへ切り替わっており、追加設定なしで利用できます。
一方、開発者向けのAPIとして組み込む場合は、Meta Model APIのアカウントとドキュメントの確認が必要です。
出典:Muse Voice Transcribe|Meta/Build with Muse Voice Transcribe on Meta Model API
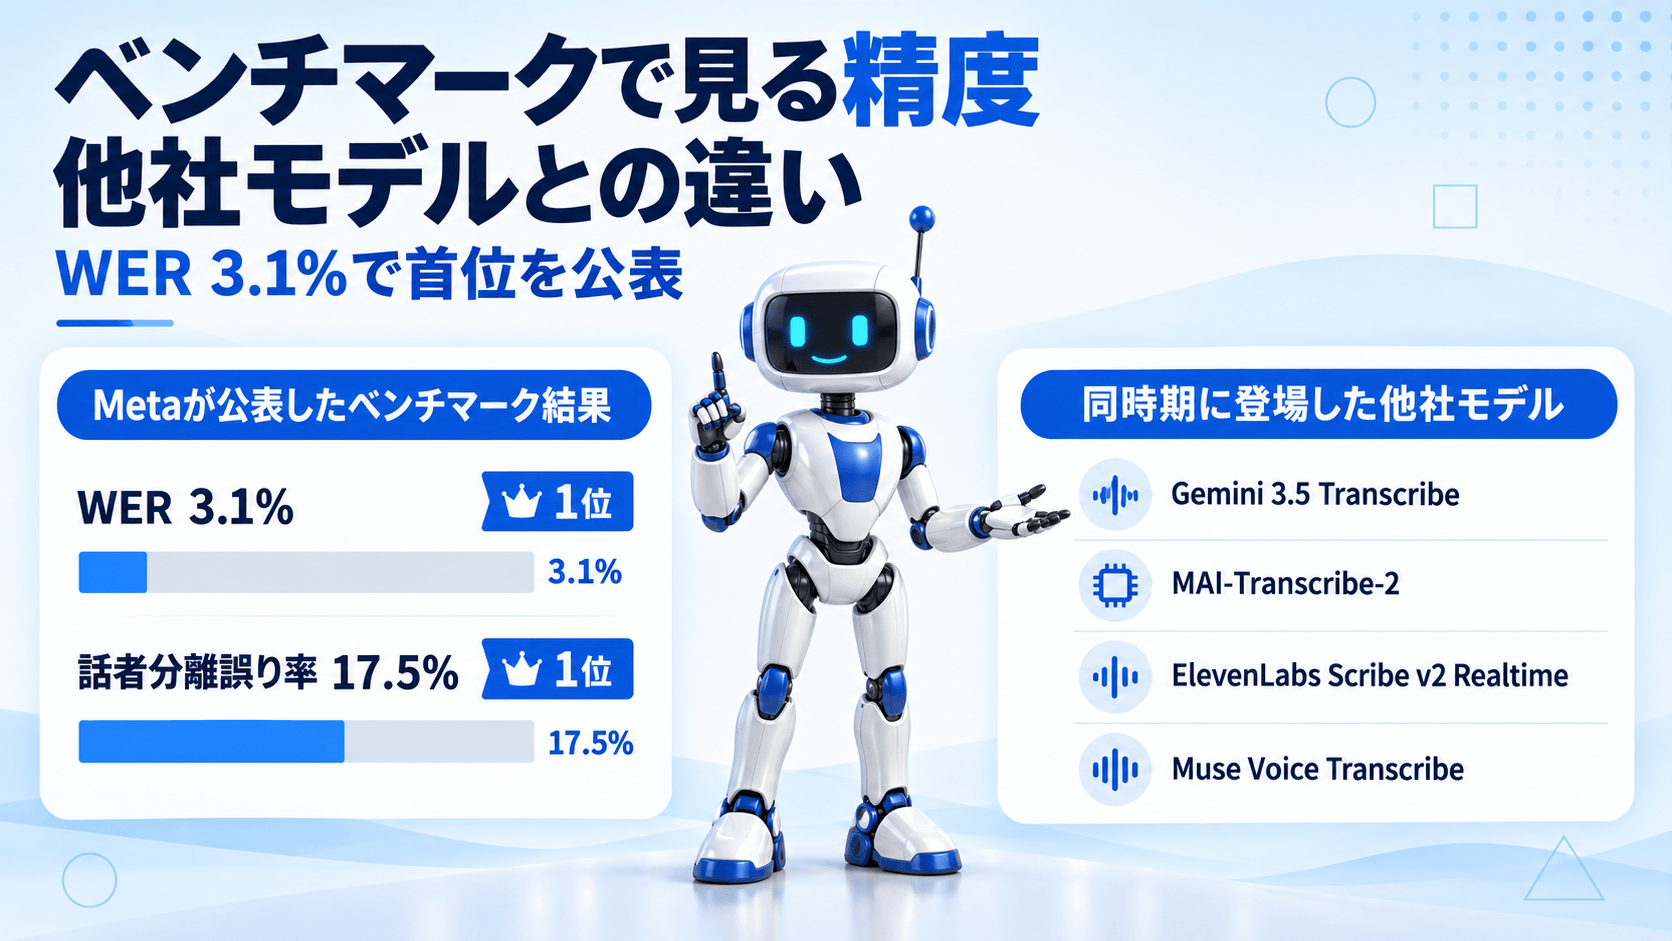
Metaによると、Muse Voice Transcribeは音声AIの評価プラットフォーム「Artificial Analysis」のストリーミング音声認識ベンチマークで、単語誤り率(WER。数値が低いほど誤りが少なく高精度)3.1%を記録し、比較対象となった他モデル(3.4〜4.0%)を上回って首位となりました。
話者分離の精度を示す指標でも、平均誤り率17.5%と、比較対象の他モデル(21.1〜28.6%)より低い数値を記録しています。
Muse Voice Transcribeが発表された前後の時期には、主要各社からも音声認識・文字起こし系のモデルが相次いで登場しています。それぞれの特徴を簡単に整理すると、次のようになります。
| モデル | 提供元 | 主な特徴 |
| Muse Voice Transcribe | Meta | ストリーミングASR・話者分離・発話終了検出を1モデルで一体処理。WER 3.1%で首位を公表 |
| Gemini 3.5 Transcribe | 「あー」「えー」等のフィラーを自動削除しながらリアルタイム文字起こしする機能が報じられています | |
| MAI-Transcribe-2 | Microsoft | Gemini 3.5 Transcribeの5倍、GPT-Transcribeの10倍の速度をうたうと報じられています |
| ElevenLabs Scribe v2 Realtime | ElevenLabs | WER 3.6%・応答遅延0.14秒という数値が報じられています |
※Muse Voice Transcribe以外の数値は各社・各メディアの発表内容に基づくものであり、測定条件が異なる可能性があるため、単純な優劣の比較ではなく「同時期に競合が相次いでいる」参考情報としてご覧ください。
出典:Introducing Muse Voice Transcribe|Meta AI Research/Meta Superintelligence Labs Releases Muse Voice Transcribe|MarkTechPost
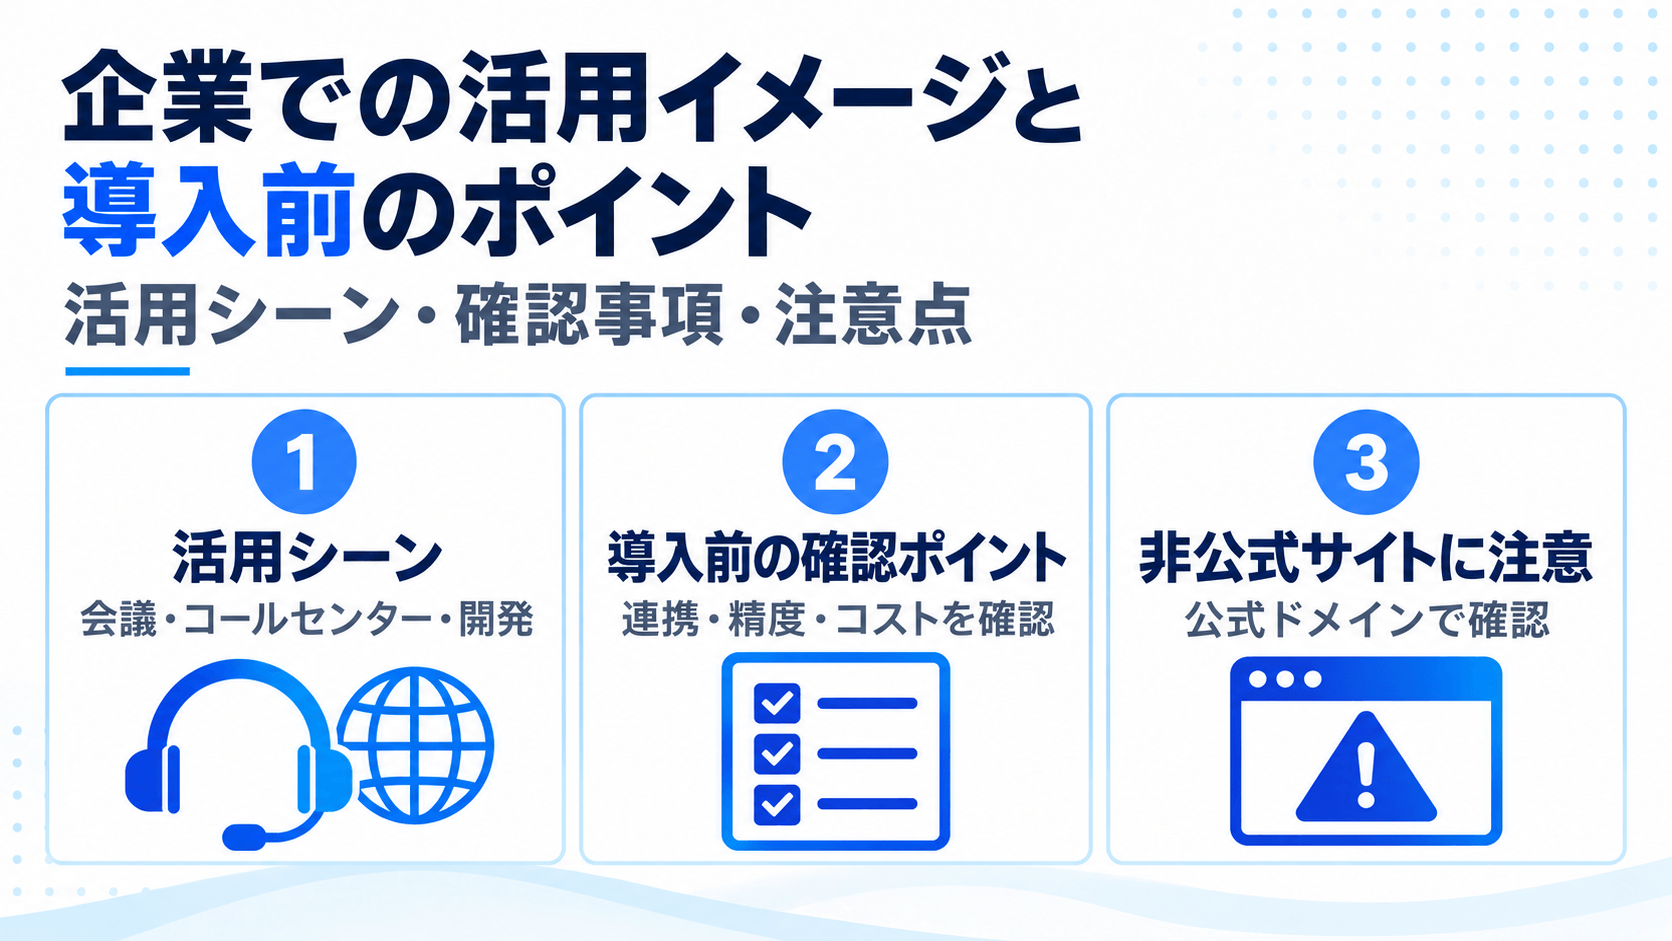
Muse Voice Transcribeは、現時点では「開発者向けのAPI」「Mac版Meta AIの音声入力」「Muse Code」を通じて提供されているモデルであり、日本語に対応した議事録作成サービスや単体のWebアプリとして一般公開されているわけではありません。
「Muse Voice Transcribeというサービスに登録すればすぐ使える」というものではない点は、導入を検討するうえでまず押さえておきたいポイントです。
想定される企業での活用シーンとしては、以下のようなものが考えられます。
自社での導入を検討する場合は、次の観点を確認しておくとスムーズです。
「Muse Voice Transcribe」の名称で検索すると、Meta公式ではない第三者が運営する文字起こしツールのサイトも検索結果に表示されることがあります。こうしたサイトの中には、Muse Voice Transcribeという名称を掲げつつ、実際には独自の文字起こしサービスを提供しているケースも見られます。
モデルの仕様や料金など正確な情報を確認する際は、Meta公式のresearch.meta.aiやdeveloper.meta.com上の情報を確認することをおすすめします。
出典:Introducing Muse Voice Transcribe|Meta AI Research
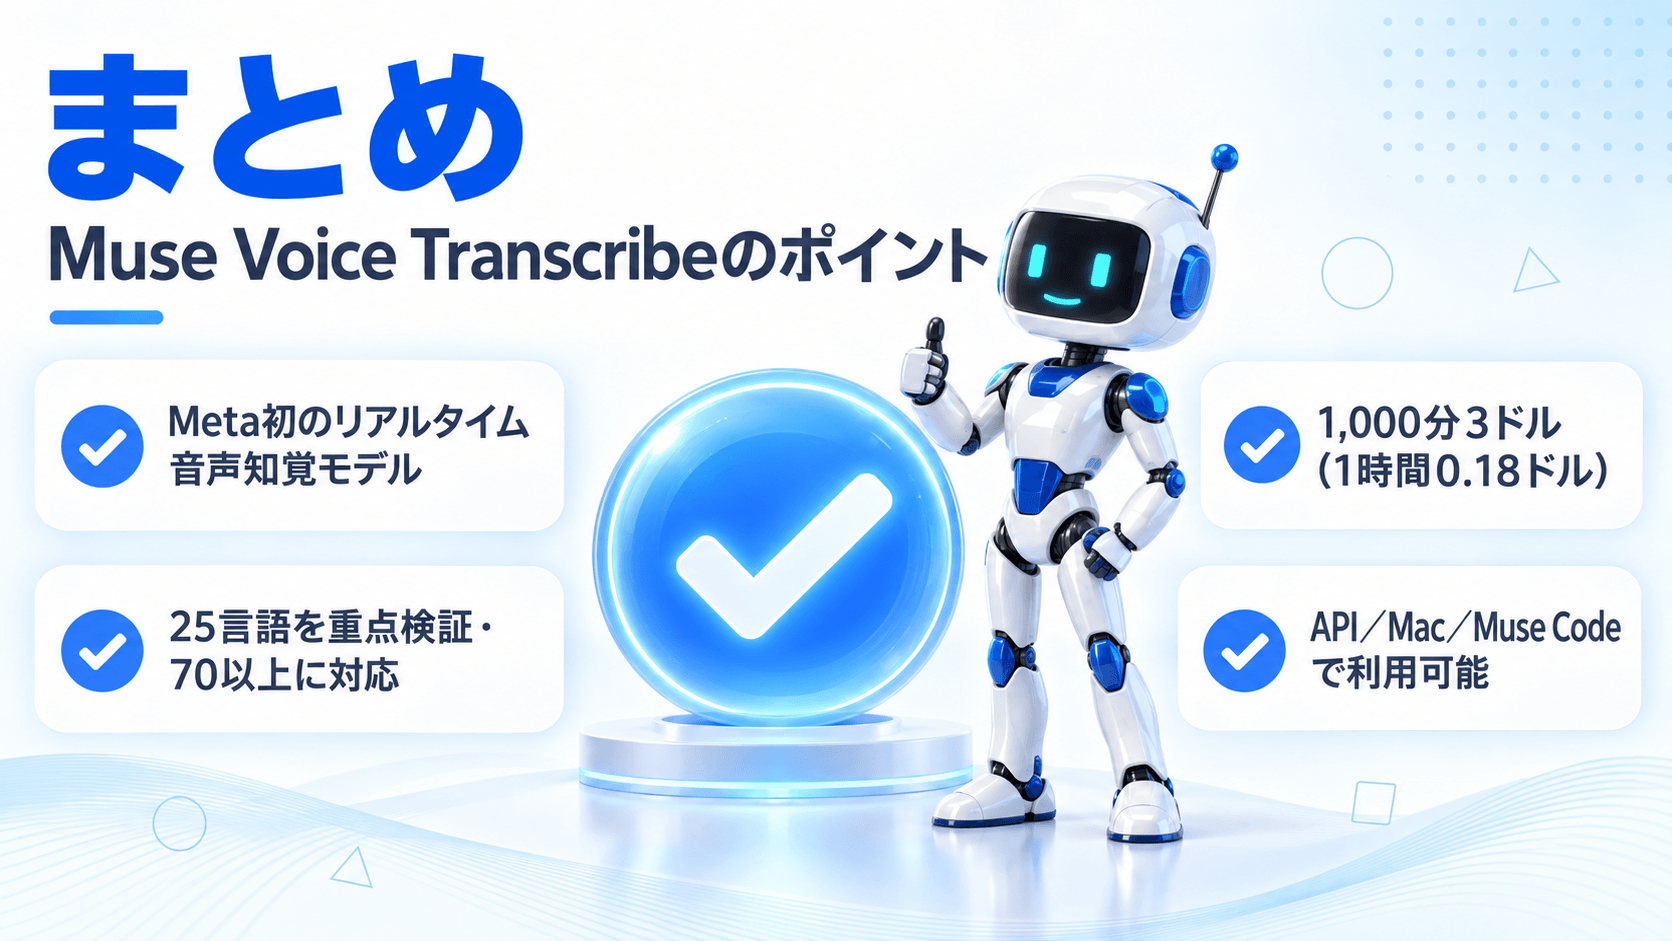
Muse Voice Transcribeは、Meta Superintelligence Labsが発表した初のリアルタイム音声知覚モデルであり、ストリーミングASR・話者分離・発話終了検出を1つのモデルで一体的に処理できる点が最大の特徴です。
料金はMeta Model API経由で1時間あたり0.18ドルからで、現時点ではAPIのほかMac版Meta AIやMuse Codeを通じて利用できます。
まずは自社の会議やコールセンター業務で音声認識AIをどう活用できそうか、具体的な業務シーンを洗い出してみることをおすすめします。あわせて、他の音声認識AI・議事録作成AIサービスとの比較も検討したい方は、以下の関連記事もご覧ください。
アイスマイリーでは、生成AI のサービス比較と企業一覧を無料配布しています。課題や目的に応じたサービスを比較検討できますので、ぜひこの機会にお問い合わせください。
業務の課題解決に繋がる最新DX・情報をお届けいたします。
メールマガジンの配信をご希望の方は、下記フォームよりご登録ください。登録無料です。


FOLLOW US
SNSをフォローして、最新情報をチェックできます!


AI製品・ソリューションの掲載を
希望される企業様はこちら