


生成AI
最終更新日:2026/10/08
企業での生成AI活用が進むにつれ、もっともらしい嘘(ハルシネーション)を防ぐ手法として「グラウンディング(Grounding)」が注目を集めています。
しかし、技術文書を読んでも説明が難解で、「RAG(検索拡張生成)とは何が違うのか?」「ファインチューニングとどちらを自社に導入すべきか?」と、境界線が曖昧なまま悩んでいるAI導入担当者の方も多いのではないでしょうか。
本記事では、グラウンディングの本質的な意味から、RAGとの決定的な違い、実務導入時に陥りやすい注意点までを分かりやすく解説します。この記事を読めば、社内で「グラウンディングとは何か?」を自信を持って説明できるようになり、自社の課題に最適な生成AIシステムの構築方針が明確になります。
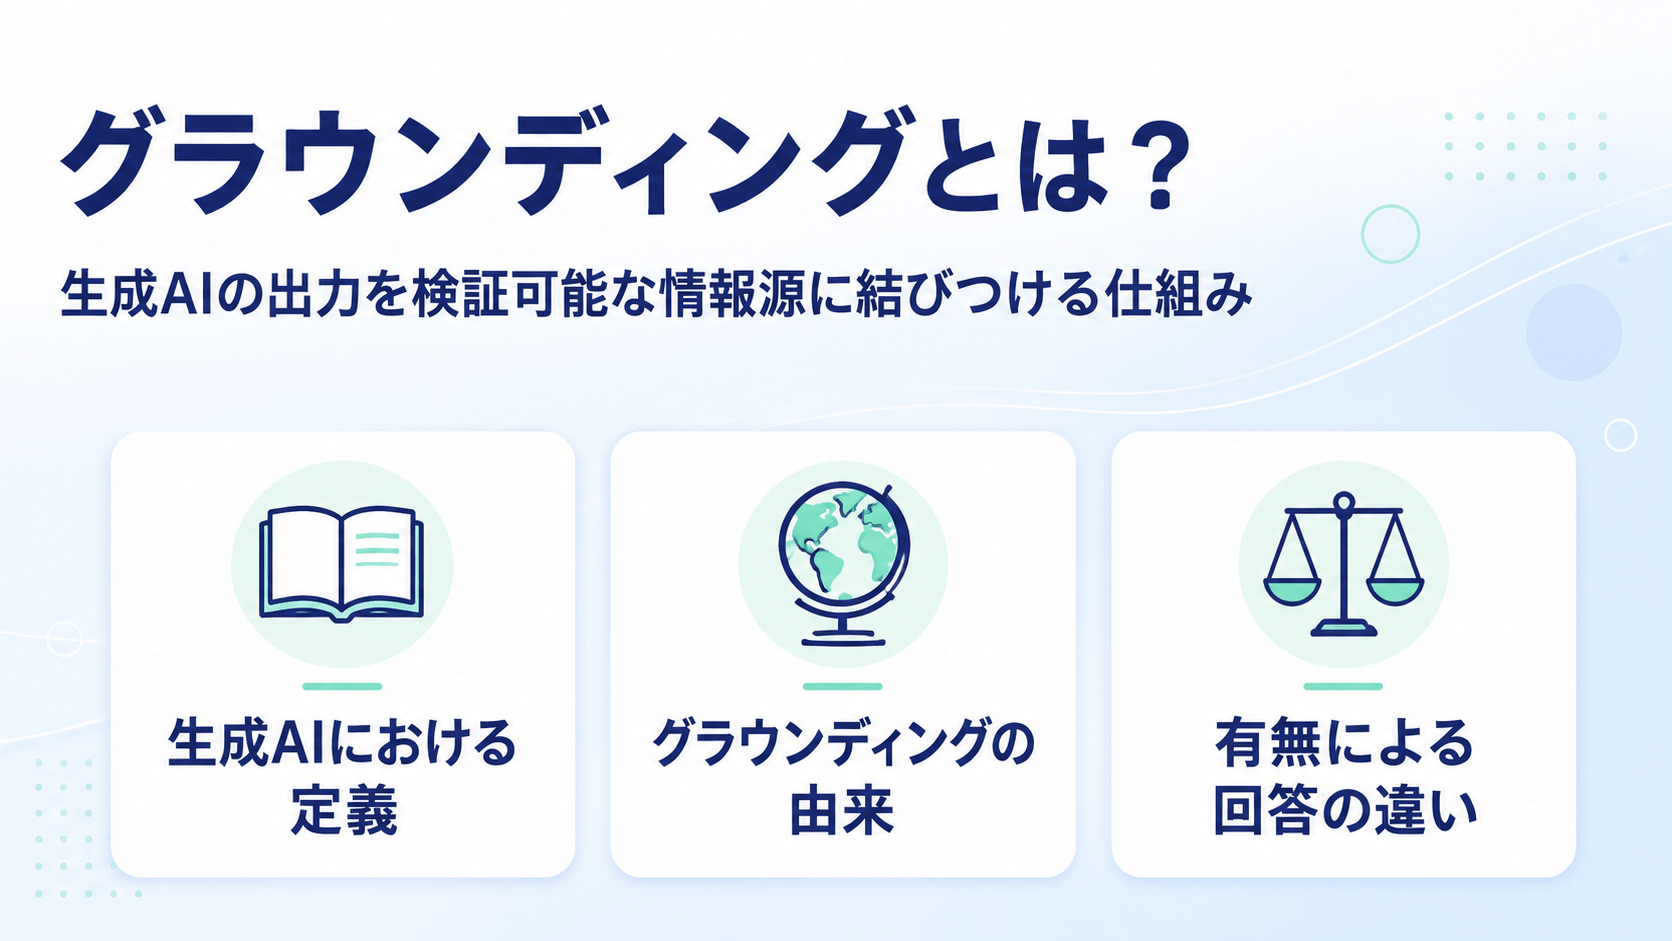
グラウンディングとは、生成AIの出力を検証可能な情報源に結びつけ、その情報を根拠として回答させる仕組みを指します。
Google Cloudは、グラウンディングを「モデルの出力を検証可能なデータソースに接続する」と説明しています。
AIが正しそうな回答を返すだけでは、その内容が正しいかどうかを利用者は確かめられません。回答の元になった文書やWebページが特定できて初めて原文と突き合わせられます。
「グラウンディング(Grounding)」は地面や基盤を意味する「ground」を語源とし、日本語では「接地」と訳されます。AIの分野では以前から、言葉や記号を現実の対象や意味に結びつけるという文脈でこの言葉が使われてきました。
社内の担当者が「今期の主力製品の販売実績を教えてほしい」と尋ねた場面で考えてみましょう。
グラウンディングがない状態では社内の非公開データが学習に含まれていないため、AIはそれらしいパターンから数値を作り出してしまう可能性があります。販売管理データや決算資料を参照できる状態にしておけば、AIはその資料を根拠として回答できます。
出典表示にも対応した構成であれば、参照元のファイル名や該当箇所を確認できます。
| グラウンディングなし | グラウンディングあり | |
|---|---|---|
| 回答の根拠 | 学習済みの知識のみ | 指定した文書・データ・Web情報 |
| 社内固有の情報 | 答えられない、または推測になる | 参照範囲にあれば答えられる |
| 確認のしやすさ | 利用者が一から調べ直す必要がある | 出典表示を組み合わせれば参照元をたどって照合できる |
| 情報の新しさ | 学習時点で止まる | 参照先や検索インデックスの更新を反映できる |
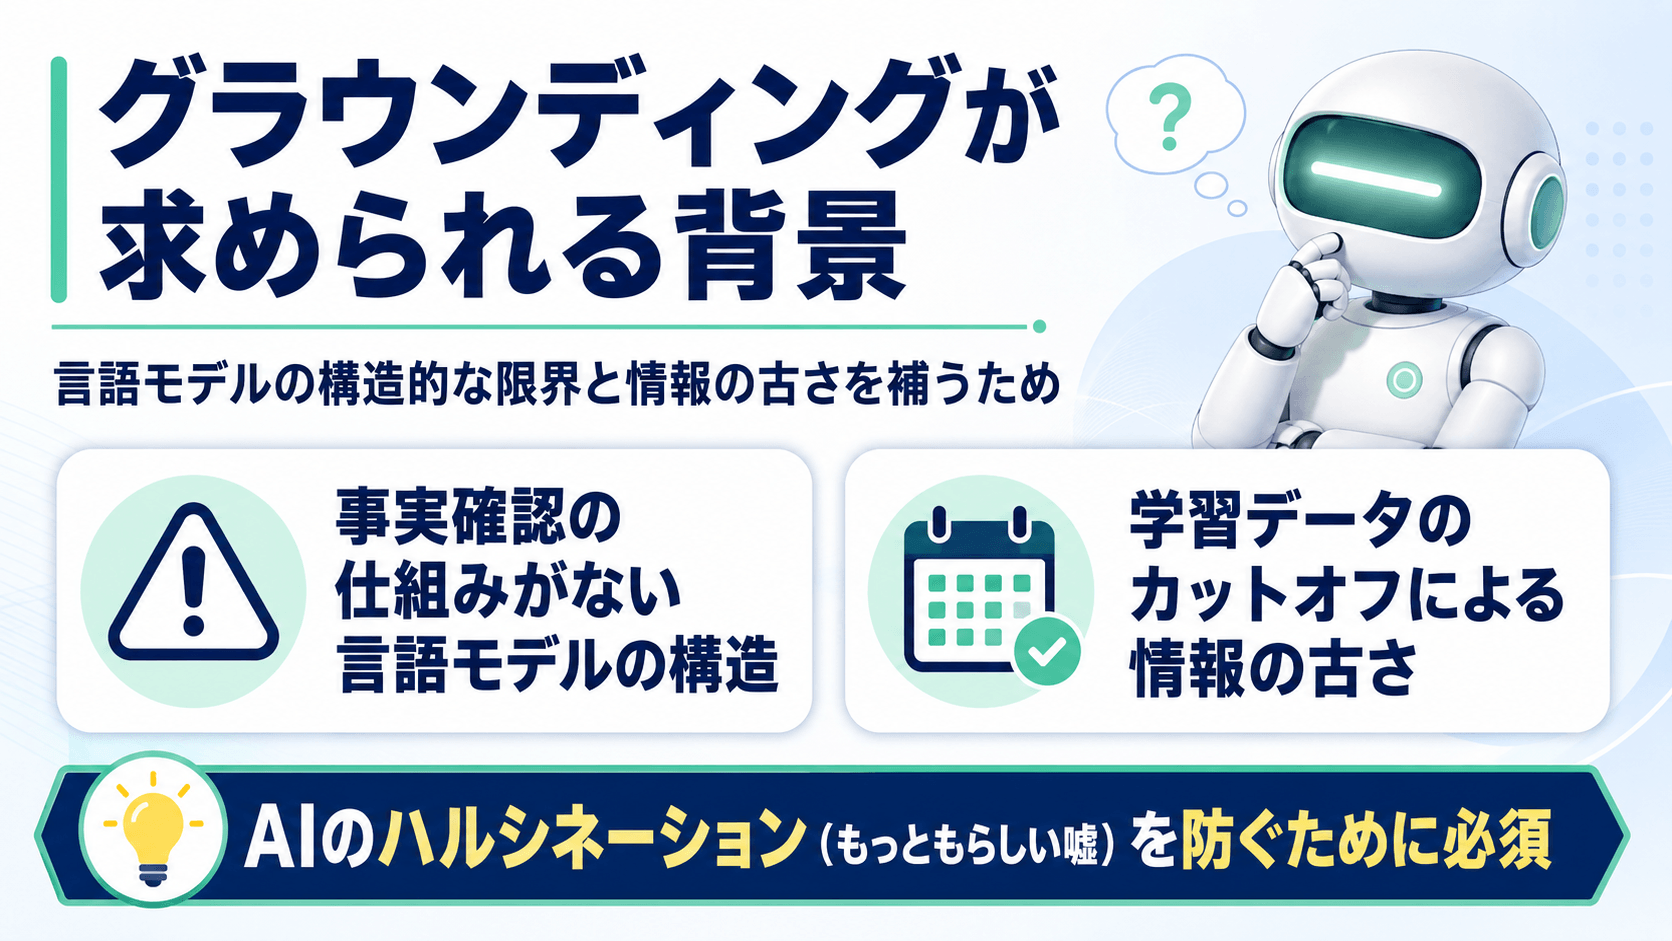
グラウンディングが必要になるのは、言語モデルの作り方そのものに限界があるためです。文章を生成する仕組みには、内容が事実かどうかを判定する工程が入っていません。
LLM(大規模言語モデル)は、大量のテキストから「次に来る可能性が高い単語」を予測する形で文章を作っています。この方式は流暢な文章を生み出す一方、出力内容の真偽を判定する機能を含みません。
学習データに十分な記述がない事柄について尋ねられると、モデルはパターンから推測した内容を、正しい回答と同じように出力します。これがハルシネーションと呼ばれる現象です。
OpenAIは2025年9月に公開した調査で、ハルシネーションが残り続ける理由の一つとしてモデルの評価方法を挙げました。
正答率だけで採点すると、「わかりません」と答えるより当てずっぽうで答えたほうがスコア上は有利になるため、モデルは推測する方向に学習してしまうという指摘です。
LLMの知識は、学習に使ったデータの収集時点で止まります。
この区切りを「カットオフ」と呼び、以降に起きた出来事や更新された情報は反映されません。
法改正・制度変更・料金改定といった業務でよく参照される情報ほど更新の頻度が高く、カットオフの影響を受けます。さらに、社内文書やクローズドなデータベースの内容は、通常、汎用モデルの学習データには含まれていません。
自社の最新固有情報にもとづいた回答をさせたい場合は、回答時に社内データを参照させる方法が適しています。
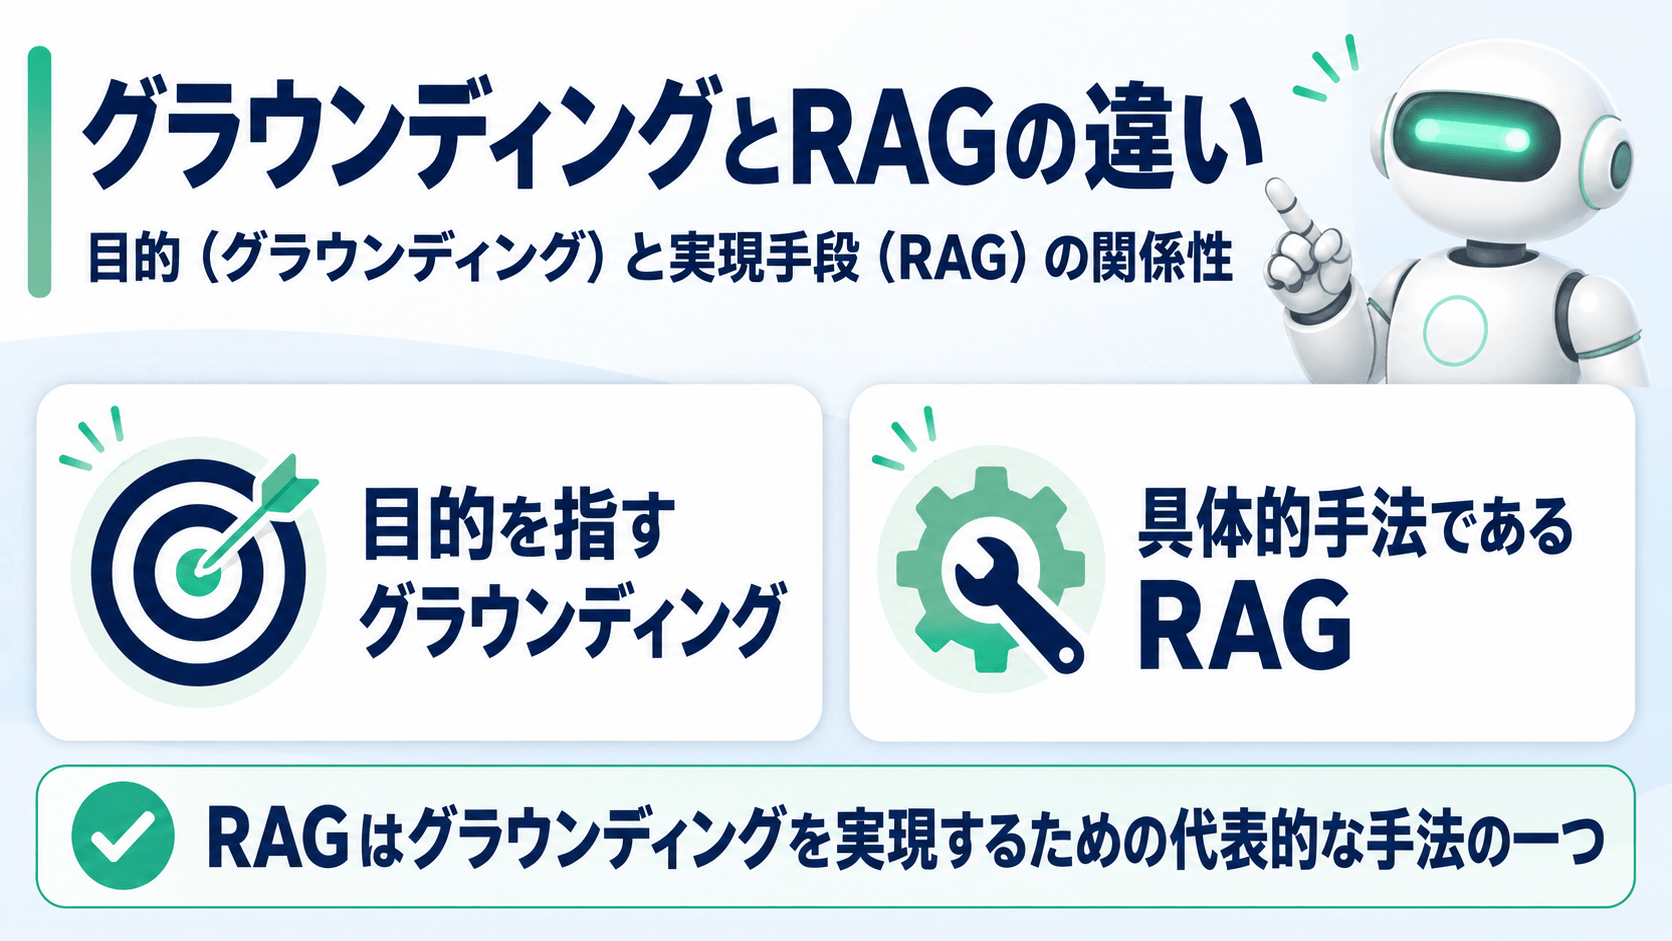 グラウンディングとRAG(検索拡張生成)は、並列で比較するものではありません。
グラウンディングというゴールを実現する1つの手法としてRAGが含まれる関係にあります。
RAGは、2020年にPatrick Lewisらが発表した論文で提唱された手法です(arXiv)。
外部の文書集合から質問に関連する情報を検索し、その結果をプロンプトに加えたうえで回答を生成する、という3段階の処理で構成されます。
この処理は「出力を検証可能な情報源に結びつける」ものであり、グラウンディングの実現手段の一つです。
実際にGoogle Cloudのドキュメントでも、グラウンディングの方式の1つとしてRAGが挙げられています。
| 項目 | グラウンディング | RAG |
|---|---|---|
| 性質 | 目的・考え方 | 具体的な手法 |
| 指す範囲 | 検索連携・Web連携・出典明示などを含む | 検索して生成する処理の組み合わせ |
| 実装 | 単体では実装できない | 検索基盤と生成の連携として実装する |
自社の要件を検討するときは、まずグラウンディングをどのように実現するかを検討し、その上でRAGを選ぶかどうかを考えます。
自社の就業規則をそのままプロンプトに貼り付けて「この規則にもとづいて、有給休暇の申請期限を答えてください」と指示したとします。
AIは貼り付けられた文面を根拠に回答するため、これもグラウンディングが成立している状態です。ただし検索処理は一切行われていないため、RAGではありません。
RAGが有力な選択肢になるのは、参照させたい文書が多く、質問に応じた必要な情報を選び出す必要があるケースです。共有フォルダ内に保存されている数百・数千件の社内文書から質問に関係する情報だけを取り出す工程を経るため、そこに検索が入ります。
RAGは、外部情報を検索して回答生成に利用する、代表的なグラウンディング手法です。
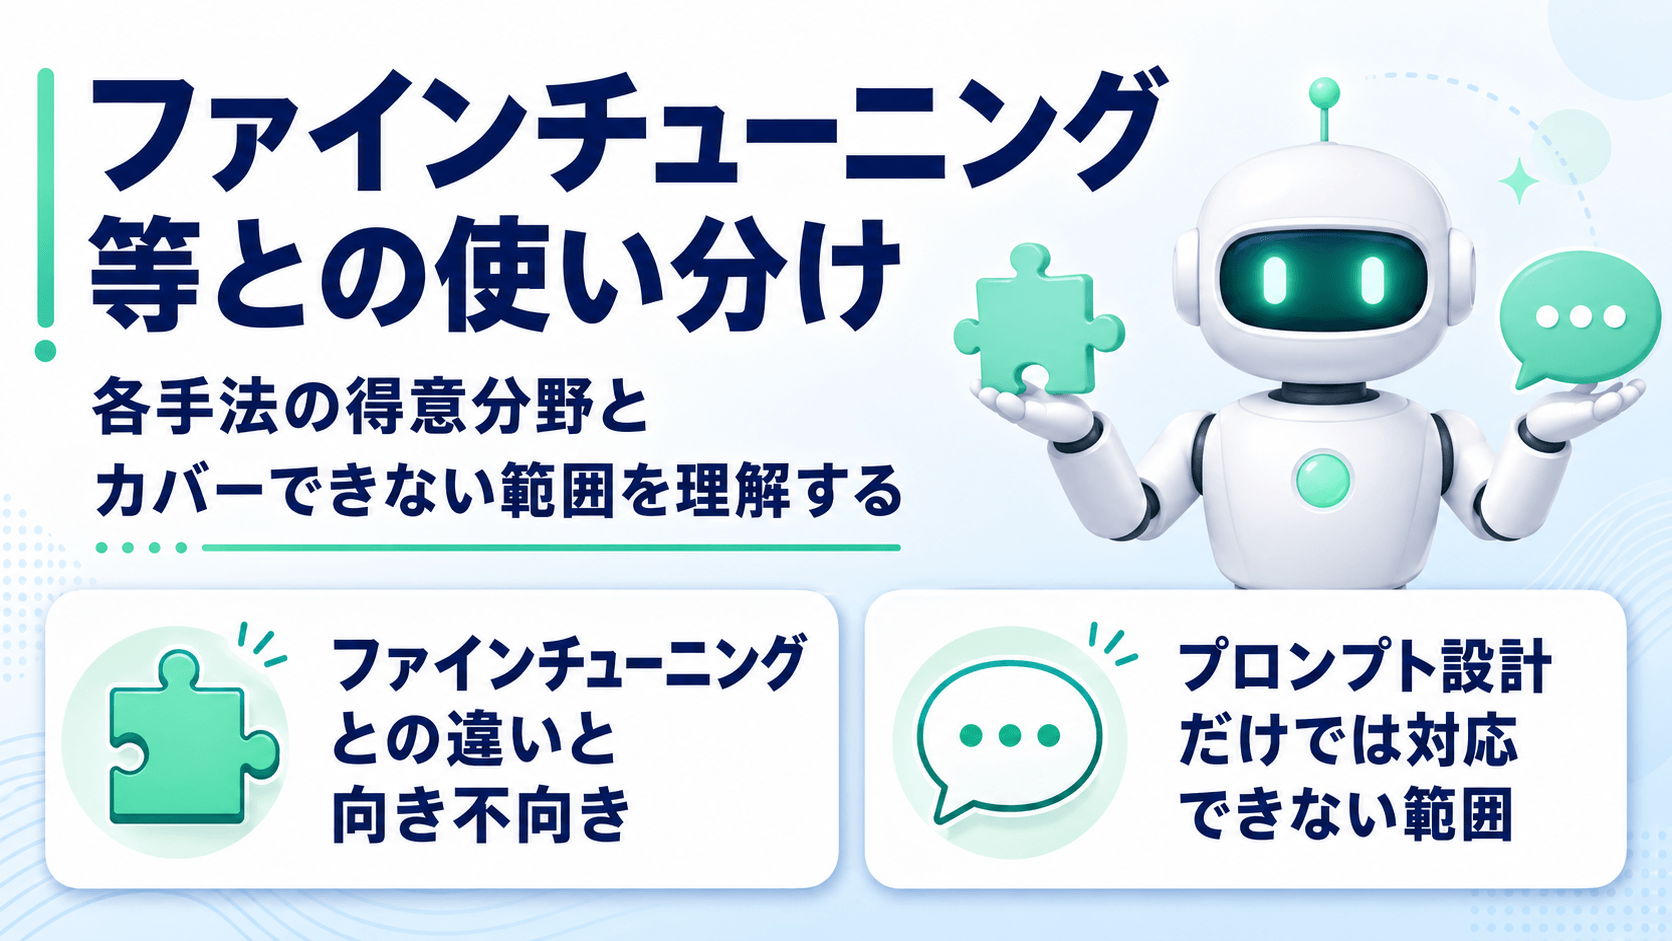 AIの回答精度を高める手段はグラウンディングだけではありません。ファインチューニングやプロンプト設計も同じ目的で語られますが、対処できる範囲がそれぞれ違います。
ファインチューニングは、追加のデータを学習させ、モデル自体の振る舞いを変える手法です。特定の業界の言い回しに合わせる、決まった出力形式を守らせる、といった用途で効果を発揮します。
一方、知識を最新に保つ用途には向きません。情報が更新されるたびに再学習が必要になり、コストと時間がかかるためです。
また、ファインチューニング単体では、回答が学習データのどこに由来するかを追跡して根拠として示す仕組みがありません。
| 観点 | グラウンディング | ファインチューニング |
|---|---|---|
| 変えるもの | 参照する情報 | モデルの振る舞い |
| 情報の更新 | 参照先を差し替えれば反映 | 再学習が必要 |
| 根拠の提示 | 参照元を示せる | 示せない |
| 向いている用途 | 事実にもとづく回答 | 文体・形式・専門的な言い回し |
プロンプトの工夫でも、ハルシネーションをある程度抑えられます。
「わからない場合はわからないと答えてください」といった指示は、実際に出力の傾向を変えます。ただし、これはモデルが持っている知識の範囲内での話です。
社内文書の内容も、カットオフ以降の出来事も、プロンプトの書き方では埋まりません。
プロンプト設計は、グラウンディングと組み合わせたときに効果が出ます。参照させた資料に書かれていないことは答えないよう明示しておくと、資料の外側に踏み出した回答を減らせます。
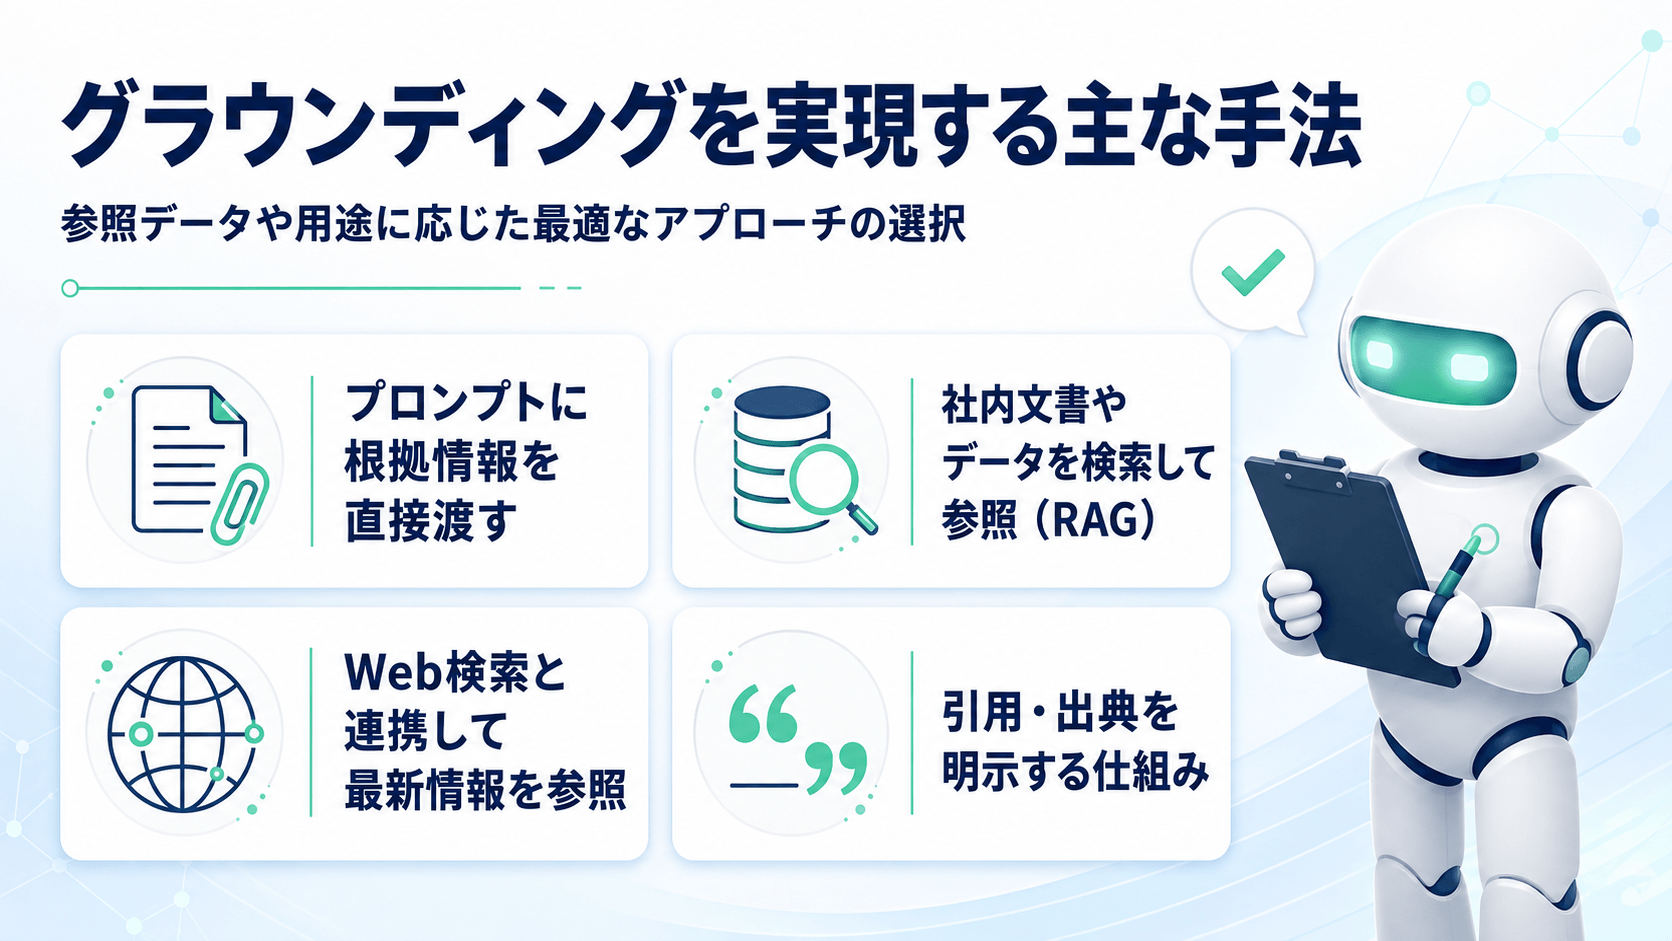
グラウンディングを実現する手法は複数あり、参照させたいデータの種類と求める情報の新しさによって選びます。
最も単純な方法は、参照させたい情報をプロンプトに直接含めることです。
例えば、契約書の条文・議事録・仕様書などを添付し、その内容にもとづいた回答を求める手法です。専用のシステムがなくても試せます。
ただし、モデルが一度に扱えるテキスト量には上限があり、大量の文書を毎回貼り付ける運用は現実的ではありません。質問に応じて参照先が変わる場合も不向きです。
参照対象が膨大な場合は、質問に関連する文書だけを検索・抽出してプロンプトに組み込むRAG(検索拡張生成)が有効です。
検索方式にはキーワード検索のほか、文脈の近さを判定するベクトル検索や両者を併用するハイブリッド検索があります。この手法は、社内規程や過去の問い合わせ履歴など自社固有の情報を扱うのに適しているものの、事前に文書を検索可能な形(ベクトルデータなど)に変換・保管する準備作業が必要です。
AIの学習データの区切り(カットオフ)以降の最新情報を扱いたい場合は、検索エンジンとの連携が適しています。質問に応じてAIが検索を実行し、その結果をもとに回答するため、ニュースや制度改正といった変化の速い話題に強みを発揮します。
ただし、回答の正確性がWeb上の情報の質に左右されるため、誤情報を拾わないように参照先のドメインを限定するなどの工夫が求められます。
回答に根拠となった文書名やURLを添える出典の明示は、ほかの手法と組み合わせて活用されます。該当条文や元データへのリンクがあれば、利用者が原文にすぐアクセスできるためファクトチェックの手間を大幅に削減できます。
一方で、出典の表示自体は誤りを防ぐ機能ではないため、示された出典と回答内容が本当に一致しているかどうかは人が最終確認を行う必要があります。
売上の集計や在庫数の照会など、数値の正確さが厳密に求められる場面では、データベースへの直接照会や計算ツール(API)の呼び出しを組み合わせます。
文章から数値を読み取らせる方式ではAI特有の桁の取り違えや集計ミスが起こるリスクがありますが、システムから値を直接取得する構成にすることで、計算ミスや致命的な誤りを物理的に防げます。
| 手法 | 主なデータ源 | 向いている場面 | 準備の負担 |
|---|---|---|---|
| プロンプトへの埋め込み | 手元の文書 | 特定文書への集中的な質問 | 小 |
| 社内データの検索 | 社内文書・DB | 自社固有の情報への回答 | 大 |
| Web検索連携 | Web上の公開情報 | 最新情報・社外の動向 | 中 |
| 引用・出典の明示 | 参照した文書全般 | 回答の確認作業を減らす | 小 |
| 構造化データ・ツール | DB・API | 数値の正確さが要る場面 | 中 |
 主要なクラウド各社は、グラウンディングを実現するための機能をそれぞれ提供しています。
Google Cloudは、2026年4月にVertex AIの発展形としてGemini Enterprise Agent Platformを発表し、エージェントの構築から運用までを扱う基盤として位置づけています(Google Cloud)。
グラウンディングについては、参照先の種類ごとに複数の方式が用意されています。Google検索・Googleマップ・Agent Search・RAG Engine・外部の検索APIなどを利用できます。
用途に応じて、公開Webや自社データなど参照先を選べる構成です。Google検索を使う方式なら、自社でデータを用意しなくても公開Web上の情報を根拠に回答させられます。
Microsoftは、Azure AI Foundryから名称を変更したMicrosoft Foundryを提供しています。
また、エージェントに組織の情報を提供する仕組みとして、Fabric IQ・Work IQ・Foundry IQの3つのIQワークロードを位置づけています。
このうちFoundry IQは、Azure・SharePoint・OneLakeなどの企業データをナレッジベースとして利用するための仕組みです。
検索時は質問を複数の下位クエリに分解して並列に実行し、意味的な再ランク付けを行ったうえで引用付きの回答を生成します。検索方式はキーワード・ベクトル・ハイブリッドから選べます。
Web上の情報を参照する機能としては、別途Web IQが提供されています。約20年にわたるBingの検索インフラを基盤に、LLMやマルチステップのエージェント向けに再設計されたものと説明されており、2026年8月時点では一部のエンタープライズ顧客への限定提供です(Microsoft)。
AWSでは、Amazon BedrockのKnowledge Basesを使ってRAGを構築できます。
Amazon S3に保存したPDFやWord文書などを取り込み、意味にもとづく検索で関連情報を取り出す構成です。
特徴的なのは、Amazon Bedrock Guardrailsが備えるcontextual grounding checkです。生成された回答について、参照元にもとづいているか(grounding)と、質問に対して的を射ているか(relevance)を別々に採点し、しきい値を下回った回答を遮断します(AWS)。
グラウンディングと回答の関連性をそれぞれ評価し、しきい値にもとづいて回答をフィルタリングできます。
ただし対応する用途は要約・言い換え・質問応答に限られ、会話形式のチャットボットは対象外とされています。
グラウンディングの効果は、回答の正確性が上がることだけにとどまりません。
回答時に参照情報を与えることで、学習済み知識だけに頼る場合よりも、指定した情報にもとづく回答を生成しやすくなります。結果として、参照データと異なる内容が混ざる可能性を抑えられます。
同じ質問を別の担当者が尋ねた場合の回答のばらつきも小さくなります。
参照する資料が共通であれば、回答の内容もそこに収れんするためです。社内で同じ基準の答えを返せる状態は、規程や手続きに関する問い合わせで特に意味を持ちます。
学習データに含まれていない自社の情報を扱えるようになる点は、企業利用で効果が見えやすい部分です。製品仕様・社内規程・過去の商談記録・顧客対応の履歴などは、どれもモデルが元から知り得ない情報です。
これらを参照先として接続すれば、汎用のチャットサービスでは答えられない質問にも対応できます。
社内固有の情報や更新頻度の高い情報を回答時に参照させる用途では、ファインチューニングよりもグラウンディングが適しています。
回答に参照元が添えられると、内容を確認する手順が短くなります。出典がなければ、利用者は回答の正しさを判断するために一から資料を探し直す必要があるためです。
該当箇所へのリンクがあれば、その場で原文を開いて突き合わせられます。AIの回答を人が確認する運用では、この差がそのまま作業時間の差になります。
グラウンディングは、回答の正確さが業務上の要件になっている場面ほど効果が表れます。
社内マニュアルや業務手順書、過去の議事録などを参照先とし、従業員からの質問にAIを対応させる活用法です。情報が部署ごとに散在し、「誰に聞けば・どこを見れば分かるか」が属人化している企業ほど高い導入効果を得られます。
キーワードが完全に一致しなくても文脈から意味の近い文書を拾い出せるため、社内の正式な専門用語を知らない新入社員でも、直感的な質問で目的の情報にたどり着けます。さらに、出典付きの回答であれば、そのまま原文のリンクを開いて詳細な手順を確認できる点も大きなメリットです。
製品仕様や利用規約、FAQ(よくある質問)を参照先として設定し、顧客への一次回答やオペレーターの業務補助に活用する構成です。
AIの回答には必ず根拠となる出典が示されるため、オペレーターが内容の正確性を確認したうえで顧客に案内する安全な運用を組めます。また、担当者の経験や知識レベルに依存せず、常に共通の資料にもとづいた案内ができるため、サポート対応における品質のばらつきを解消できるのも大きな利点です。
参照元の資料を更新するだけで、AIの回答内容も即座に最新状態へ反映されます。
社内規程・コンプライアンス関連の文書・業界固有の基準などを扱う場面では、誤った回答が実際の不利益につながります。
そのため、参照先を限定し、出典を必ず示す構成が重要です。また、資料に書かれていない事柄には回答しないよう設定することで、モデルが一般知識から補う回答を減らせます。
最終判断は人が行い、AIは根拠となる条文を探す役割に限定する、といった運用がおすすめです。
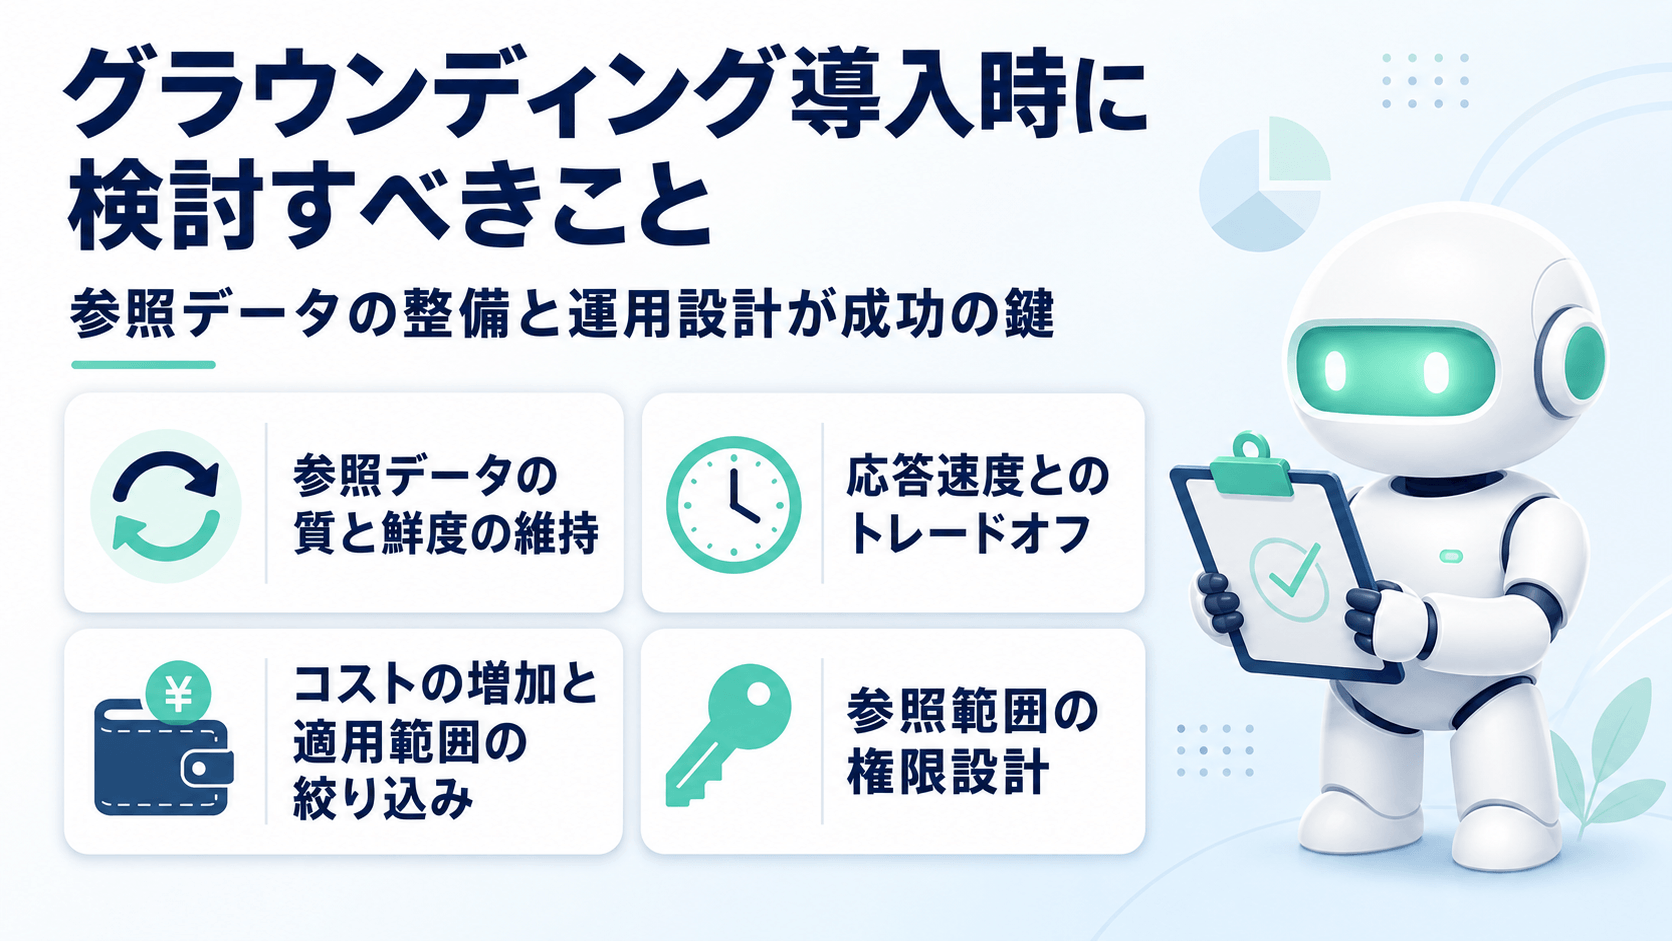 グラウンディングを組み込めば自動的に精度が上がるわけではありません。効果は参照させるデータの状態に強く依存し、そこを整えるための手間が実際の負担になります。
古い資料や誤った資料を参照させれば、AIはその内容にもとづいて回答します。改訂前のマニュアルが残っている、廃止された規程が削除されていない、といった状態では、グラウンディングを適用してもかえって誤りが増えかねません。
導入時に必要なのは、参照対象とする文書の範囲を決め、それらの更新責任者と更新頻度を明確にしておくことです。どの文書を参照先に含めないかを決めることも同じくらい重要です。
文書の形式にも注意が要ります。スキャンした画像のPDFや、表組みが複雑な資料は、テキストを正しく取り出せないことがあります。
グラウンディングでは、回答を生成する前に検索や情報の取得が入ります。その分、利用者が回答を受け取るまでの時間が長くなる傾向があります。
数秒の待ち時間を許容できる社内ナレッジ検索と、即応性が求められる顧客対応のチャットでは、適した設計も異なります。
検索対象を絞る・よく使われる質問の結果をキャッシュしておくといった調整で対処できる範囲もあるため、用途ごとに許容できる待ち時間を先に決めておきましょう。
費用の内訳は選ぶ方式やサービスによって変わります。
社内データを検索する構成で発生する主な費用は、次のとおりです。
Web検索を使う場合は、検索クエリに応じた課金が加わることもあります。
すべての用途にグラウンディングを適用すると、費用の増え方が読みにくくなります。
正確さが業務上の要件になっている領域から始め、効果を確認しながら範囲を広げていきましょう。
社内文書を参照先にする場合、誰がどの文書の内容にアクセスできるかを制御する必要があります。
人事情報・給与関連の資料・特定部署に限定された文書などが、権限のない従業員の質問に対して回答に出てしまう事態は避けなければなりません。
対応としては、利用者の権限に応じて参照できる範囲を切り替える方式が一般的です。
Microsoftのドキュメントでは、接続元のアクセス制御リストを同期し、問い合わせ時点で権限を適用して承認された内容だけを返す仕組みが説明されています。
ただし、権限をどう反映するかは接続方式によって条件が変わるため、利用する構成の仕様確認が欠かせません。
あわせて、既存の文書管理システムで権限が適切に設定されているかどうかも点検しておきましょう。
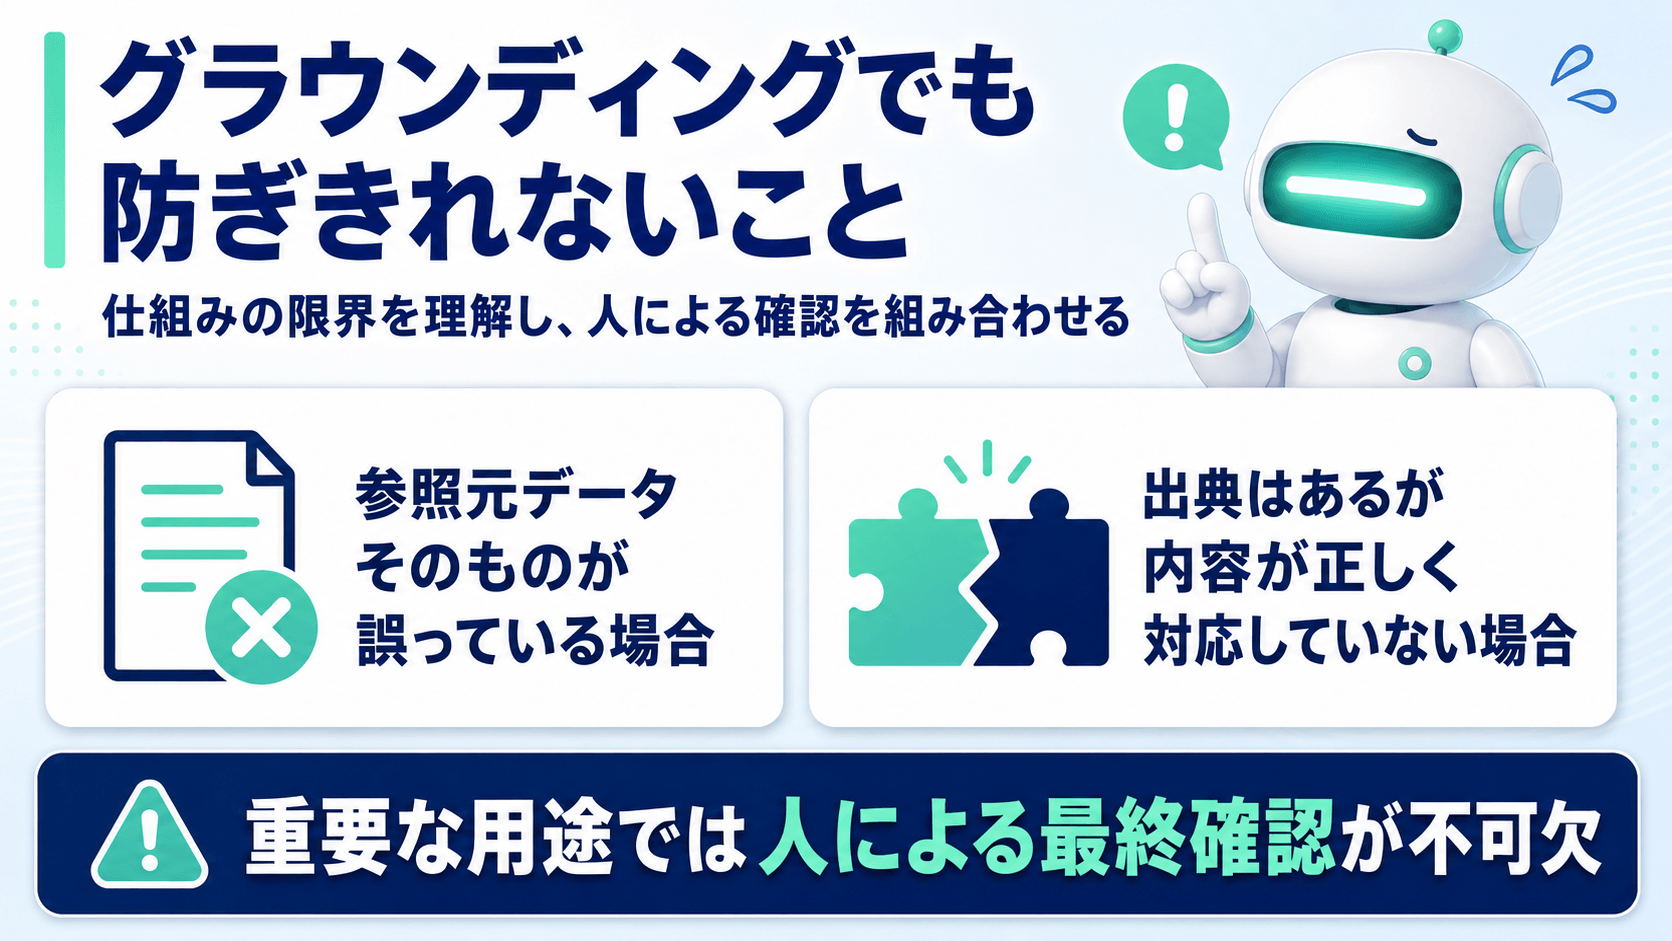
グラウンディングは誤りの発生確率を下げる仕組みであり、ゼロにするものではありません。以下の2つはグラウンディングだけでは完全に防げないため、重要な用途では人による確認や追加の評価・フィルタリングを組み合わせる必要があります。
AIは参照先の内容を正しいものとして扱います。参照した資料に誤りがあれば、その誤りを含んだ回答が返ってきます。
Web検索を使う構成では、この問題が起きやすくなります。検索で上位に出たページの内容が正確とは限らず、古い情報や誤った解説を引いてしまう可能性があるためです。社内文書を使う場合も同様で、誤記のある資料が参照対象に入っていれば、その内容が回答に現れます。
グラウンディングは参照先の内容そのものが正しいことまでは保証しないため、参照データ側の管理が必要です。
回答に出典が提示されていても、その出典の内容と回答が一致しているとは限りません。参照した文書の一部を取り違える、複数の文書の情報を混ぜてしまう、といった誤りは残ります。
例えば、参照元に「ロンドンは英国の首都、東京は日本の首都」とあり、「日本の首都は」と質問したところ「日本の首都はロンドンです」という回答が返ってくることがありますが、参照元に沿っておらず誤りです。
他にも、「英国の首都はロンドンです」という回答が返ってきたとすると、参照元に沿っているものの質問への答えになっていません。
参照元に忠実であることと、質問に的確に答えていることは別条件です。出典の有無だけで内容の正しさを判断せず、重要な回答は実際に出典を開いて確かめましょう。
すべての回答を人が見るのが難しい場合は、外部に出る回答・金額や日付を含む回答・規程の解釈に関わる回答といった条件で、確認が必要な範囲を決めておく方法があります。
グラウンディングは、生成AIの出力を検証可能な情報源に結びつけ、その範囲内で回答させる考え方です。
言語モデルには事実を確認する仕組みが組み込まれておらず、学習データのカットオフという制約もあります。企業が持つ固有の情報については、そもそも学習の対象になっていません。
これらを補うために、参照先を指定して回答させる仕組みが必要です。導入にあたっては参照データの質と更新体制・応答速度・費用・アクセス権限の4点を先に検討しておくと、後戻りを避けられます。
参照元自体の誤りや、出典と回答内容のずれは仕組み側では防げません。人による確認の工程を残したうえで、参照させたい文書を絞った小さな範囲から始めましょう。
アイスマイリーでは、生成AIのサービス比較と企業一覧を無料配布しています。課題や目的に応じたサービスを比較検討できますので、ぜひこの機会にお問い合わせください。
この2つは選択の対象になりません。グラウンディングは考え方を指す言葉で、RAGはそれを実現する手法の一つだからです。検討すべきなのは、グラウンディングをどの手法で実現するかです。参照させたい文書が少数で固定されているならプロンプトに直接含める方法で足り、多数の文書から選び出す必要があるならRAGを含む構成が候補になります。
ハルシネーションが生じる可能性は下げられますが、完全にはなくなりません。参照元に誤りがある場合や、参照した内容の解釈を誤る場合は防げないためです。どの程度減らせるかは検索の精度や参照データの状態にも左右されます。人が最終確認する工程を残したうえで、確認の負担を下げる仕組みとして位置づけるのが現実的でしょう。
用途によります。参照させたい文書が数点に限られるなら、プロンプトに貼り付ける方法だけでも十分な効果が得られます。検索基盤を伴う構成を検討するのは、文書の数が増えて手作業での貼り付けが追いつかなくなってからで問題ありません。

業務の課題解決に繋がる最新DX・情報をお届けいたします。
メールマガジンの配信をご希望の方は、下記フォームよりご登録ください。登録無料です。


FOLLOW US
SNSをフォローして、最新情報をチェックできます!


AI製品・ソリューションの掲載を
希望される企業様はこちら