


生成AI
最終更新日:2026/11/04
2026年10月、米Reflection AIが初のオープンウェイトモデル「Beam」を発表しました。同社はNVIDIAから巨額の出資を受けている企業です。
「Beamとはどんなモデルなのか」「中国製のオープンモデルと比べて実力はどうか」「今すぐ自社で使えるのか」。こうした疑問を持つ方も多いのではないでしょうか。
本記事では、Beamのスペックや特徴、ベンチマーク性能、APIでの使い方、料金と公開予定を公式情報をもとに整理しました。企業が導入を検討する際のチェックポイントもあわせて解説します。
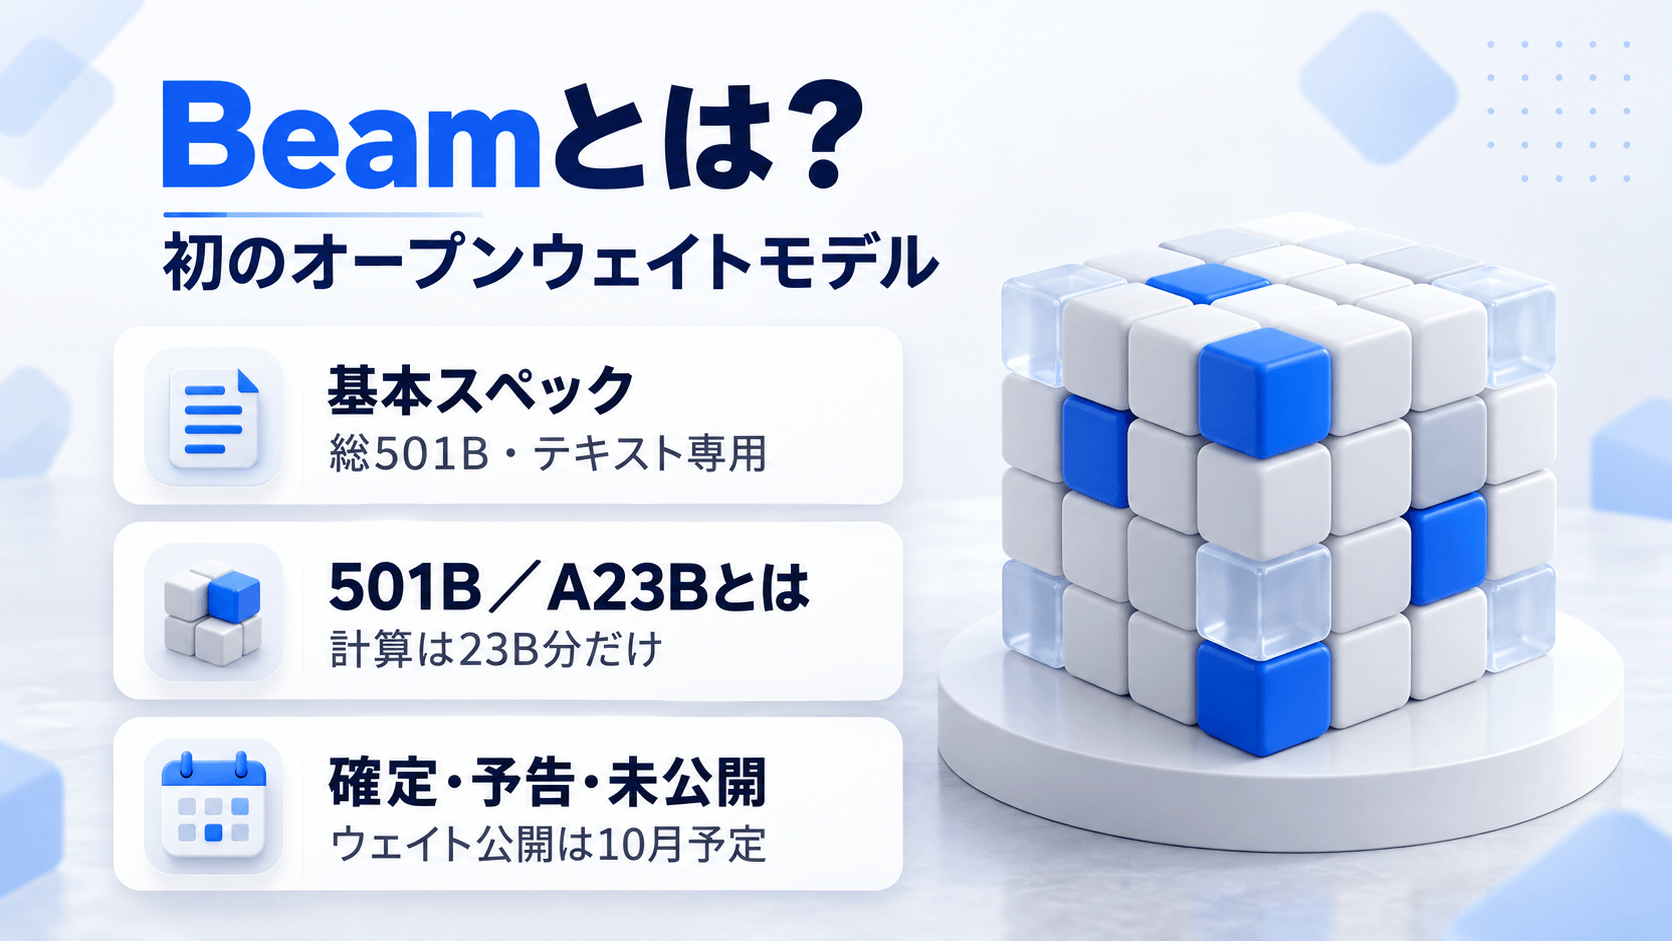
Beamは、Reflection AIが2026年10月5日(米国時間)に発表した同社初のオープンウェイトモデルです。コーディング・推論・AIエージェント業務に特化した、総パラメータ5010億(501B)の大規模言語モデルです。
オープンウェイトとは、学習済みモデルの「重み(パラメータ)」を公開する形態のことです。利用者は自社のサーバーでモデルを動かしたり、独自データで追加学習したりできます。学習データやコードまで含めて公開する「オープンソース」とは、厳密には区別されます。
まずはBeamの基本情報を一覧で確認しましょう。
| 項目 | 内容 |
| 開発元 | Reflection AI(米国) |
| 発表日 | 2026年10月5日(米国時間) |
| モデルID | Beam-501B-A23B |
| アーキテクチャ | Mixture-of-Experts(MoE) |
| パラメータ数 | 総数501B/アクティブ23B |
| 入出力 | テキストのみ(画像などは非対応) |
| コンテキスト長 | 学習上は最大100万トークン/APIベータ版は256Kトークン |
| 最大出力 | 128Kトークン |
| 知識カットオフ | 2026年6月30日 |
| 事前学習データ | 23.8兆トークン |
| ライセンス | Apache 2.0(ウェイト公開時に適用予定) |
※Reflection AI公式ブログおよび開発者向けドキュメント(2026年10月9日時点)に基づきます。
コンテキスト長とは、モデルが一度に読み込める文章量の上限です。トークンは文章を細かく区切った処理単位を指します。学習上の上限と、API提供時の上限が異なる点に注意してください。
出典:Introducing Beam: Reflection’s 501B open-weight model|Reflection/Models|Reflection Developers
BeamはMoE(Mixture-of-Experts)という構造を採用しています。MoEは、モデル内部に多数の「専門家(エキスパート)」を持たせる仕組みです。入力ごとに必要な専門家だけを選んで計算するため、処理を効率化できます。
Beamの場合、総パラメータは501Bですが、1トークンの処理で実際に動くのは23Bです。モデル名の「501B-A23B」は、この「総数501B・アクティブ23B」を表しています。
ただし、計算が軽くなることと、必要なメモリが小さくなることは別の話です。どの専門家が呼ばれるかは入力次第のため、自社で動かすには501B分のパラメータをすべてメモリに載せる必要があります。「23Bだから手元のPCで動く」とはならない点を押さえておきましょう。
Beamは発表直後のため、すでに使える部分と、予告にとどまる部分が混在しています。現時点の状況を3つに分けて整理しました。
| 区分 | 主な内容 |
| 確定(提供中) | API早期アクセス(ウェイトリスト制)、モデルスペック、推論の深さ調整機能、Mirror CLIなどでの利用 |
| 予告(10月中予定) | ウェイトの公開(Apache 2.0)、技術レポート、モデルカード、開発者向けツール、配布パートナー経由の提供 |
| 未公開 | API料金、推論時に必要なGPU要件、日本語性能、APIのデータ保持方針、安全性評価の結果 |
※2026年10月9日時点の公式情報に基づきます。予定は変更される可能性があります。
つまり、現時点ではBeamのウェイトをダウンロードして自社運用することはできません。利用できるのは、ウェイトリスト登録者向けのAPIに限られます。
出典:Introducing Beam: Reflection’s 501B open-weight model|Reflection
Reflection AIは、元Google DeepMindの研究者が2024年に創業した米国企業です。掲げるのは「最先端のオープンな知能を誰もが使えるようにする」こと。NVIDIAをはじめとする投資家から、巨額の資金を集めています。
共同創業者は、CEOのMisha Laskin氏とIoannis Antonoglou氏の2人です。いずれもGoogle DeepMindで研究に携わっていた人物として知られています。
公式ブログによると、PaLMやGemini、AlphaGo、AlphaCodeの開発経験者がチームに在籍しています。ChatGPTやCharacter AIに貢献した経験者もいます。大手AI研究所で最先端モデルを作ってきた人材が、オープンモデルに挑む構図です。
Reflection AIは公式ブログで、20億ドルの資金調達を発表しています。出資者として名前が挙がっているのは次のとおりです。
米メディアの報道によると、この20億ドルの調達は2025年10月に実施され、評価額は約80億ドルでした。そのうちNVIDIAが約8億ドルを出資したと伝えられています。さらに2026年には、評価額250億ドル規模での追加調達も報じられました。
NVIDIAは出資だけでなく、顧客の紹介や大型インフラ契約の組成も支援していると報じられています。BeamもNVIDIAの最新GPU「GB300」で学習されました。
出典:Building Frontier Open Intelligence|Reflection
Reflection AIが注目される背景には、オープンウェイトモデルをめぐる米中の競争があります。
現在、高性能なオープンモデルの分野では中国勢が先行しています。DeepSeek、AlibabaのQwen、Z.aiのGLM、Moonshot AIのKimiなどが代表例です。一方で、米国の企業や公的機関には「中国製モデルは調達基準上使いにくい」という事情があります。
こうした状況から、Reflection AIは「米国版DeepSeek」とも呼ばれてきました。Beamは、米国発の有力なオープンモデルを求める層の受け皿として期待されているのです。
同社は、企業や国家が自社データでモデルを鍛えて運用する「AI Factory」構想も打ち出しています。2026年3月には、韓国の新世界グループと覚書(MoU)を締結したと報じられました。ソブリンAI(自国で管理するAI基盤)向けに、250MW規模のAI Factoryを韓国に建設する計画です。GPU需要を生むこの構想は、NVIDIAの戦略とも重なるものです。
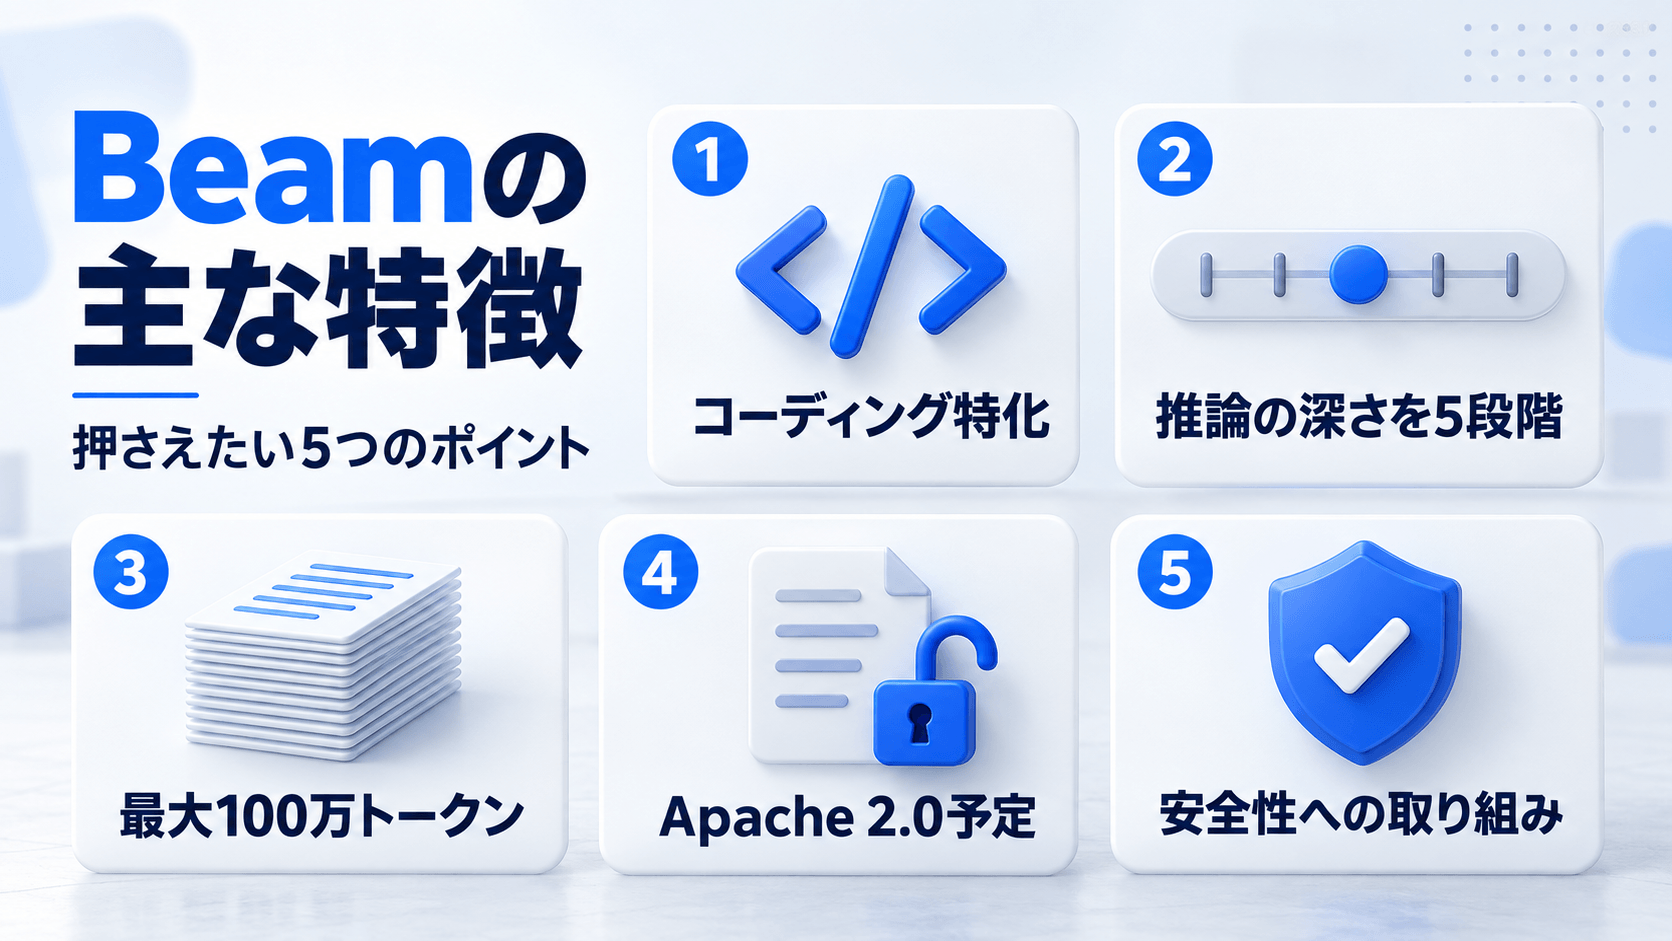
Beamの強みは、コーディング・AIエージェント性能の高さと、推論の効率性にあります。推論の深さを用途に応じて調整できる点も、実務で使いやすいポイントです。
Beamは、コードの作成・修正や、複数の手順をこなすエージェント業務を主な用途として設計されています。公式ブログでは「頼れる主力(ワークホース)モデル」と表現されています。
その性能を支えるのが、大規模な強化学習です。強化学習とは、AIが試行錯誤を通じて、より良い行動を学ぶ手法を指します。Beamは約100万種類の学習環境で、1億回を超える試行(ロールアウト)を重ねました。この過程で約1万500基のGB300を4週間稼働させています。
公式のデモでは、Webでの調査、アプリ開発、3Dゲームの作成などが紹介されました。
Beamでは「reasoning effort」というパラメータで、推論の深さを指定できます。設定値は次の5段階です。
| 設定値 | 向いている用途 |
| low | 応答速度を重視したい単純なタスク |
| medium(既定値) | 一般的なタスク。まずはこの設定から |
| high | コード・数学・複数ステップの計画など |
| xhigh | より難度の高い問題 |
| max | 最高精度を求める場合(応答時間とトークン消費が最大) |
※Reflection AI開発者向けドキュメント(2026年10月9日時点)に基づきます。
推論を深くするほど回答の質は上がりやすい一方、応答時間とトークン消費は増えます。なお、Beamは推論を完全にオフにすることはできません。
出典:Reasoning|Reflection Developers
Beamは中間学習の段階で、扱える文脈の長さを100万トークンまで拡張しています。リポジトリ全体のコードや長大な文書をまとめて読み込む用途に役立つでしょう。
現在のAPIベータ版で使える上限は256Kトークンです。入力と出力を合わせた量で数えられ、上限を超えたリクエストはエラーになります。ベータ期間中は上限が変わる可能性もあります。
ウェイトは「Apache 2.0」ライセンスで公開される予定です。Apache 2.0は、商用利用・改変・再配布を幅広く認める寛容なライセンスとして知られています。
独自の利用制限を設けるオープンモデルもある中で、企業にとって扱いやすい条件と言えるでしょう。実行・評価・ファインチューニング(追加学習)向けのドキュメントやツールも、あわせて提供される見込みです。
Reflection AIは、能力を伸ばすモデルとは別に、安全性に特化したモデルを用意しました。そのうえで2つを「マルチティーチャー・オンポリシー蒸留(MOPD)」という手法で統合しています。蒸留とは、教師役のモデルの知識を別のモデルに移す技術のことです。
行動原則は3層構造です。「ルール(安全方針など)」「一貫した資質(正確さなど)」「既定のスタイル」に分けて整理されています。安全性評価の結果は、今後公開される技術レポートに掲載される予定です。
出典:Introducing Beam: Reflection’s 501B open-weight model|Reflection
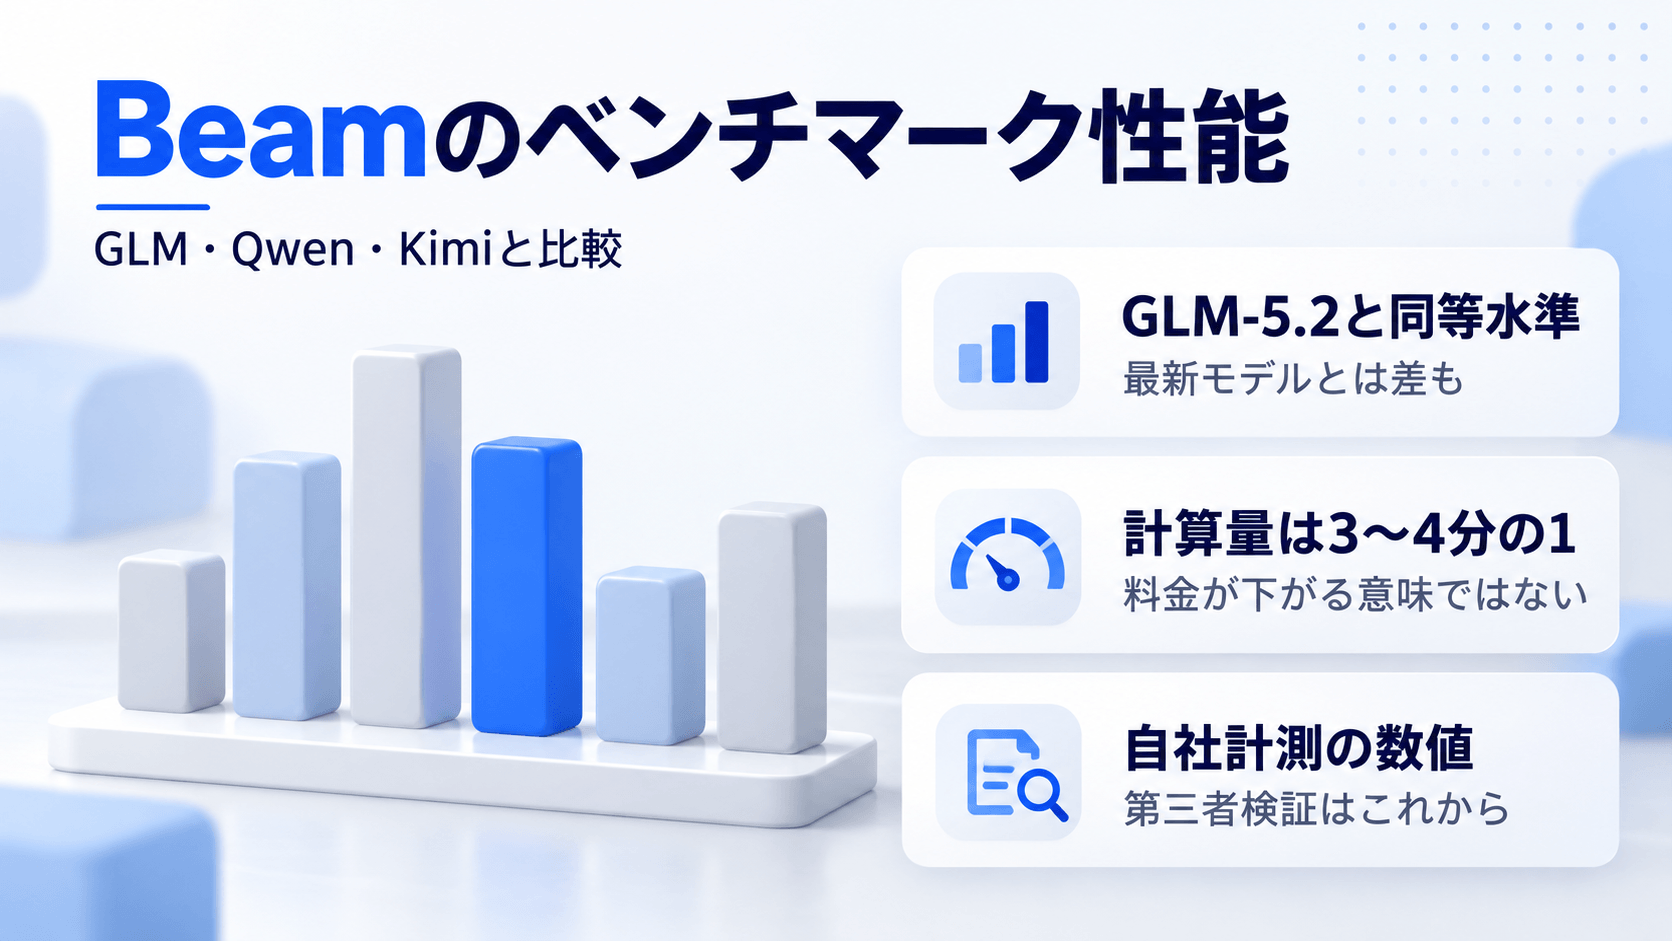
Reflection AIの発表では、Beamは中国Z.aiのGLM-5.2と同等水準です。AlibabaのQwen 3.8-Maxにも迫る性能を示しました。一方、Z.aiの最新モデルGLM-5.3やKimi K3、DeepSeek V4.1 Flashが上回る項目も多くあります。Beamは「効率重視」のモデルと位置づけられるでしょう。
ベンチマークとは、AIモデルの性能を共通の課題で測る評価テストのことです。公式ブログで公表された主なスコアを比較します。
| ベンチマーク | Beam | GLM-5.2 | GLM-5.3 | Qwen 3.8-Max | Kimi K3 | DeepSeek V4.1 Flash |
| SWE-Bench Pro v1 | 65.5 | 62.1 | ― | 67.7 | ― | ― |
| Terminal-Bench v2.1 | 80.1 | 81.0 | 88.2 | 86.6 | 88.3 | 90.6 |
| DeepSWE v1.1 | 44.4 | 44.0 | 61.0 | 51.0 | 68.0 | 74.2 |
※Reflection AI公式ブログ(2026年10月8日更新版)の自社計測値に基づきます。「―」は公式発表で比較値が示されていない項目です。
SWE-bench系の評価(SWE-Bench Proなど)は、実際のソフトウェア開発で起きた不具合をAIが修正できるかを測るものです。Terminal-Benchは、コマンドライン操作でタスクをこなす力を測定します。
このほか、BeamはSWE-bench Verifiedで80.9を記録しました。SWE-bench Multilingualでは78.0です。米Thinking Machines LabのInklingに対しては、公式比較表の4項目すべてで上回りました。
表を見ると、BeamはGLM-5.2と互角です。とはいえ、後継のGLM-5.3やKimi K3、DeepSeek V4.1 Flashとは差が残ります。純粋な性能で中国勢を超えたわけではありません。
Beamの大きな売りは推論効率です。高度な推論ベンチマークで、GLM-5.2と同等のスコアを3〜4分の1の計算量で達成しました。
注意点として、この比較は「アクティブパラメータ数×生成トークン数」による概算です。プロンプトの読み込み処理や、サーバー運用のオーバーヘッドは含まれていません。
そのため、「API料金が3〜4分の1になる」という意味ではありません。実際のコストは料金体系や運用環境で変わるため、料金発表後に改めて比較する必要があります。
ここで紹介したスコアは、すべてReflection AIによる自社計測値です。第三者による独立した検証は、まだ行われていません。
公式ブログのベンチマークは10月8日に更新されており、今後も数値が見直される可能性があります。また、比較相手のInklingはマルチモーダル(画像なども扱える)モデルで、テキスト専用のBeamとは前提が異なります。導入を判断する際は、自社の業務データで再評価することをおすすめします。
出典:Introducing Beam: Reflection’s 501B open-weight model|Reflection
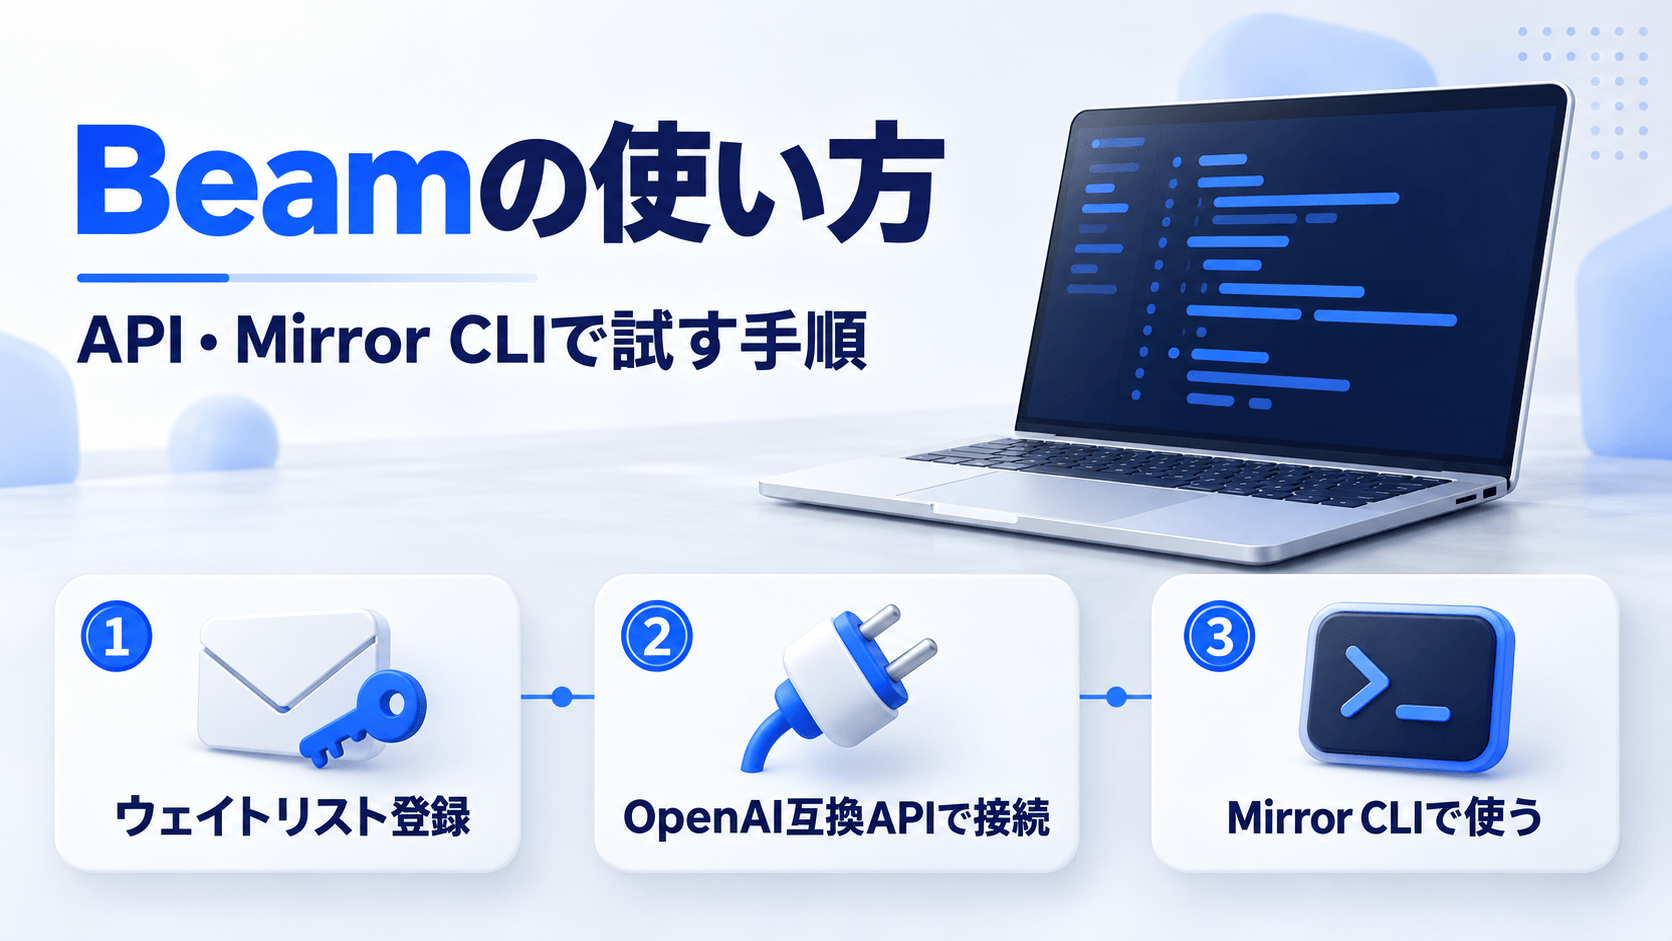
現時点でBeamを使う方法は、ウェイトリスト登録者向けのAPI早期アクセスです。ウェイトが公開されれば、自社環境での運用も可能になります。
まずはReflection AIの開発者プラットフォームでウェイトリストに申し込みます。URLはplatform.reflection.aiです。アクセスは招待制で、段階的に開放されています。
利用が承認されたら、プラットフォーム上でAPIキーを発行しましょう。APIキーは、外部のプログラムからBeamを呼び出すための認証情報です。
BeamのAPIは、OpenAIのAPIと互換性のある形式で提供されています。OpenAI向けのSDK(開発キット)をそのまま使い、接続先とモデルIDを変えるだけで呼び出せます。
Pythonでの呼び出し例は次のとおりです。
Python
from openai import OpenAI

client = OpenAI(
    base_url="https://api.reflection.ai/openai/v1",
    api_key="YOUR_REFLECTION_API_KEY",
)

response = client.chat.completions.create(
    model="Beam-501B-A23B",
    reasoning_effort="medium",
    messages=[{"role": "user", "content": "このPython関数のバグを修正してください。"}],
)
print(response.choices[0].message.content)
注意したいのは、推論に使われたトークンも出力上限(max_completion_tokens)に含まれる点です。上限が小さすぎると、回答本文が空のまま途中で終了することがあります。その場合は上限を引き上げるか、reasoning effortを下げてください。
出典:Models|Reflection Developers/Reasoning|Reflection Developers
Reflection AIは、Beamを標準で使うコーディングエージェント「Mirror CLI」も提供しています。ターミナル上でAIにコードの読解や修正を任せられるツールです。
対応環境は、macOS 15以降(Apple Silicon)とLinuxです。Windowsのネイティブ環境には対応していません。
基本的な流れは次のとおりです。
OpenCode、Pi、Hermes Agentなど、外部のコーディングエージェントからも利用可能です。いずれもOpenAI互換のエンドポイントとモデルIDを設定する方式です。
出典:Coding agents quickstart|Reflection Developers
ウェイトは2026年10月中に公開される予定です。公開後は、自社のサーバーやクラウド上でBeamを動かせるようになります。
推論に必要なGPU構成は、現時点では公表されていません。前述のとおり、501B分のパラメータをメモリに載せる必要があるため、一般的なPCでの実行は現実的ではないでしょう。データセンター向けGPUを複数枚備えた環境が前提になると考えられます。具体的な要件は、技術レポートの公開を待って確認してください。
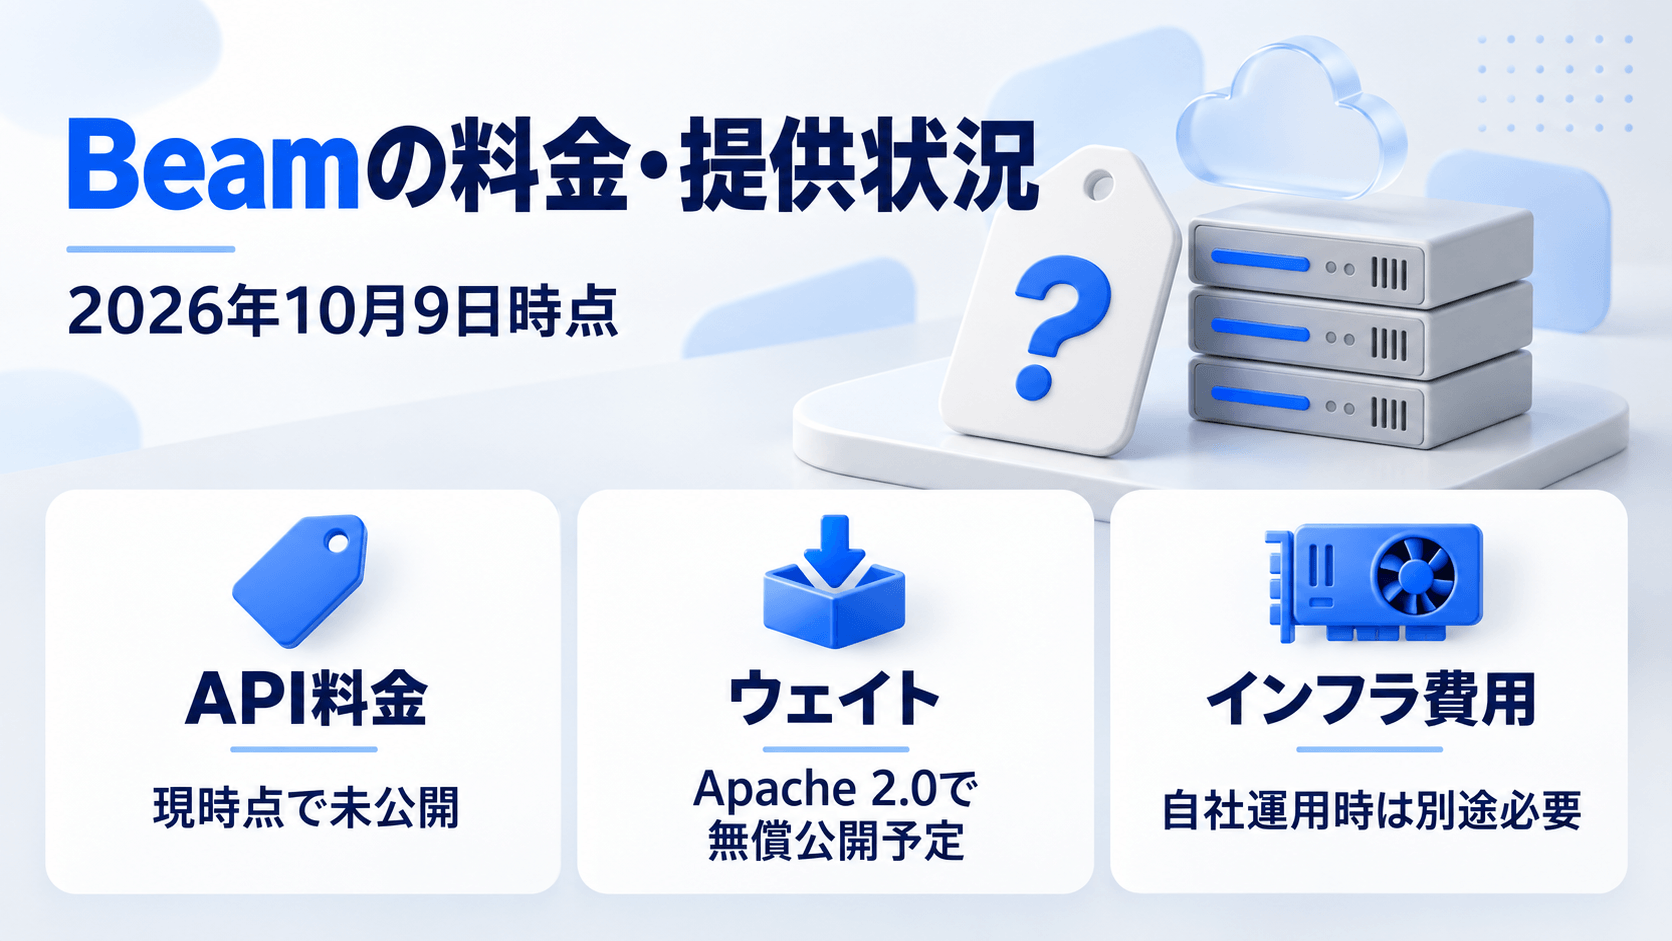
2026年10月9日時点で、BeamのAPI料金は公開されていません。早期アクセスの段階であり、正式な料金体系は今後の発表を待つ必要があります。
一方、ウェイトはApache 2.0で無償公開される予定です。自社のGPUで動かす場合、モデルのライセンス費用はかかりません。ただし、GPUサーバーの調達や運用にかかるインフラ費用は別途発生します。
ウェイト公開にあわせて、クラウド経由での提供も予定されています。対象は大手クラウド(ハイパースケーラー)やGPU特化型クラウド(ネオクラウド)です。オープンソースのライブラリやエージェントツールとの連携も、公開時点から用意される見込みです。具体的なパートナー名は発表されていません。
料金・提供条件は変更される可能性があるため、最新情報は公式サイトをご確認ください。
出典:Introducing Beam: Reflection’s 501B open-weight model|Reflection
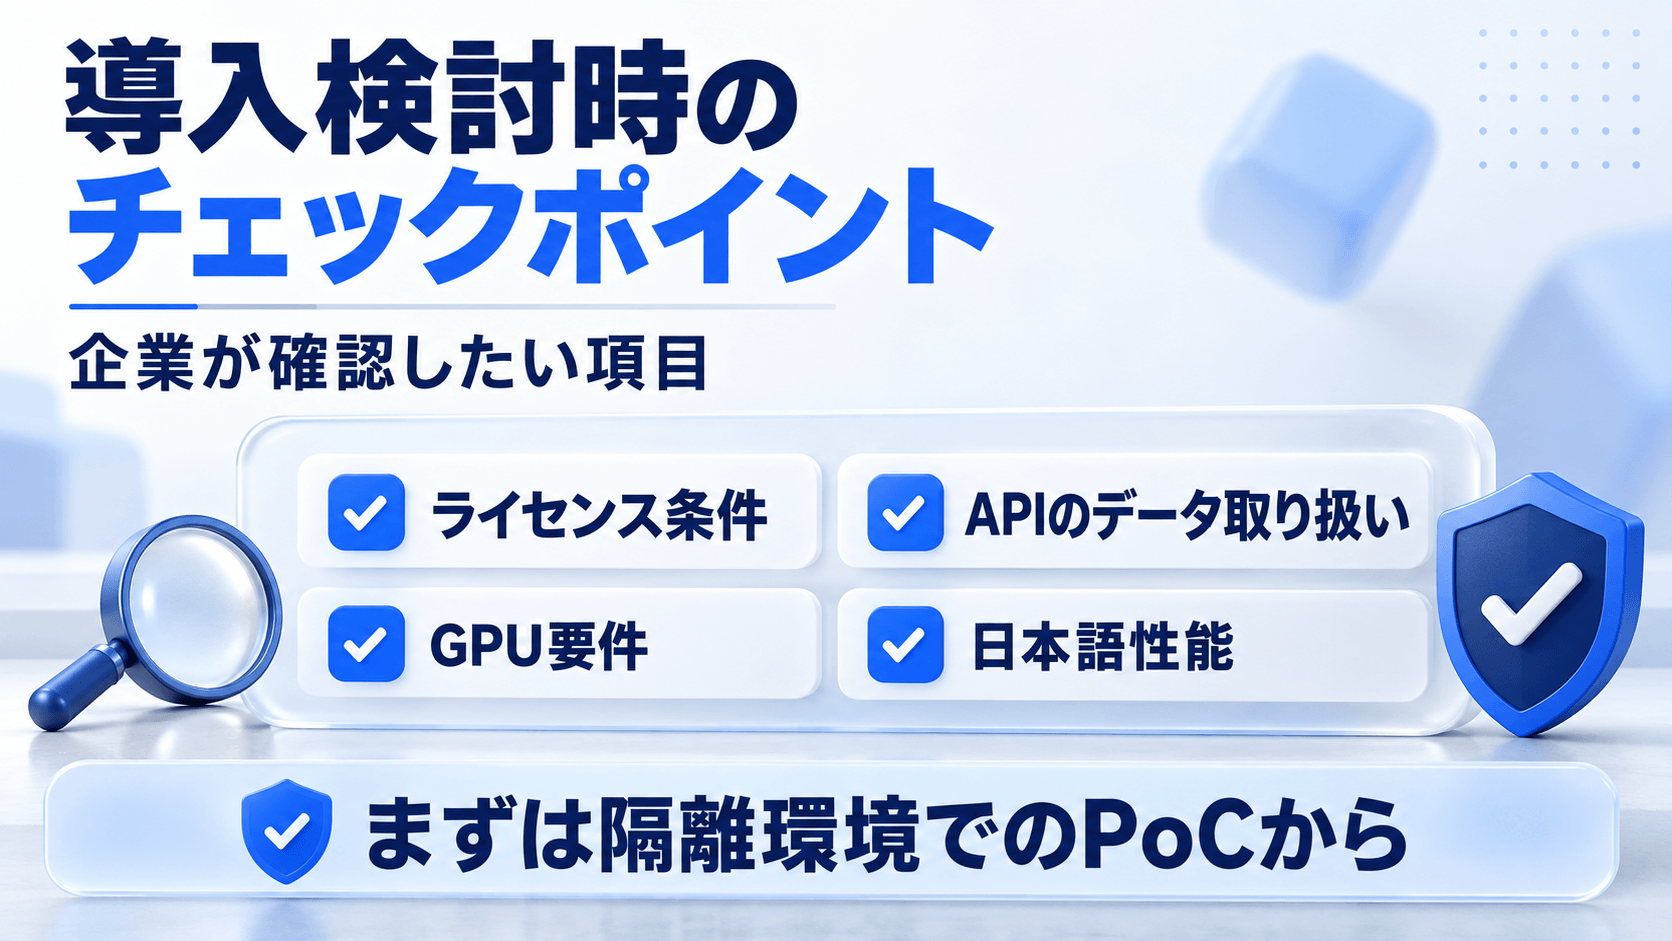
Beamは「米国製」「Apache 2.0」「自社環境で運用可能」という3点で、企業にとって魅力的な選択肢です。もっとも、現時点では未公開の情報が多く、まずはPoC(試験導入)で評価するのが現実的でしょう。
導入前に確認しておきたい項目をチェックリストにまとめました。
| 確認項目 | 現状(2026年10月9日時点) | 確認方法・対応 |
| ライセンス条件 | Apache 2.0で公開予定 | 公開時のライセンス文書を法務部門と確認 |
| APIのデータ取り扱い | 保持・学習利用の方針は未公開 | 機密データはAPIに送らず、規約公開後に再判断 |
| 自社運用時のGPU要件 | 未公開(501B分のメモリが必要) | 技術レポート公開後にインフラ費用を試算 |
| 日本語性能 | 公式に言語対応の記載なし | 自社の日本語業務データで検証 |
| エージェントの権限管理 | ツールにより安全設定が異なる | コンテナ等の隔離環境で試す |
| 安全性評価 | 技術レポートで公開予定 | 公開後に評価結果を確認 |
| 社内規程との整合 | ― | 開発国の要件、AI利用ガイドラインと照合 |
特に注意したいのが、コーディングエージェントの権限です。Mirror CLIはツール実行の前に承認を求めます。しかし公式ドキュメントには、承認はサンドボックス(隔離環境)ではないと明記されています。OpenCodeは初期設定で多くのツール実行を許可しており、Piは承認なしでツールを実行します。
業務用のPCでいきなり使うのではなく、コンテナや仮想マシンなどの隔離環境で試すのが安全です。
出典:Coding agents quickstart|Reflection Developers
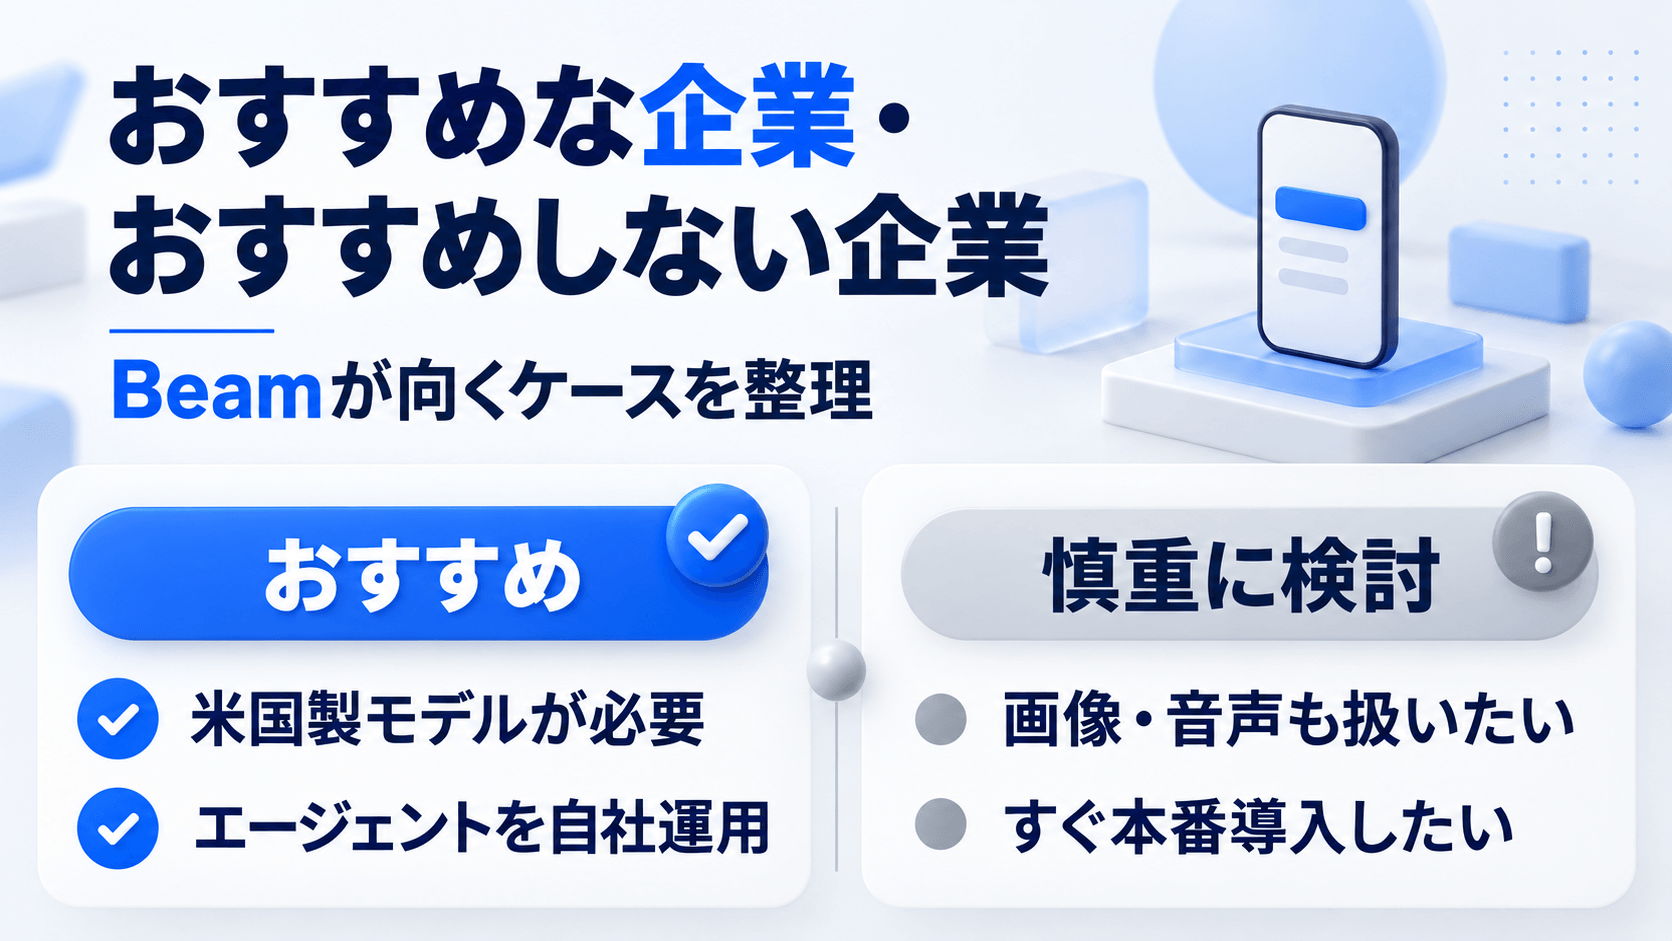
Beamは、米国製のオープンモデルでコーディングやエージェント業務を内製化したい企業に向いています。反対に、画像を扱いたい場合や、すぐ本番運用したい場合は慎重な判断が必要です。
Beamがおすすめな企業
Beamをおすすめしない企業
主な選択肢の特徴を整理すると、次のようになります。
| 選択肢 | 向いているケース |
| Beam | 米国製・Apache 2.0のモデルを効率重視で使いたい |
| GLM-5.3/Qwen 3.8-Max | 中国製でも問題なく、より高い性能のオープンモデルを使いたい(独自ライセンスの条件確認が必要) |
| Kimi K3など最上位のオープンモデル | オープンモデルの中で最高水準の性能を優先したい |
| クローズドモデル(API型) | 自社運用の手間をかけず、すぐ高性能なAIを使いたい |
Beamは、NVIDIAが出資するReflection AIが送り出した、米国発のオープンウェイトモデルです。本記事のポイントを3つに整理します。
今すぐ試したい方は、ウェイトリストに登録してAPIを触ってみるとよいでしょう。本格導入を検討する企業は、10月中のウェイトと技術レポートの公開を待ちましょう。GPU要件や安全性評価を確認してからの判断が安心です。
オープンモデルの選定や、自社データを活用したAIシステムの構築に悩んだら、専門の開発会社に相談するのも有効な手段です。
アイスマイリーでは、生成AI のサービス比較と企業一覧を無料配布しています。課題や目的に応じたサービスを比較検討できますので、ぜひこの機会にお問い合わせください。
ウェイトはApache 2.0で公開予定のため、自社環境で動かす場合のライセンス費用は不要です。GPUなどのインフラ費用は別途かかります。APIの料金は、2026年10月9日時点で公開されていません。
現時点ではダウンロードできません。ウェイトは2026年10月中に公開予定です。配布先は発表されていないため、公式サイトの続報を確認してください。
公式ドキュメントには、対応する自然言語についての記載がありません。日本語での業務利用を考えている場合は、自社のデータで精度を確かめてから判断しましょう。
名前は似ていますが、別のモデルです。Reflection 70Bは、Matt Shumer氏がHugging Faceで公開したモデルです。MetaのLlama 3.1 70Bをベースにしていました。Reflection AIのBeamとは開発元が異なります。
異なるものです。Apache Beamは、データ処理パイプラインを構築するオープンソース基盤です。BEAMは、Erlangなどの言語を動かす仮想マシンを指します。本記事のBeamは、Reflection AIのAIモデルです。
「501B」は総パラメータ数が5010億であることを表します。「A23B」は、1トークンの処理で動くパラメータが230億という意味です。
業務の課題解決に繋がる最新DX・情報をお届けいたします。
メールマガジンの配信をご希望の方は、下記フォームよりご登録ください。登録無料です。


FOLLOW US
SNSをフォローして、最新情報をチェックできます!


AI製品・ソリューションの掲載を
希望される企業様はこちら