


生成AI
最終更新日:2026/10/19
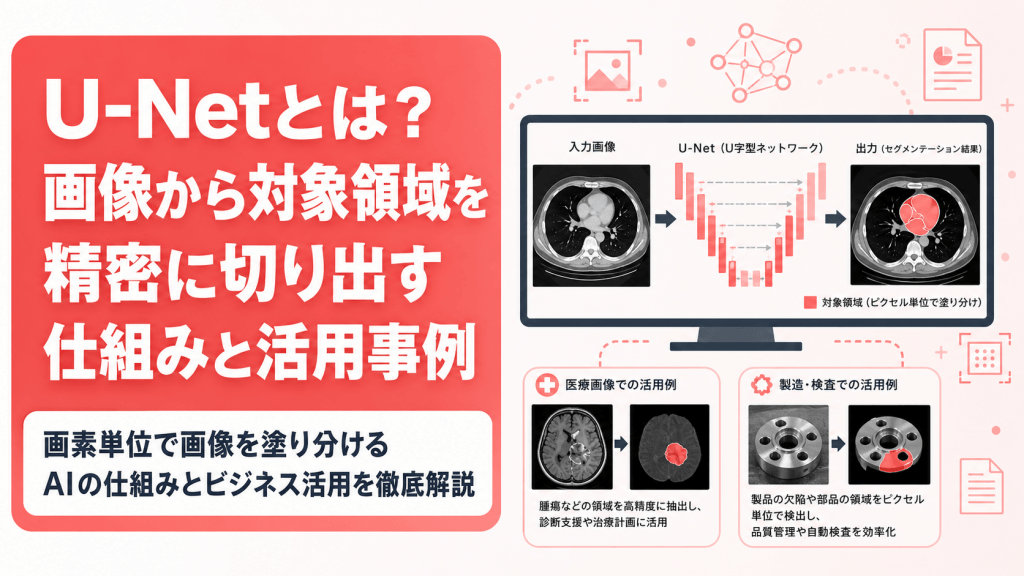
医療や製造業の画像認識で活躍する「U-Net」。しかし「数式や専門用語ばかりで挫折した」「実務への活かし方がわからない」という方は多いのではないでしょうか?
本記事では、画像を画素単位で精密に塗り分ける仕組みを「U字型」の構造に沿って、数式を使わず、図解でわかりやすく解説します。従来モデルとの違いや派生モデル、ビジネスでの活用事例まで網羅。
この記事を読めばU-Netの全貌を直感的に理解でき、自社の課題解決に活かせるか即座に判断できるようになります。
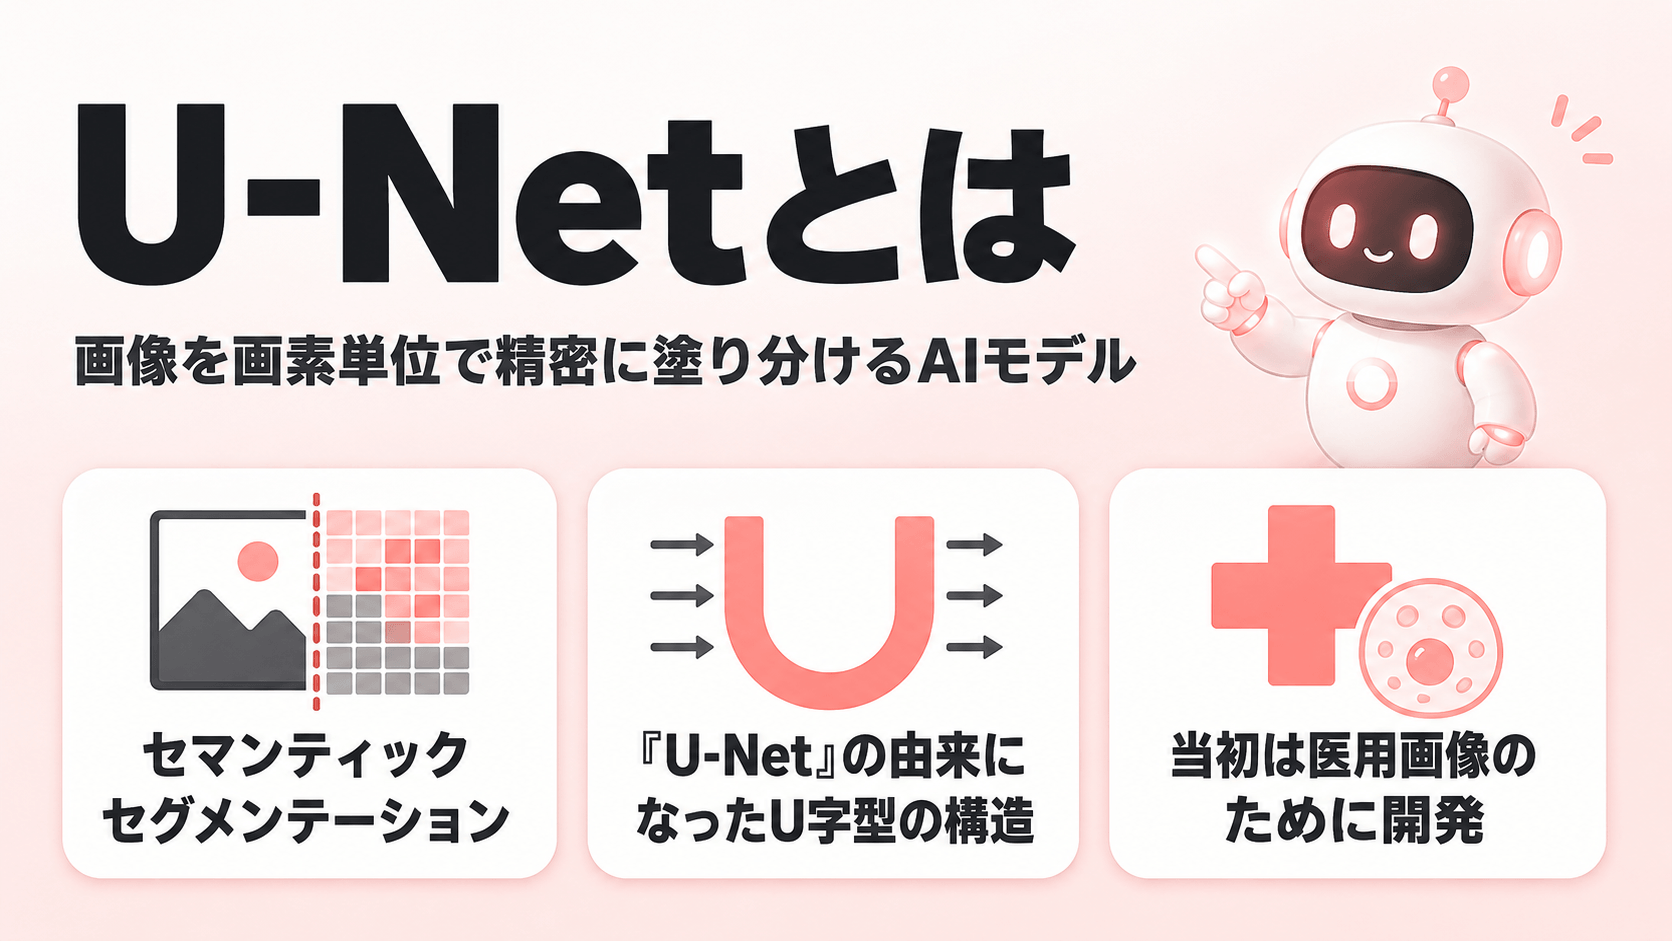
U-Netは、画像を画素(ピクセル)単位で塗り絵のように細かく分類するAIです。
単純に「これは猫の写真です」と答えるのではなく、「画像のここからここまでの画素が猫です」と輪郭に沿って精密に割り出します。このような細やかな塗り分けを可能にしているのが、U-Net最大の特徴である『U字型』のネットワーク構造です。
U-Netが行う処理は「セマンティックセグメンテーション」といいます。画像認識にはいくつかのタスクがあり、何を出力するかで次のように分かれます。
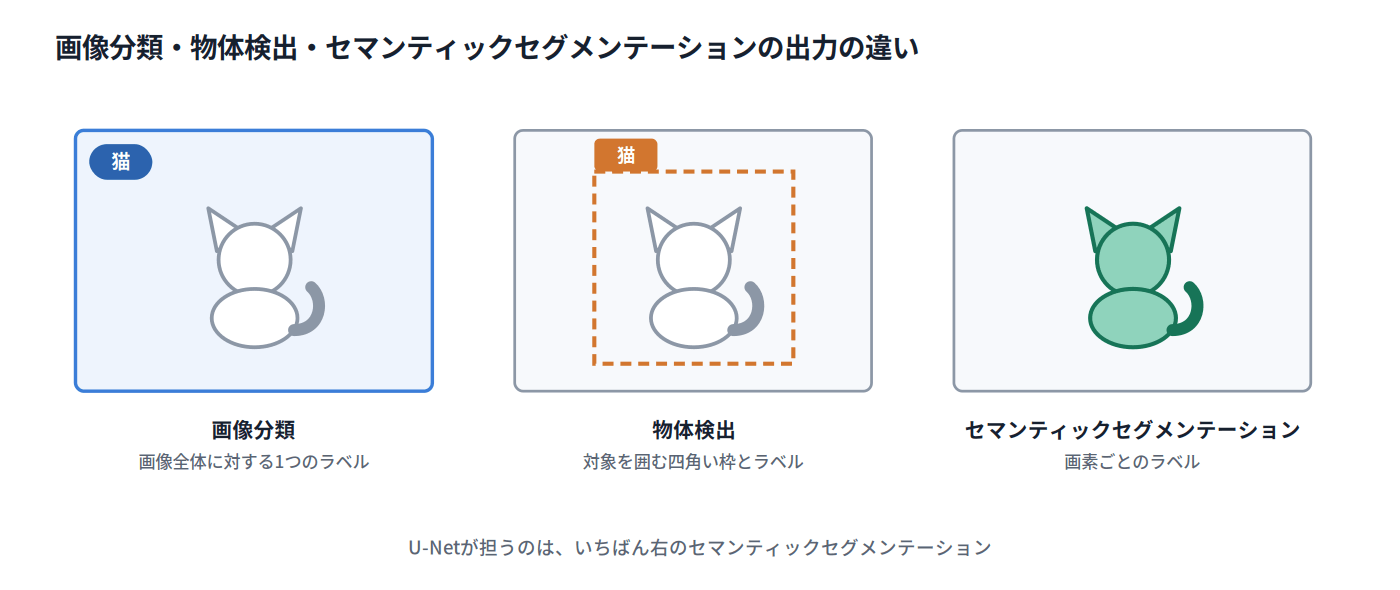
図:画像分類・物体検出・セマンティックセグメンテーションの出力の違いを比べた図解
| タスク | 出力されるもの | 猫の写真での例 |
|---|---|---|
| 画像分類 | 画像全体に対する1つのラベル | 「猫」と判定する |
| 物体検出 | 対象を囲む四角い枠とラベル | 猫を四角い枠で囲む |
| セマンティックセグメンテーション | 画素ごとのラベル | 猫の輪郭に沿って塗り分ける |
分かれ目は、対象の形をどこまで保つかです。物体検出の枠は対象を囲むだけなので、枠内には背景も一緒に入ります。セマンティックセグメンテーションは輪郭に沿って画素を分けるため、面積を測ったり、入り組んだ形の対象も扱えます。U-Netは、このセマンティックセグメンテーションを担うモデルです。
セグメンテーションの種類や、インスタンスセグメンテーションとの違いについては、セマンティックセグメンテーションとは?AI開発におけるセグメンテーションの種類と活用事例で解説しています。
U-Netでは、入力された画像をまず段階的に縮めていき、最も小さくなったところで折り返して、段階的に広げていきます。縮める処理で「何が写っているか」を掴み、広げる処理で画素ごとのラベルを組み立てる仕組みです。
この縮小から拡大へ向かう流れを図にすると、アルファベットの「U」の形になります。U-Netという名前は、この構造に由来します。
さらに、縮める処理と広げる処理を直接つなぐ「スキップ接続」も備わっています。縮小・拡大・スキップ接続の3つが、U-Netを構成する要素です。
U-Netを提案したのは、フライブルク大学のOlaf Ronneberger氏・Philipp Fischer氏・Thomas Brox氏です。2015年、医用画像を扱う国際会議MICCAIで発表した論文U-Net: Convolutional Networks for Biomedical Image Segmentationで公開されました。
当時の課題は、教師データの量でした。ディープラーニングで高い精度を出すには数千枚規模の正解データが必要とされていましたが、細胞の顕微鏡画像に1画素ずつ正解を付ける作業ができるのは専門家に限られ、大量に用意することが困難でした。少ない枚数からどこまで学習できるかという問題に対する答えとして提案されたのが、U-Netです。
U-Netの中を流れていくのは、画像そのものではなく、畳み込み処理によって得られる特徴マップと呼ばれるデータです。
特徴マップは数値が格子状に並んだデータで、元の画像と同じように縦横の広がりを持ち、それぞれの位置に輪郭や模様などの特徴がどれだけ強く現れているかが値として入っています。U-Netは、この特徴マップを縮小し、再び拡大していく構造として捉えると理解しやすいでしょう。
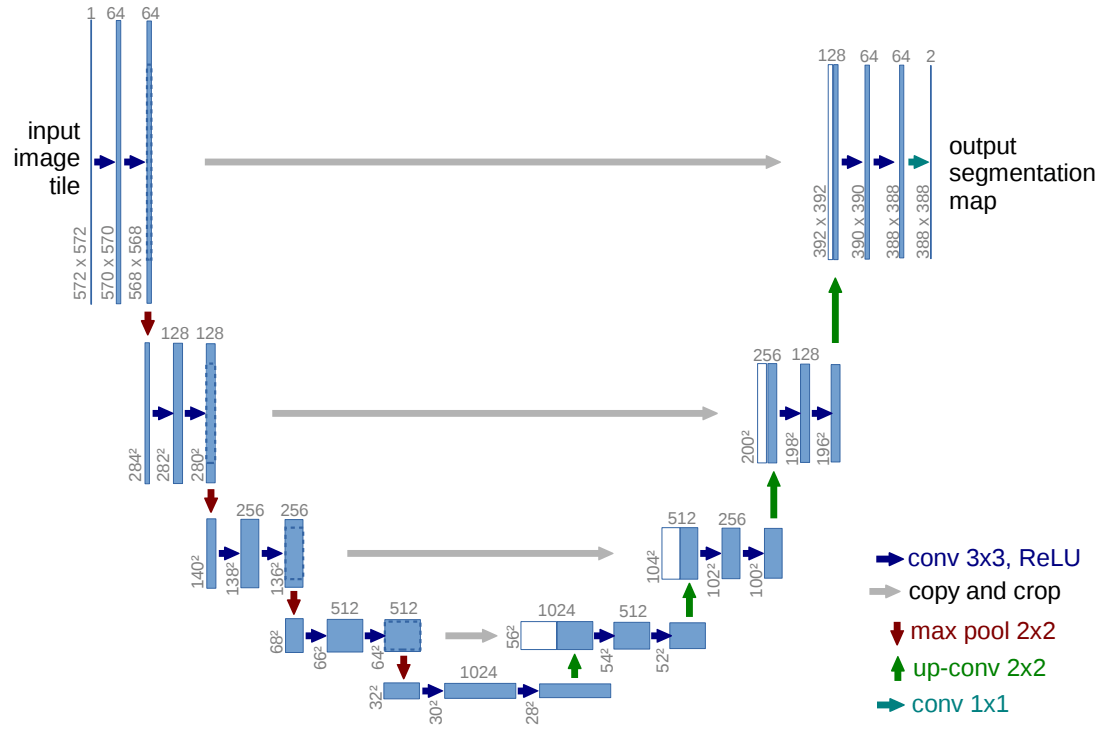
図:U-Netの全体構造
出典:Olaf Ronneberger, Philipp Fischer, Thomas Brox「U-Net: Convolutional Networks for Biomedical Image Segmentation」(2015) arXiv:1505.04597
入力された画像が最初に通るのが、エンコーダと呼ばれる部分です。収縮パスとも呼ばれ、畳み込みとプーリングを繰り返しながら特徴マップを段階的に縮めていきます。
U-Netの論文では、3×3の畳み込みとReLUという活性化関数を2回繰り返し、そのあと2×2のマックスプーリングで縦横を半分に縮める流れを1段としています。マックスプーリングのたびに特徴マップの縦横は半分になり、代わりにチャネル数は倍になります。
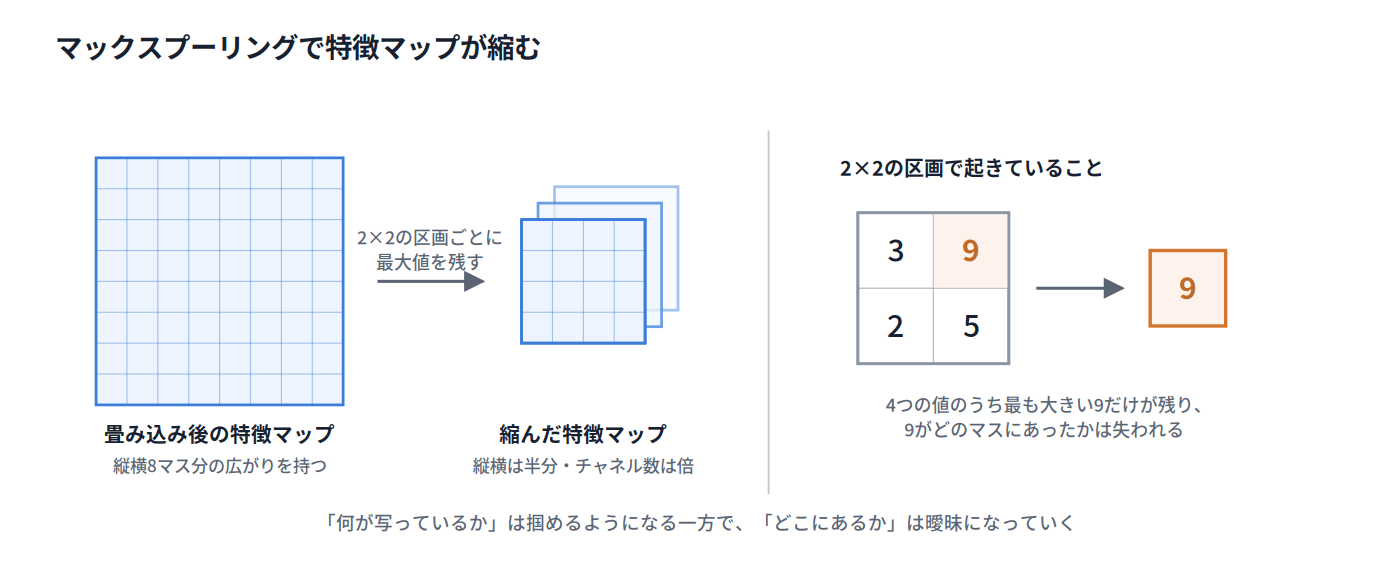
図:マックスプーリングで特徴マップが縮む様子
マックスプーリングでは、区画内で最も大きい値だけを残します。その結果、「強い反応があった」という情報は残る一方、区画の中のどこにあったかという細かな位置情報は失われていきます。つまり、縮小するほど「何が写っているか」は捉えやすくなる反面、「どこにあるか」は次第に曖昧になります。
エンコーダで最も小さくなった特徴マップは、続いてデコーダへ渡されます。デコーダは拡大パスとも呼ばれ、縮小した特徴マップの解像度を段階的に高める役割を担います。
拡大に使われるのは、アップコンボリューションと呼ばれる処理です。2×2のアップコンボリューションで縦横を2倍にし、同時にチャネル数を半分にします。エンコーダが1段進むごとに縦横を半分・チャネルを倍にしていたので、ちょうど逆向きの操作です。
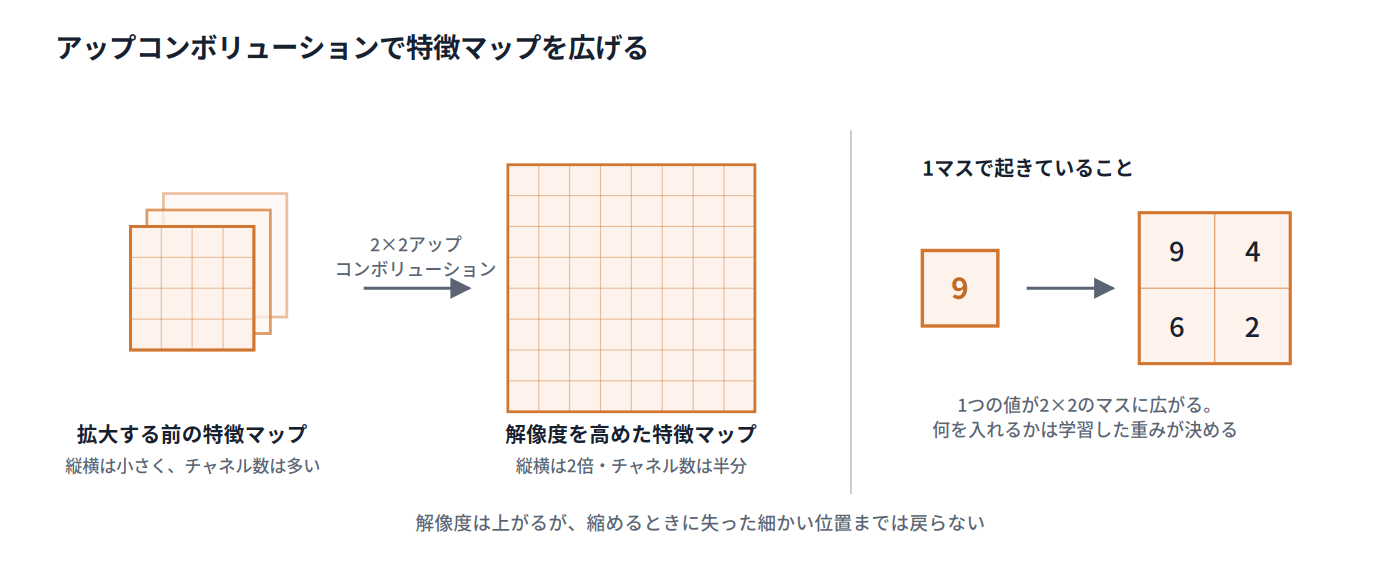
図:アップコンボリューションで特徴マップが拡大される様子
ただし、拡大しただけでは失われた位置の情報は戻ってきません。縮める過程で「どこにあったか」を捨てているため、輪郭がぼやけやすくなります。この問題を解決するのがスキップ接続です。
スキップ接続は、エンコーダで縮める前の特徴マップをコピーし、デコーダ側の同じ段階へ渡して連結する仕組みです。U-Netの論文の構造図には「copy and crop」と書かれており、サイズが合わない分は切り取ってから連結します。
デコーダ側の特徴マップは、一度縮小してから拡大したもので、「何が写っているか」という情報を持つ一方、輪郭の位置は曖昧です。そこで縮小前の細かな位置情報が残るエンコーダ側の特徴マップを組み合わせます。これにより、「何が写っているか」と「どこにあるか」の両方を利用できるようになります。
U-Netが細い血管や細胞の境界のような細かい対象を扱えるのは、この仕組みによるものです。
デコーダで解像度を高めたあと、最後に1×1の畳み込みを適用し、各画素の値をクラスごとのスコアへ変換します。たとえば2クラスであれば、各画素について「背景である度合い」と「対象である度合い」を算出し、より大きな値を持つクラスがその画素のラベルとなります。
U-Netは、全部で23の畳み込み層から構成されています。収縮側と拡大側がおおむね対称に配置されているため、処理の流れを構造図から追いやすい点も特徴です。
なおU-Netの論文の構造図では、入力が572×572、出力が388×388と、出力のほうが小さくなっています。これは畳み込みの際に画像の縁を埋める処理(パディング)を行っていないためで、畳み込みを通すたびに周囲が少しずつ削られていくからです。実装によってはパディングを行い、入力と出力のサイズを揃える形も使われます。
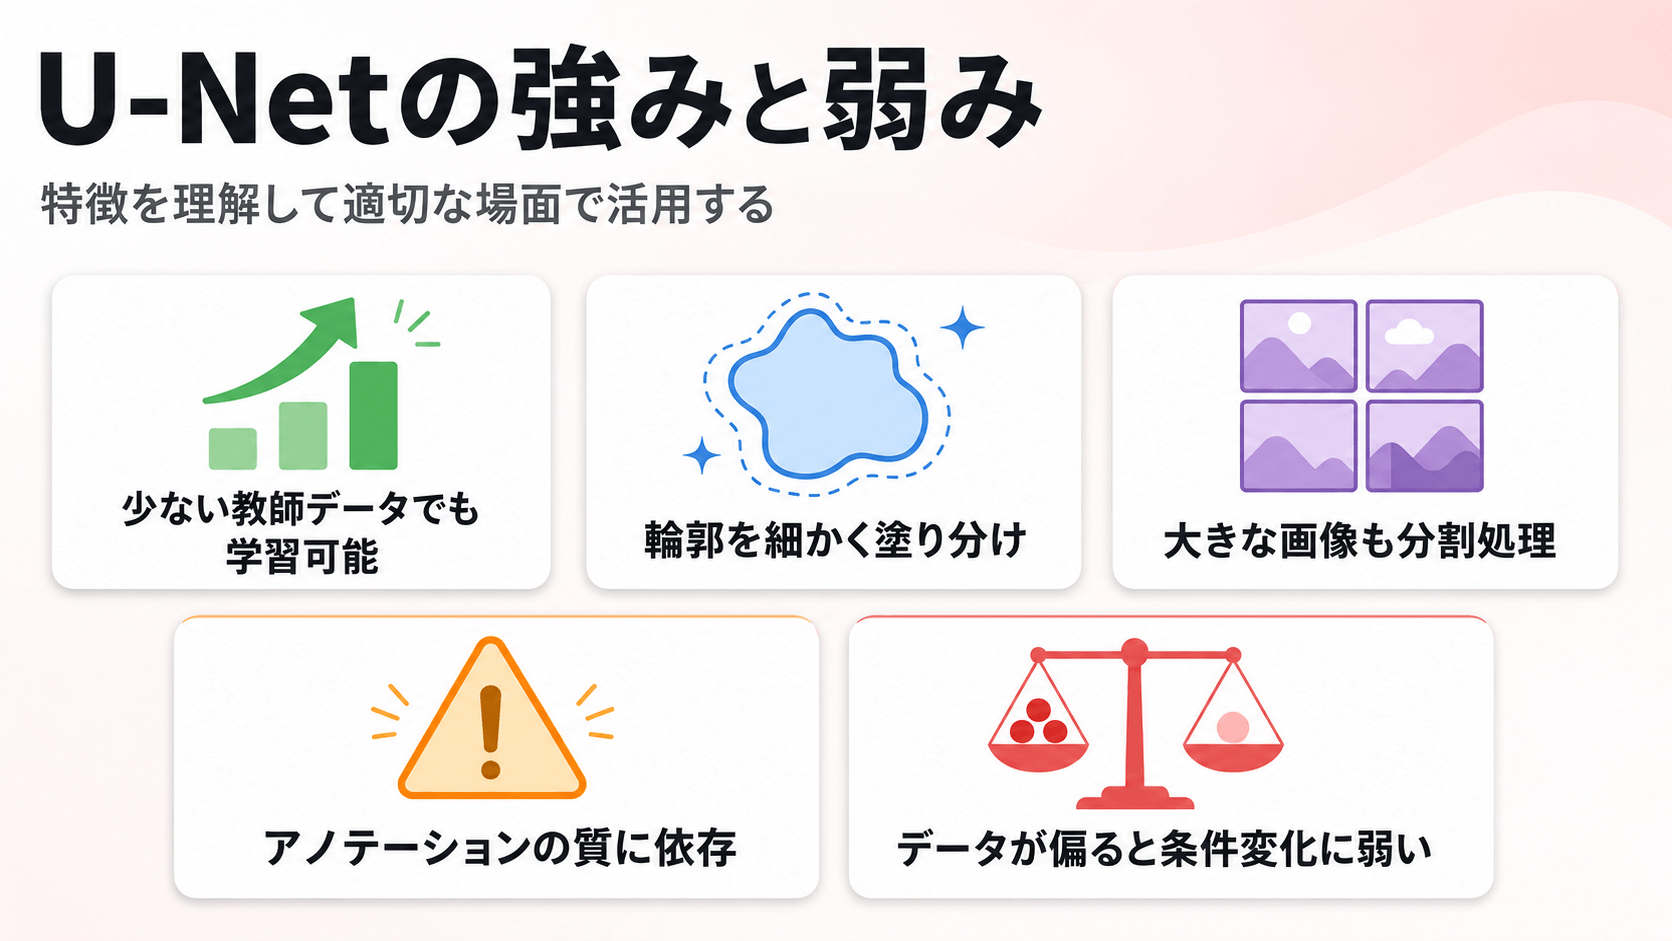
U-Netには、少ない教師データを活用しやすいことや、細かな位置情報を利用できるという強みがあります。一方、セグメンテーション用の教師データを作る負担が大きく、学習データの品質や偏りによって精度が左右される点には注意が必要です。
U-Netは、限られた教師データを効率よく活用できるよう工夫されたモデルです。論文では、弾性変形などのデータ拡張を積極的に用いることで、少数の学習画像から高い性能を得られることが示されました。
U-Netを扱った論文では、学習用の画像に弾性変形(elastic deformation)をかけて水増しする方法が有効だったと述べられています。細胞や臓器のように、個体によって形が変わる対象では、変形させた画像をあらかじめ学習させておくことで、実際に起こりうる形のばらつきに対応できるようになります。
スキップ接続によって縮小前の位置情報がデコーダ側に届くため、細い線状の対象や、入り組んだ境界を持つ対象でも輪郭に沿って塗り分けられます。
面積や長さを数値として取り出したい業務では、切り出しの精度がそのまま測定結果に影響します。ひび割れの幅を測る、病変の範囲を面積で比べるといった用途では、対象を枠で囲むだけの物体検出は代わりになりません。
U-Netは全結合層を持たないため、入力を1つの固定サイズだけに限定する必要がありません。
論文には画像の縁の部分を予測する際に足りない範囲を鏡像で補う「overlap-tile戦略」が示されており、メモリに載りきらない大きさの画像でも分割して扱えます。処理速度については「512×512の画像のセグメンテーションが1秒未満で終わる」という記述がありますが、これは2015年時点のGPUでの数値です。
画素単位の教師データは、画像の各画素に正解ラベルを付けるアノテーションによって作成します。物体検出で四角い枠を付ける作業よりも1枚あたりの負担が大きく、境界の判断が難しい部分では作業者によるばらつきも生じます。
学習データの品質が低ければ、モデルの出力もその品質に引きずられます。U-Netを利用する場合はモデルを選ぶ段階と同じくらい、アノテーションの設計と品質管理が重要です。
U-Netは少ない枚数で学習できる反面、その枚数が特定の条件に偏っていると、条件が変わったときに精度が落ちます。同じ撮影装置・同じ照明で撮った画像だけを学習させた場合、装置や照明が変わった現場では期待した結果が出ません。
対策方法としては、データ拡張の設計を詰めることや、学習に使う画像の撮影条件を意図的に散らすことが挙げられます。
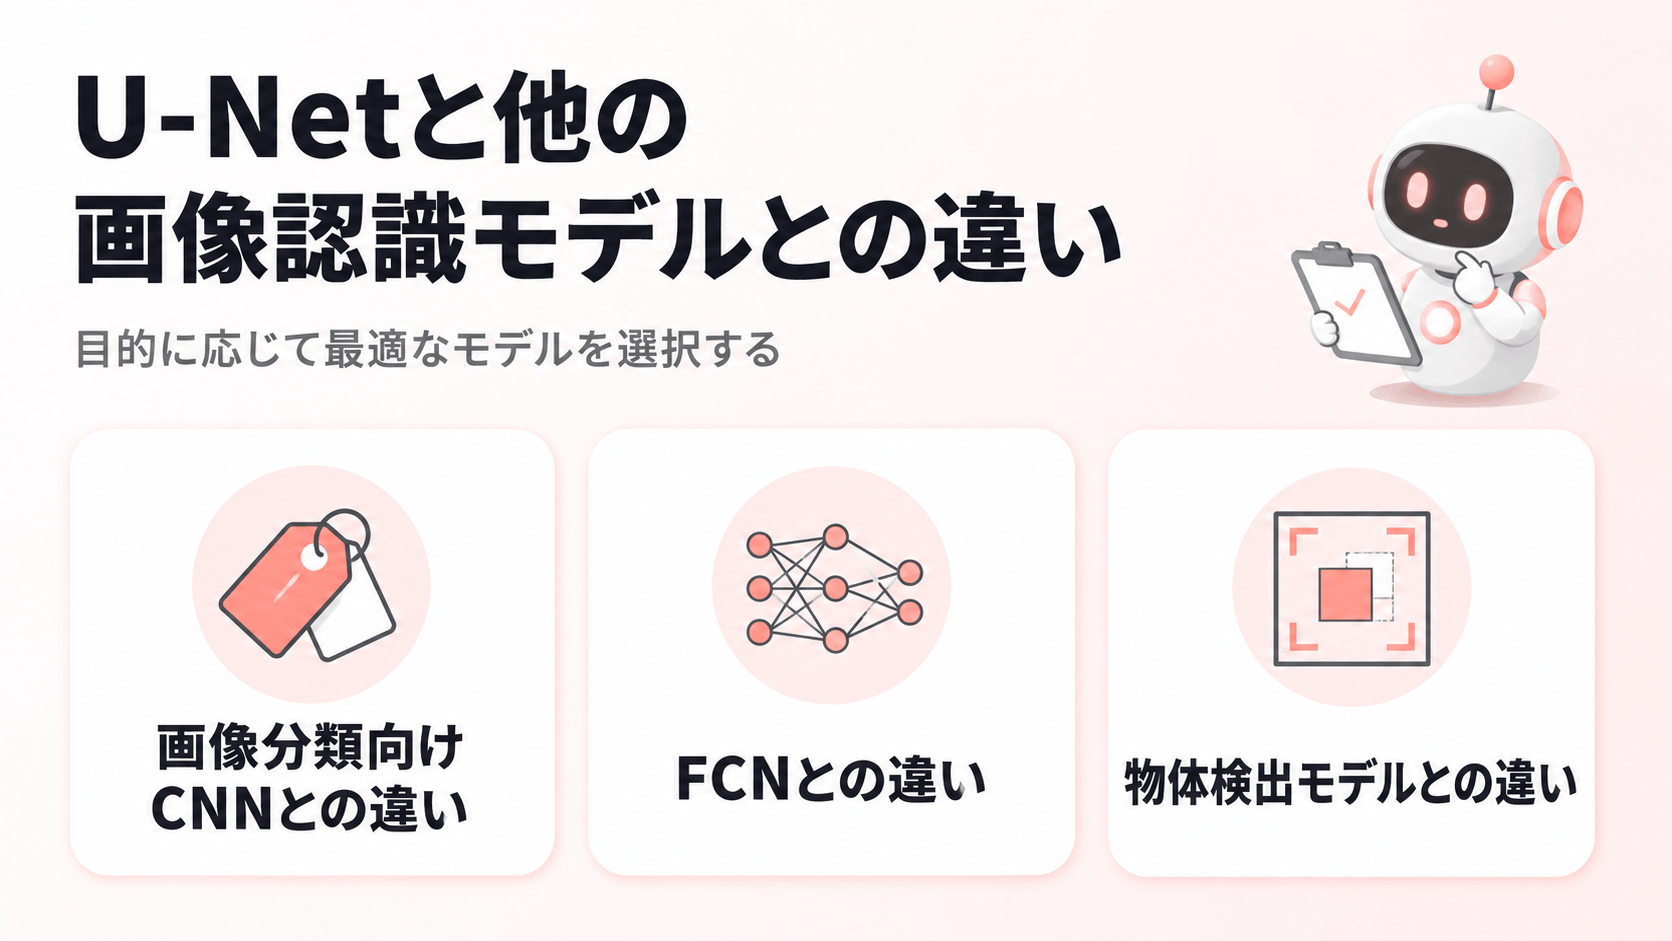
U-Netを他のモデルと比べる際に誤解されやすいのが、「どれか1つを選ぶものだ」という捉え方です。U-Net自体もCNNの一種であり、どちらが優れているという比較にはなりません。違いが出るのは、何を出力するために構造をどう組んでいるかです。
前提として、U-NetもCNN(畳み込みニューラルネットワーク)の一種であり、畳み込みやプーリングによって特徴を抽出する仕組みは共通しています。
大きく異なるのは最終的に何を出力するかという点です。画像分類向けのCNNは、畳み込みで特徴を抽出したあと全結合層などを通し、画像全体に対して1つのラベルを出力します。このとき、対象がどこにあったかという位置の情報はほとんど残りません。対してU-Netは全結合層を持たず、縮めた特徴マップの解像度をデコーダで段階的に高め、画素ごとのラベルを出力します。
CNNの基本的な仕組みは画像認識でよく聞く「CNN」とは?仕組みや特徴を1から解説で解説しています。
FCN(Fully Convolutional Network)は、全結合層を畳み込み層に置き換えることでセグメンテーションを可能にしたモデルです。2014年に公開され、U-Netもその考え方を受け継いでいます。
差が出るのは、エンコーダ側の情報をデコーダ側へ渡す方法です。FCN-16sやFCN-8sでは、浅い層から得たクラスごとの予測と、深い層からアップサンプリングした予測を加算します。
一方、U-Netではエンコーダ側の特徴マップそのものをデコーダ側へ渡し、チャネル方向に連結します。足し合わせると2つの情報が混ざってしまいますが、連結すれば両方がそのまま残るため、後続の畳み込みがどちらをどう使うかを学習できます。拡大側にも多くの特徴チャネルを持たせ、高解像度の特徴と組み合わせている点も、U-Netが輪郭を細かく再現できる理由です。
YOLOやFaster R-CNNといった物体検出モデルは、対象を四角い枠で囲んで位置と種類を返します。個数を数える、対象のおおよその位置を掴むといった用途に向いています。
一方で、枠の中には対象以外の背景も含まれます。輪郭に沿った面積が必要な場合や、道路や田畑のように枠で囲む形になじまない対象を扱う場合は、セグメンテーションが向く場面です。
物体検出の仕組みについてはディープラーニングを用いた画像の物体検出とは?モデルや応用例を紹介で解説しています。
U-Netの発表後、その構造を一部だけ差し替えた改良モデルが数多く提案されています。いずれもU字型とスキップ接続という基本の形は保っているため、元のU-Netから何を変えたのかという差分だけを押さえれば違いが掴めます。
U-Net++は、スキップ接続を入れ子状に増やしたモデルです(2018年、Zhouら)。
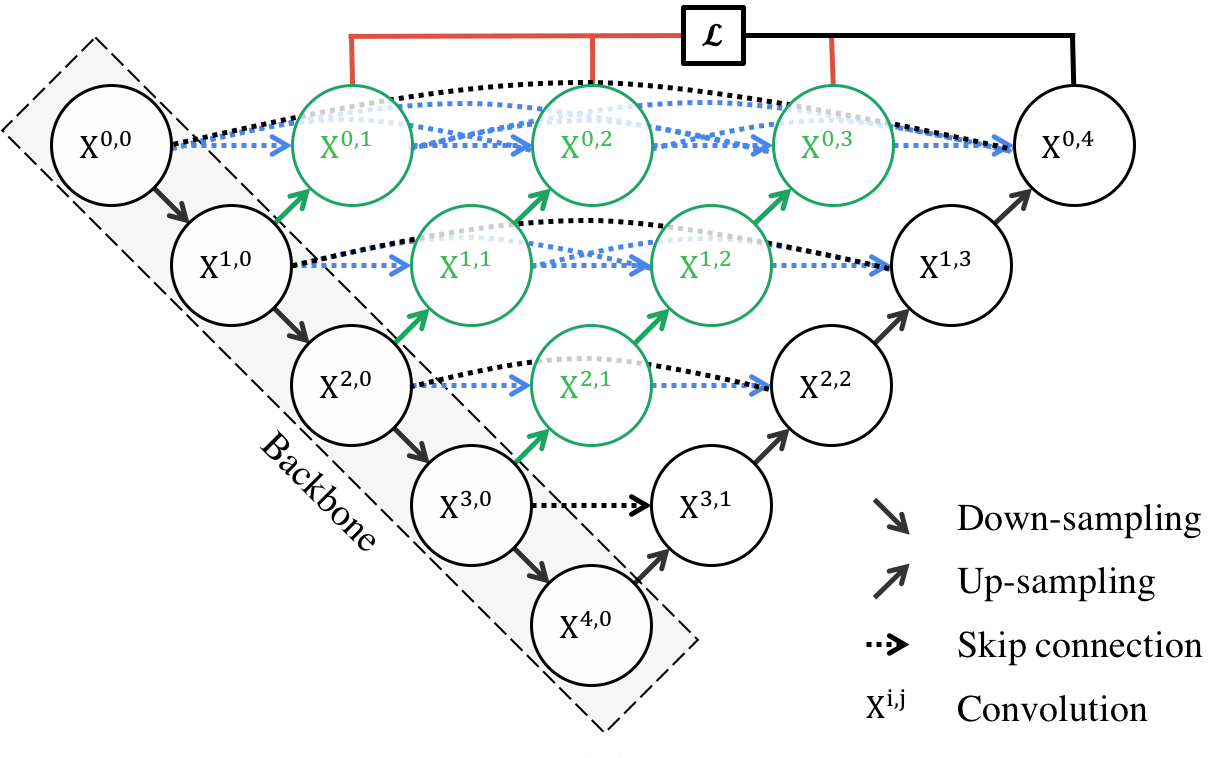
図:U-Net++の構造
出典:Zongwei Zhou, Md Mahfuzur Rahman Siddiquee, Nima Tajbakhsh, Jianming Liang「UNet++: A Nested U-Net Architecture for Medical Image Segmentation」(2018) arXiv:1807.10165
元のU-Netでは、エンコーダ側の特徴とデコーダ側の特徴が直接連結される仕組みです。ただし両者は通ってきた処理の回数が違うため、性質にずれが生じています。U-Net++は両者の間に畳み込みブロックを段階的に挟み、このずれを小さくしてから連結します。
3D U-Netは、U-Netで使われる2次元の処理を3次元の処理へ拡張したモデルです(2016年、Çiçekら)。
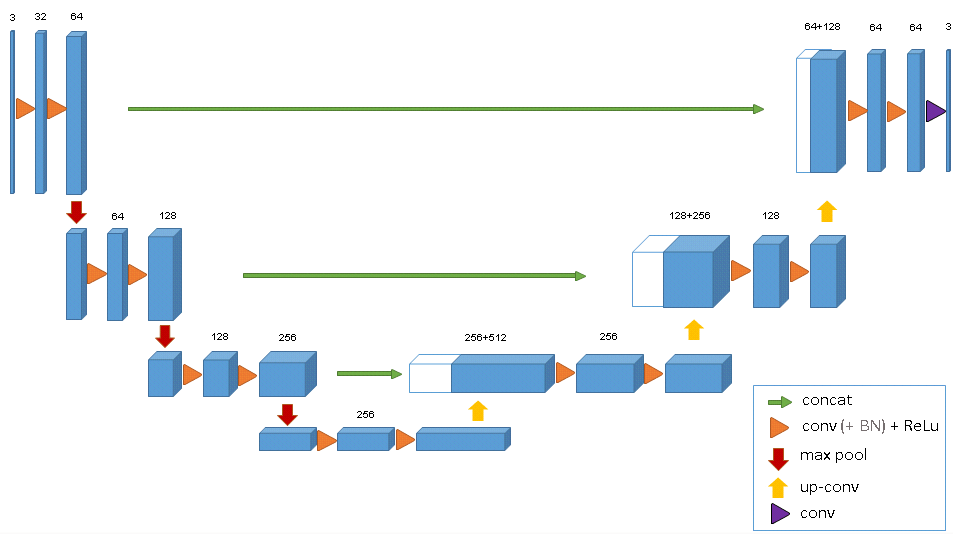
図:3D U-Netの構造
出典:Özgün Çiçek, Ahmed Abdulkadir, Soeren S. Lienkamp, Thomas Brox, Olaf Ronneberger「3D U-Net: Learning Dense Volumetric Segmentation from Sparse Annotation」(2016) arXiv:1606.06650
CTやMRIのように断面の画像が連続して得られるデータでは、1枚ずつ処理すると断面をまたいだつながりを扱えません。3D U-Netは複数の断面をまとめて入力とすることで、断面をまたいだ立体的な形を捉えます。そのため、臓器や腫瘍の領域を3次元で抽出し、体積を求める用途などに利用されています。
R2U-Netは、再帰的な畳み込みと残差接続を組み合わせたモデルです(2018年、Alomら)。残差ユニットによって深いネットワークを学習しやすくし、著者らは同程度のパラメータ数でU-Netなどを上回る性能を報告しました。残差接続の仕組みについては、ResNetとは?特徴や構造・メリット・デメリットをわかりやすく解説で詳しく解説しています。
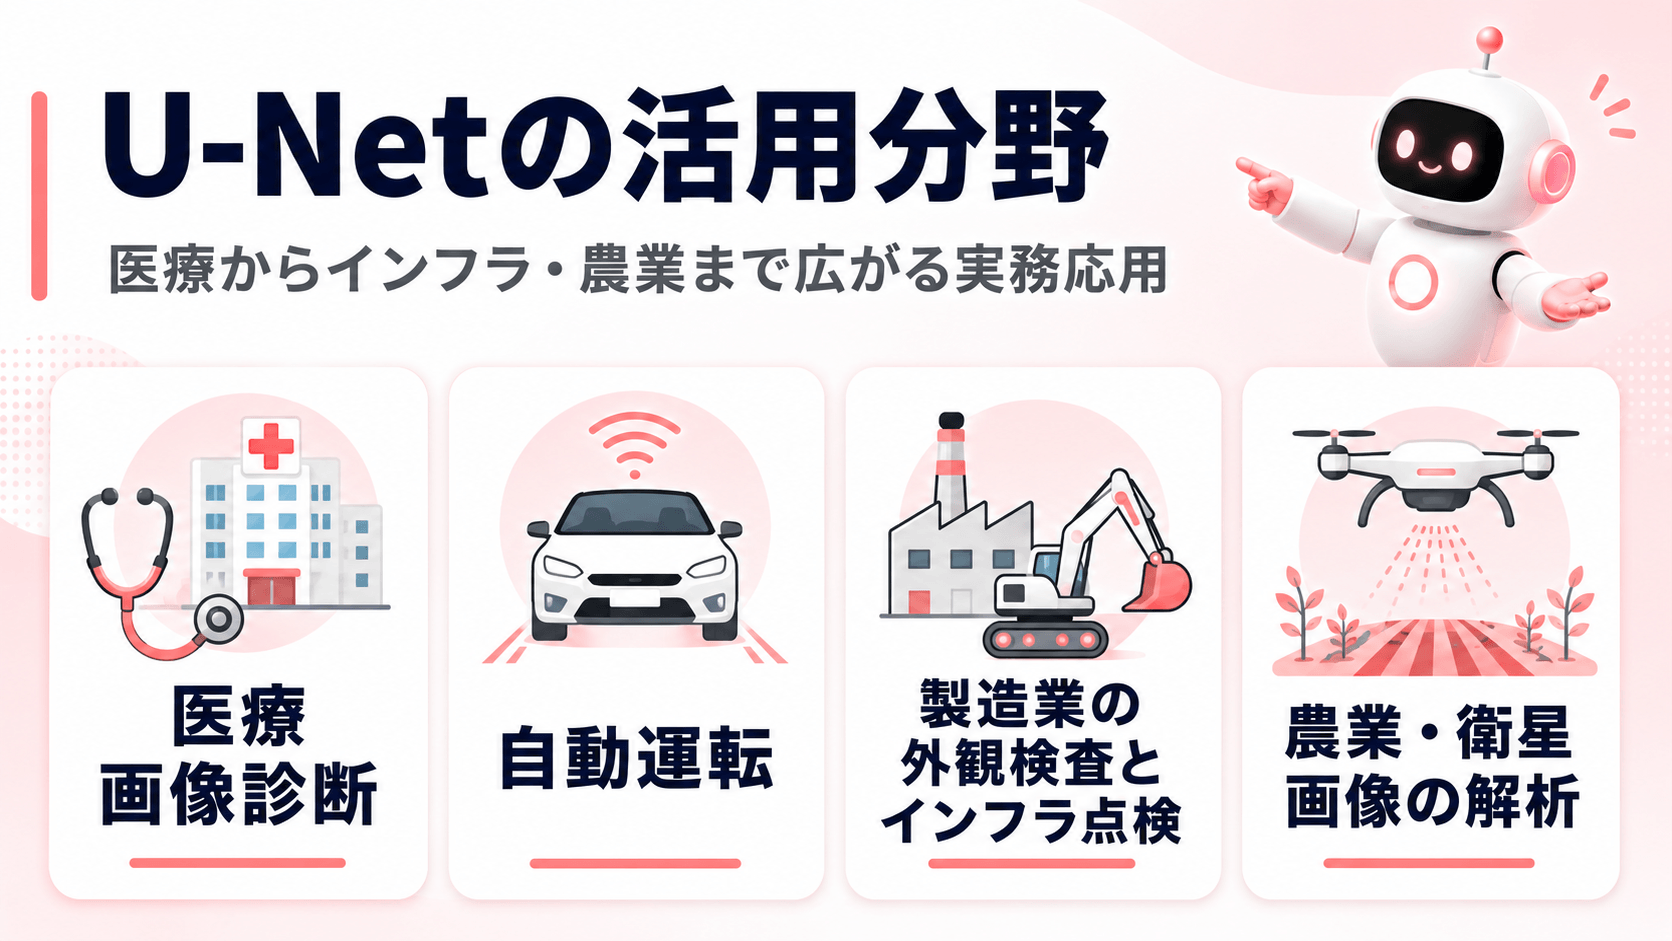
U-Netやその派生モデルが適しているのは、対象と背景を輪郭の単位で分けたい業務です。個数やおおよその位置が目的なら物体検出が候補になりますが、面積・体積・形状そのものが判断材料になる場面では、画素ごとの塗り分けが必要です。
U-Netがもともと想定していた分野が医療画像です。CT・MRI・内視鏡画像などから、臓器や病変の領域を抽出し、腫瘍の体積測定や、手術計画のための臓器の輪郭抽出などに応用されています。
医療画像は1画素ずつの正解を付けられる人が限られるため、少ない教師データで学習できるU-Netの特性が合っています。ただし、こうしたモデルが担うのは診断の支援であり、最終的な判断を行うのは医師です。
車載カメラの映像から、走行可能な路面・白線・歩道・他の車両などを画素単位で分けます。物体検出であれば車両や歩行者を枠で囲めますが、路面のように広がりを持つ対象は枠になじみません。どこまでが走れる範囲かを判断するには、領域として切り出す処理が求められます。
製品表面の傷や汚れ、コンクリート構造物のひび割れを領域として抽出する用途です。この分野で塗り分けが必要になるのは、検出したあとに寸法を求めるためです。傷の長さ・面積、ひび割れの幅といった数値が、補修の要否や優先順位を判断する材料になります。
ドローンや衛星から撮影した画像を使い、作物と雑草を分ける、圃場の区画を抽出する、災害時の浸水範囲を把握するといった処理に使われています。上空から撮った画像は対象が広い面として写るため、輪郭に沿った塗り分けと相性がよい領域です。
業界ごとの画像認識AIの導入例は【最新】画像認識AIの導入活用事例10選!各業界企業の課題と導入効果まとめで紹介しています。
U-Netは、画像を画素単位で塗り分けるセマンティックセグメンテーション向けのモデルです。入力された画像を段階的に縮めて「何が写っているか」を掴み、そのあと段階的に広げて画素ごとのラベルを組み立てます。縮める前の特徴を広げる側へ直接渡すスキップ接続があるため、輪郭の位置を保ったまま細かく塗り分けられます。
もともとは教師データを大量に用意できない医用画像のために作られたモデルで、原論文では、データ拡張を活用することで少数の学習画像から学習できることが示されています。その特性から、医療画像診断のほか、自動運転・外観検査・農業など、面積や形状そのものが判断材料になる領域が主な使いどころです。導入を検討する際は、モデルの選定と同じくらい、画素単位の教師データをどう用意するかが結果を左右します。
アイスマイリーでは、生成AI のサービス比較と企業一覧(画像生成AI)を無料配布しています。課題や目的に応じたサービスを比較検討できますので、ぜひこの機会にお問い合わせください。
U-NetはCNNの一種です。畳み込みで特徴を抽出する点は共通していて、違いが出るのは出力の部分です。画像分類向けのCNNが画像全体に1つのラベルを返すのに対し、U-Netは画素ごとにラベルを返す点が違います。そのためU-Netには、縮めた特徴の解像度を高めるデコーダと、位置の情報を渡すスキップ接続が備わっています。
エンコーダで特徴マップを縮小し、デコーダで拡大する構造を図にするとU字型に見えることが名前の由来です。
少ない教師データでも学習できる点と、輪郭の位置を保ったまま画素単位で塗り分けられる点です。全結合層を持たないため入力サイズが固定されず、大きな画像を分割して処理できることも扱いやすさにつながっています。
U字型の構造を受け継いだ派生モデルであり、同じものではありません。画像生成に使われる拡散モデルでは、ノイズだらけの状態から少しずつノイズを取り除く処理が繰り返されます。このノイズを推定する部分に、U-Netをもとにしたネットワークが使われてきました。入力と出力の空間的な大きさを保ちながら処理する必要があり、U字型の構造が適していたためです。
業務の課題解決に繋がる最新DX・情報をお届けいたします。
メールマガジンの配信をご希望の方は、下記フォームよりご登録ください。登録無料です。


FOLLOW US
SNSをフォローして、最新情報をチェックできます!


AI製品・ソリューションの掲載を
希望される企業様はこちら