


生成AI
最終更新日:2026/10/28
「AIを業務に組み込みたいけれど、高性能なモデルほど料金が高くて手が出ない……」このような悩みを抱えていませんか?
2026年9月2日(米国時間)、Googleは主力AIモデルの最新版「Gemini 3.8 Flash」を発表しました。前モデルの「Gemini 3.7 Flash」からわずか約3週間という異例のペースでの更新ですが、ソフトウェア開発やAIエージェント(人の指示を受けて自律的にタスクを進めるAI)の性能を大きく伸ばしながら、速度と価格は前モデルと同水準に据え置かれている点が注目を集めています。
最大の特徴は、処理速度の速さと高いコストパフォーマンスです。API料金は100万トークンあたり入力0.75ドル・出力3.75ドルと、フラッグシップ級のモデルと比べて低く抑えられています。さらに、2026年9月23日(米国時間)には、音声生成モデルの「Gemini 3.8 Flash TTS」も公開され、テキストだけでなく音声分野への活用も広がりつつあります。
この記事では、Gemini 3.8 Flashの特徴や従来モデルとの違い、活用シーン、利用方法、使いこなすためのプロンプトのコツまでを解説します。この記事を読めば、Gemini 3.8 Flashのコスト面・速度面の強みが理解でき、自社ビジネスや個人開発に最も安くスピーディに導入するための最短ルートがわかります。
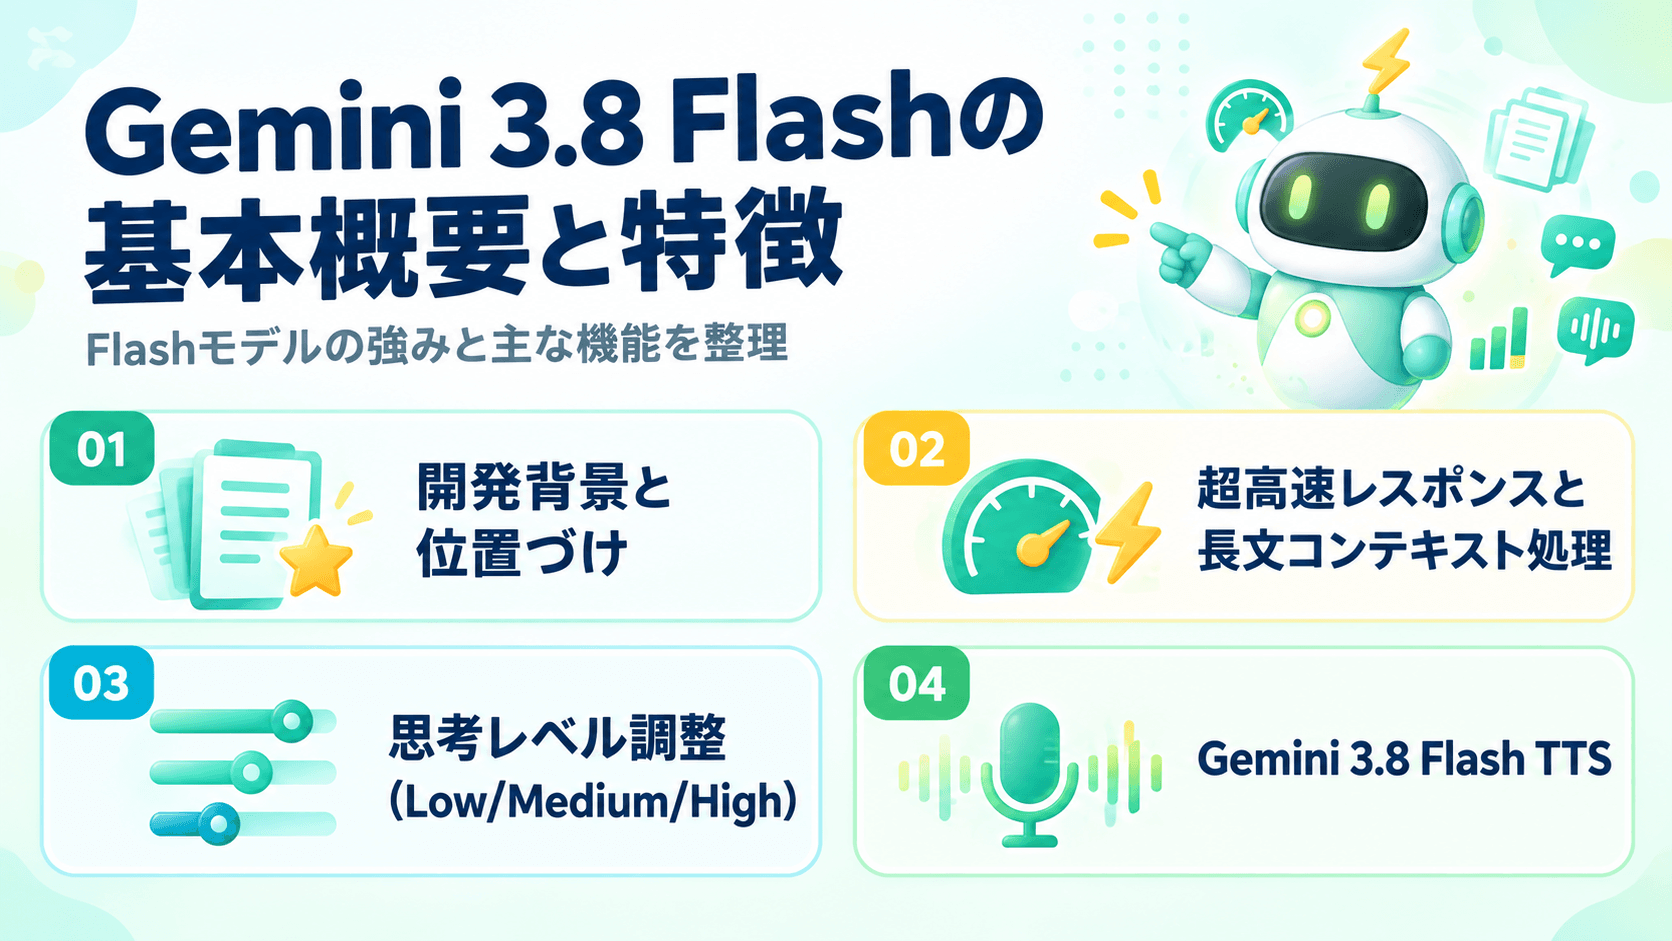
まずは、Gemini 3.8 Flashがどのようなモデルなのか、基本的な特徴から整理していきましょう。
Gemini 3.8 Flashは、Google(Google DeepMind)が2026年9月2日(米国時間)に発表した、Geminiファミリーの主力モデルです。「Flash」は、Geminiシリーズの中でも速さと低コストを重視したシリーズで、日常業務を支える”ワークホース(働き者)”のような存在として位置づけられています。
Googleは3.8 Flashを、長期的なソフトウェアエンジニアリング、自律型エージェント、複雑なエンタープライズ(企業向け)ワークフローに向けて設計された「Flashモデルとして最も高性能なモデル」と説明しています。
Flash系モデルは更新のペースが非常に速く、2026年7月に「Gemini 3.6 Flash」、8月に「Gemini 3.7 Flash」、そして9月に3.8 Flashと、短い間隔で進化を続けてきました。なぜここまで頻繁に更新されるのでしょうか? 背景には、AIエージェントの普及により「安く・速く・賢いモデル」への需要が急速に高まっていることがあります。
性能面では、Googleが公表している主なベンチマーク(AIの能力を測る共通の試験)で、3.7 Flashからの向上が確認されています。
| ベンチマーク | Gemini 3.7 Flash | Gemini 3.8 Flash | 測定内容 |
|---|---|---|---|
| DeepSWE v1.1 | 65.3% | 73.7% | 長期的なソフトウェア開発課題を自律的に解決する能力 |
| HLE-Verified | 53.6% | 54.9% | 理系・文系・専門分野にまたがる多段階の推論力 |
※数値はGoogleの発表および国内報道による。
DeepSWE v1.1では、より大規模なフロンティアモデル(各社の最上位クラスのモデル)の多くを上回るとGoogleは説明しています。さらに、金融分野の「Vals Finance Agent V2」や法務分野の「Legal Agent Benchmark」でも、3.7 Flashや他のフロンティアモデルを上回る結果が示されています。
また、3.8 Flashは悪意ある指示を紛れ込ませる攻撃(プロンプトインジェクション)への耐性も大きく向上したと、第三者機関Gray Swanの評価をもとに報告されています。外部のWebページやメールを読み込ませる業務では、安心材料の一つになるでしょう。
なお、同時に発表された「Gemini 3.8 Flash Cyber」は、脆弱性の発見やパッチ適用に特化したサイバーセキュリティ向けモデルです。こちらは一般公開されておらず、新設の「Fairwind Program」を通じて、審査を受けた防御担当者にのみ提供されます。一般のビジネス利用で選ぶのは、通常版のGemini 3.8 Flashです。
Flashモデルの最大の持ち味は、応答の速さです。Googleは3.8 Flashについて、3.7 Flashと同等のスピードと低コストを維持していると説明しています。第三者による計測では、生成速度が毎秒300トークンを超えたとの報告もあり、チャットボットのようなリアルタイム性が求められる場面でも使いやすいモデルです。
ただし、ここで一つ注意点があります。3.8 Flashは「より熱心に処理に取り組む」という設計思想で作られており、複雑なタスクでは追加の推論ステップを踏んだり、ツールを繰り返し呼び出したりします。そのため、思考の深さの設定(後述)を高くすると、トークン消費が増え、応答に時間がかかる場合があります。
速度とコストを最優先したい用途では、設定を調整するか、引き続き完全にサポートされる3.7 Flashを使い続けるという選択肢も用意されています。「速さ」はモデルだけでなく、設定次第で引き出せるものだと覚えておきましょう。
Gemini 3.8 Flashは、100万トークン(1,048,576トークン)のコンテキストウィンドウに対応しています。コンテキストウィンドウとは、AIが一度に読み込んで扱える情報量のことです。最大出力は約6.4万トークンで、長い文書の要約やコード全体の分析にも対応できます。
テキストだけでなく画像などのマルチモーダル入力にも対応しており、コード実行、関数呼び出し(AIが外部のツールやAPIを呼び出す機能)、Google検索によるグラウンディング(最新情報を検索して回答の根拠にする機能)など、エージェント開発に欠かせない機能もそろっています。
たとえば、数百ページにおよぶ契約書や議事録、大規模なコードベースを丸ごと読み込ませて、横断的に分析させるといった使い方が可能です。
3.8 Flashでは、モデルの思考の深さ(思考レベル)を3段階で調整できます。レイテンシ(応答までの待ち時間)と回答の質のバランスを、用途に合わせてコントロールするための機能です。
| 思考レベル | 特徴 | 向いている用途 |
|---|---|---|
| Low | 応答が最も速く、トークン消費も少ない | インシデント対応、リアルタイムチャット、下書き作成、高速なデータ分析 |
| Medium(デフォルト) | ほとんどのタスクに適した品質。初回の精度が高い | 複雑なコード生成、エージェント用途 |
| High | 推論力とツール活用力を最大限に引き出す | 深い推論、数学、難易度の高い多段階タスク |
ポイント:Gemini 3.8 Flashでは「minimal(最小)」の思考レベルはサポートされておらず、指定するとエラーになります。 以前のモデルからAPIを移行する場合は、設定を見直す必要があります。
2026年9月23日(米国時間)、Googleはテキストから音声を生成するTTS(Text-to-Speech)モデルとして、「Gemini 3.8 Flash TTS」と「Gemini 3.8 Flash-Lite TTS」の2モデルを公開しました。いずれも一般提供(GA)で、従来の「Gemini 3.1 Flash TTS」プレビュー版に代わるモデルです。
2つのモデルの違いは次のとおりです。
| 項目 | Gemini 3.8 Flash TTS | Gemini 3.8 Flash-Lite TTS |
|---|---|---|
| 主な強み | 音声の忠実度、演技のニュアンス、方言への対応 | 高スループット、低遅延、低コスト |
| 対応言語 | 130言語 | 101言語 |
| 向いている用途 | オーディオブック、スタジオ品質のナレーション、複数話者の会話、ゲーム、ポッドキャスト | 大量の音声生成、リアルタイム音声エージェント、読み上げ機能、日常的な単一話者の音声 |
Flash TTSは、感情表現や自然なリズム、地域ごとのアクセントの再現に優れており、「(笑い)」「(ため息)」「(短い間)」といった指示タグで、笑い声やため息、間の取り方まで細かく制御できます。長い会話や数分間のナレーションでも、声の一貫性が保たれる点も特徴です。
2,000以上の事前構築済みボイスに加えて、オリジナルの声を設計する「音声デザイン」や、声を複製する機能にも対応しています。2つのモデルは同じAPIの構造を共有しているため、パラメータを1つ変えるだけで切り替えられます。
料金は出力音声100万トークンあたり、Flash TTSが9ドル、Flash-Lite TTSが6ドルです。この価格は2026年12月31日までの導入価格で、2027年1月1日からは倍額(18ドル・12ドル)になるため、長期の運用では注意が必要です。
次に、Gemini 3.8 Flashが従来モデルとどう違うのかを見ていきましょう。
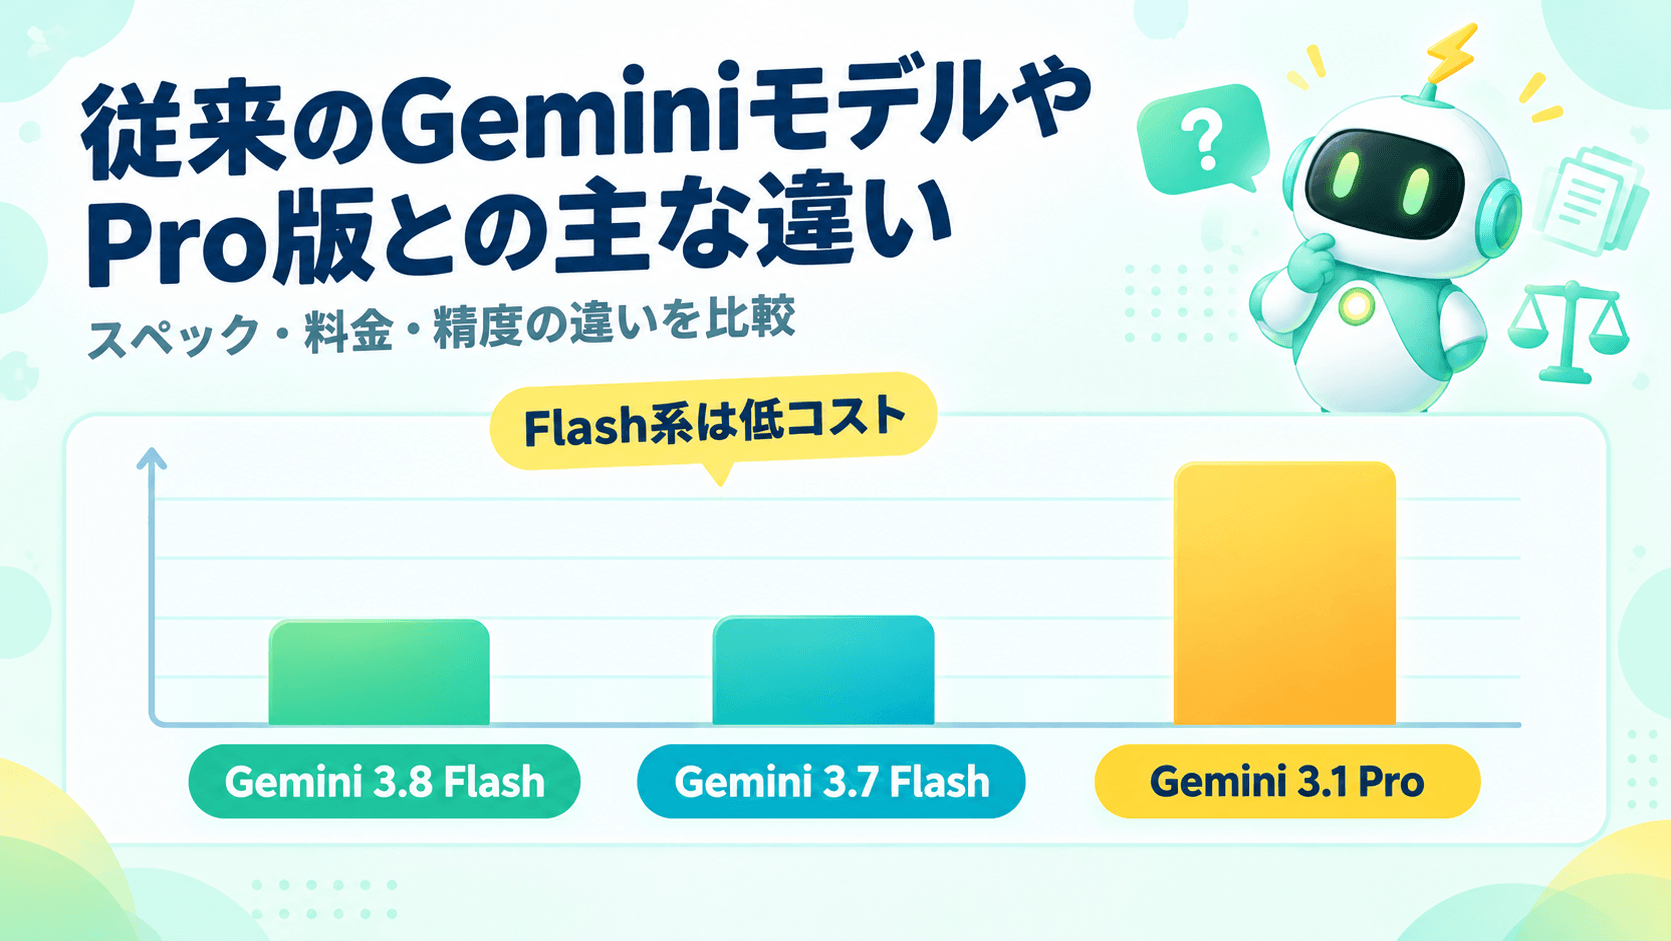
比較に入る前に、一点補足があります。2026年10月時点で、「Gemini 3.8 Pro」というモデルは提供されていません。Pro系の最新の提供モデルは、2026年2月に登場した「Gemini 3.1 Pro」(APIではプレビュー扱い)です。そこで、ここでは3.8 Flash・3.7 Flash・3.1 Proの3モデルを比較します。
| 項目 | Gemini 3.8 Flash | Gemini 3.7 Flash | Gemini 3.1 Pro(プレビュー) |
|---|---|---|---|
| 発表時期 | 2026年9月2日 | 2026年8月13日 | 2026年2月 |
| 位置づけ | Flash系の最新主力モデル | 前世代のFlash主力モデル | Pro系の提供モデル |
| コンテキストウィンドウ | 100万トークン | 100万トークン | 100万トークン |
| 最大出力 | 約6.4万トークン | 約6.4万トークン | 約6.5万トークン |
| 思考レベル | Low / Medium / High(minimal非対応) | Low / Medium / High(minimal非対応) | ― |
| API料金(導入価格・100万トークンあたり) | 入力$0.75/出力$3.75 | 入力$0.75/出力$3.75 | 入力$2.00/出力$12.00 |
| 2027年1月以降のAPI料金 | 入力$1.50/出力$7.50 | 入力$1.50/出力$7.50 | ― |
| DeepSWE v1.1 | 73.7% | 65.3% | ― |
| HLE-Verified | 54.9% | 53.6% | ― |
※「―」は、本記事の執筆時点で比較できる公式数値を確認できていない項目です。3.1 Proの料金は20万トークン以下の入力の場合です。Flash系の導入価格は2026年12月31日までの適用です。
表のとおり、3.8 Flashと3.7 Flashは、コンテキストウィンドウや料金などの仕様がほぼ同じです。違いは主に「中身の賢さ」にあり、コーディングやエージェント、専門分野での推論で差がついています。
なお、2026年9月30日には、Gemini 4世代の最初のモデル「Gemini 4 Argon」が発表されました。ただし、2026年10月上旬時点では、サイバー防御を担う審査済みのパートナーを中心とした限定提供で、一般の開発者や企業がすぐに使える状態ではありません。現時点で実際に導入できるのは、3.8 Flashなどの既存モデルです。
3つの観点で、違いを整理してみましょう。
処理速度:Googleは、3.8 Flashの速度は3.7 Flashと同等と説明しています。Flash系は、そもそも低遅延を重視した設計のため、リアルタイムの応答が求められる場面に向いています。
コスト:3.8 Flashの導入価格は、3.1 Proと比べて入力で約4割弱、出力で約3分の1です。たとえば、1回あたり入力10万トークン・出力1万トークンの処理を1,000回行う場合、3.8 Flashなら約112ドル(導入価格)、3.1 Proなら約320ドルが目安になります。2027年1月以降の標準価格でも、3.8 Flashは約225ドルです。ただし、思考に使われたトークンも出力として課金されるため、思考レベルを高くすると実際の請求額は増える点に注意しましょう。
応答精度:3.7 Flashからは、DeepSWE v1.1で約8ポイント向上しています。長時間のコーディングや、金融・法務といった専門性の高い業務で、3.7 Flashより高い精度が期待できます。一方で、日常的な処理では3.7 Flashとの差を感じにくい場面もあるでしょう。
「結局、どのモデルを選べばよいのか?」と迷う方のために、用途別の目安をまとめました。
| 用途 | おすすめのモデル |
|---|---|
| 複雑なコーディング・エージェント開発・専門分野の分析 | Gemini 3.8 Flash(Medium〜High) |
| チャットボットなどリアルタイム性重視の処理 | Gemini 3.8 Flash(Low) |
| トークン消費と費用を最優先する大量処理 | Gemini 3.7 Flash(または3.8 FlashのLow) |
| 長尺ナレーションや感情表現が必要な音声 | Gemini 3.8 Flash TTS |
| 大量の読み上げや音声エージェント | Gemini 3.8 Flash-Lite TTS |
| 最上位モデルの性能を待ちたい場合 | Gemini 4 Argonの提供拡大を確認 |
迷ったときは、まず3.8 Flash(Medium)で試し、精度が足りなければHigh、速度や費用を重視するならLowと調整していくのが、無駄のない進め方です。
ここからは、ビジネスの現場でどのように活用できるのかを具体的に見ていきます。
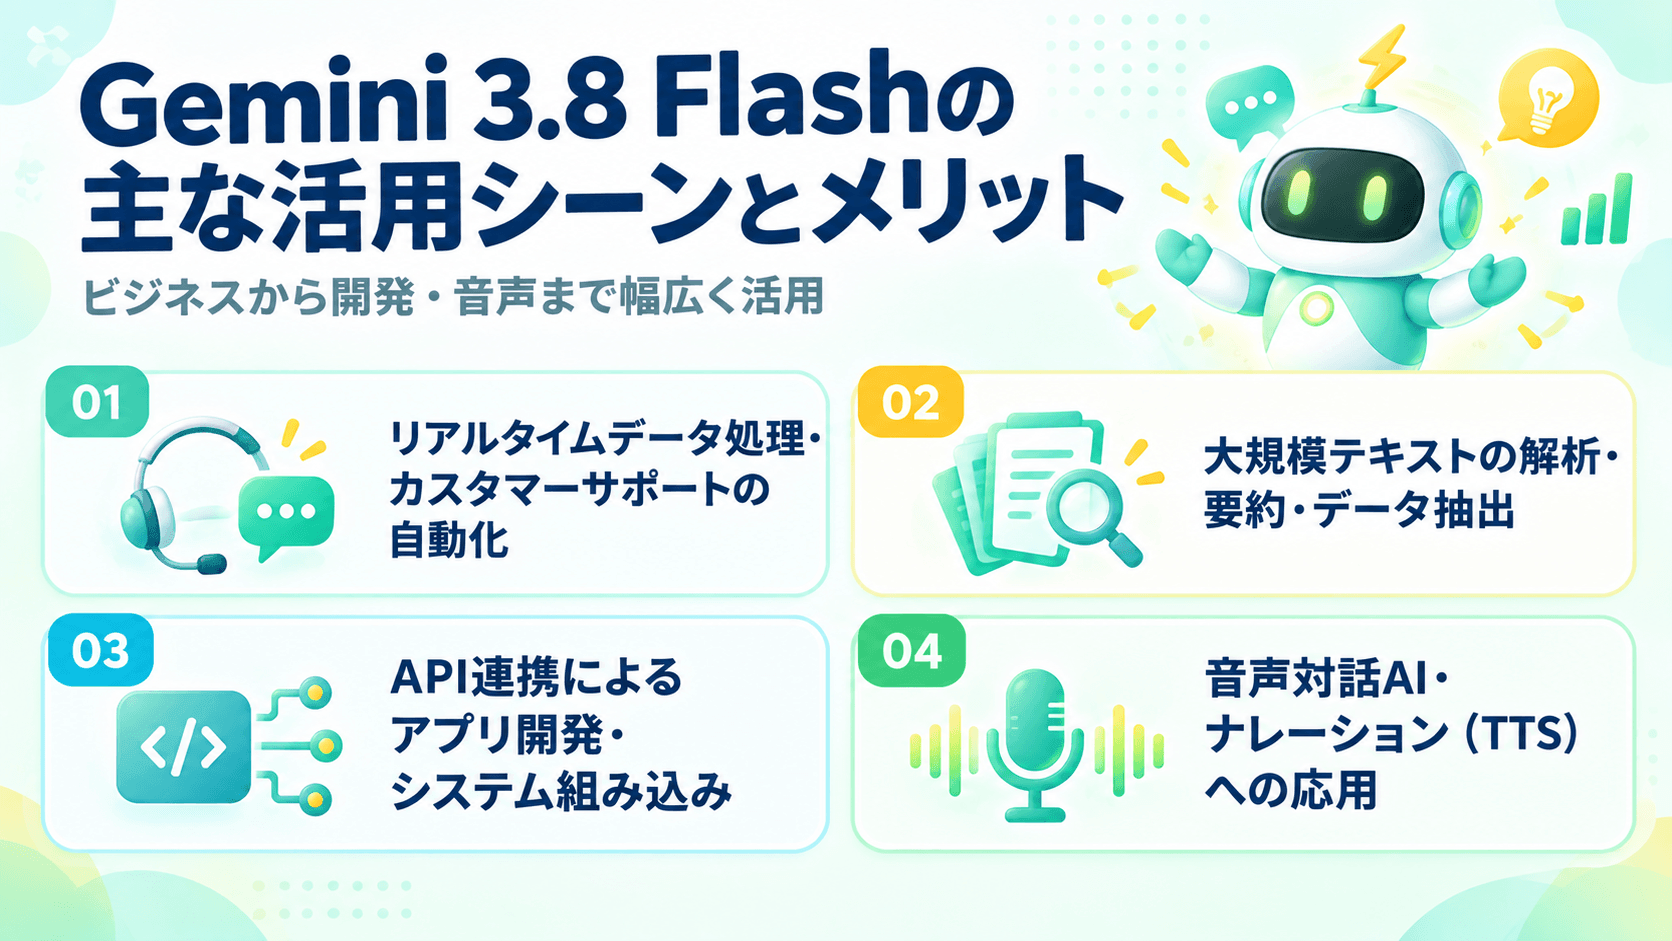
Low設定の3.8 Flashは、待ち時間が許されない場面で力を発揮します。たとえば、問い合わせへの一次回答の自動化や、社内ヘルプデスク、障害発生時のログの一次分析などです。思考レベルをLowにすれば、インシデント対応やリアルタイムチャットのようなレイテンシが重要なタスクにも対応できます。
低価格なため、問い合わせ件数が多い企業でも、費用を抑えて運用しやすいことがメリットです。ただし、顧客対応では誤った案内がトラブルにつながる可能性があるため、複雑な案件は人間の担当者へ引き継ぐ仕組みをあわせて用意しておきましょう。
100万トークンのコンテキストウィンドウを活かせば、大量の文書を一度に読み込んで処理できます。契約書のリスク確認、会議議事録の横断的な要約、大量のアンケート回答からの傾向抽出、請求書や報告書からの項目抽出などが代表的な使い方です。
金融や法務のようにミスが許されない分野でも、Vals Finance Agent V2やLegal Agent Benchmarkで高い成績が示されており、専門文書の処理に活用しやすいモデルです。ただし、これらのベンチマークは評価用のテストであり、自社の文書で同じ精度が出るとは限りません。導入前に自社のデータで検証することをおすすめします。
3.8 Flashは、開発者向けの環境がすでに整っています。Google AI StudioやAndroid Studioを通じたGemini APIでの開発のほか、エージェントファーストの開発環境「Google Antigravity」、UI生成ツール「Stitch」でも利用できます。Gemini APIの「Managed Agents」で使われるデフォルトのエージェント(Antigravityエージェント)や、Antigravity SDKも、標準で3.8 Flashを使う仕様に更新されました。
長時間のコーディングタスクや、複数のツールを使い分けて自律的に動くエージェントの開発に向いており、社内システムへの組み込みや新規サービスの開発で、費用を抑えながら高い性能を引き出せます。企業向けには「Gemini Enterprise」でも提供されています。
Gemini 3.8 Flash TTSの登場で、音声分野への応用も広がっています。たとえば次のような使い方が考えられます。
高品質な表現が必要な制作物にはFlash TTS、大量処理や低遅延が優先される音声エージェントにはFlash-Lite TTSと使い分けると効率的です。なお、日本語を含む各言語の聞こえ方には好みがあるため、本番利用の前に、自社の原稿で聞き比べておくと安心です。
Gemini 3.8 Flashは、開発者向けのAPIと、一般ユーザー向けのアプリの両方から利用できます。
APIを使う場合は、まず「Google AI Studio」でAPIキーを取得します。基本的な手順は次のとおりです。
画面の表記は更新される場合があるため、詳細は公式のドキュメントをご確認ください。APIキーは第三者に知られると不正利用につながるため、コードに直接書き込まず、環境変数などで管理するのが基本です。
また、AI Studioのチャット画面でモデルに「gemini-3.8-flash」を指定すれば、コードを書かずにプロンプトを試すこともできます。
APIキーを用意したら、SDK(開発用のライブラリ)をインストールして呼び出します。Pythonの場合、公式ドキュメントで案内されているInteractions APIを使った例は次のとおりです。
# SDKのインストール:pip install -U google-genai

from google import genai
client = genai.Client() # 環境変数のAPIキーを利用
interaction = client.interactions.create(
model=”gemini-3.8-flash”,
input=”次の議事録を3行で要約してください。”,
generation_config={“thinking_level”: “low”}, # low / medium / high
)
print(interaction.output_text)
モデルIDは「gemini-3.8-flash」です。これまでGemini 3系のモデルを使っていた場合は、移行時に次の点を確認しましょう。
費用面では、導入価格(入力0.75ドル/出力3.75ドル)が2026年12月31日までの期間限定である点に注意が必要です。2027年1月1日からは、入力1.50ドル/出力7.50ドルに切り替わるため、長期の運用では標準価格での試算も済ませておきましょう。
プログラミングをしない方は、Geminiアプリ(gemini.google.com)などから利用できます。Googleの発表では、Google AI ProおよびUltraの登録ユーザーが、次のサービスで3.8 Flashを使えるとされています。
無料プランについては、3.8 Flashの提供対象として案内されていません(2026年10月時点)。提供範囲は変更される可能性があるため、利用中のプランで選べるモデルは、アプリ内の表示や公式ヘルプで確認してください。
Gemini 3.8 Flashの性能を引き出すには、モデルの特性に合わせたプロンプト(指示文)の工夫が欠かせません。
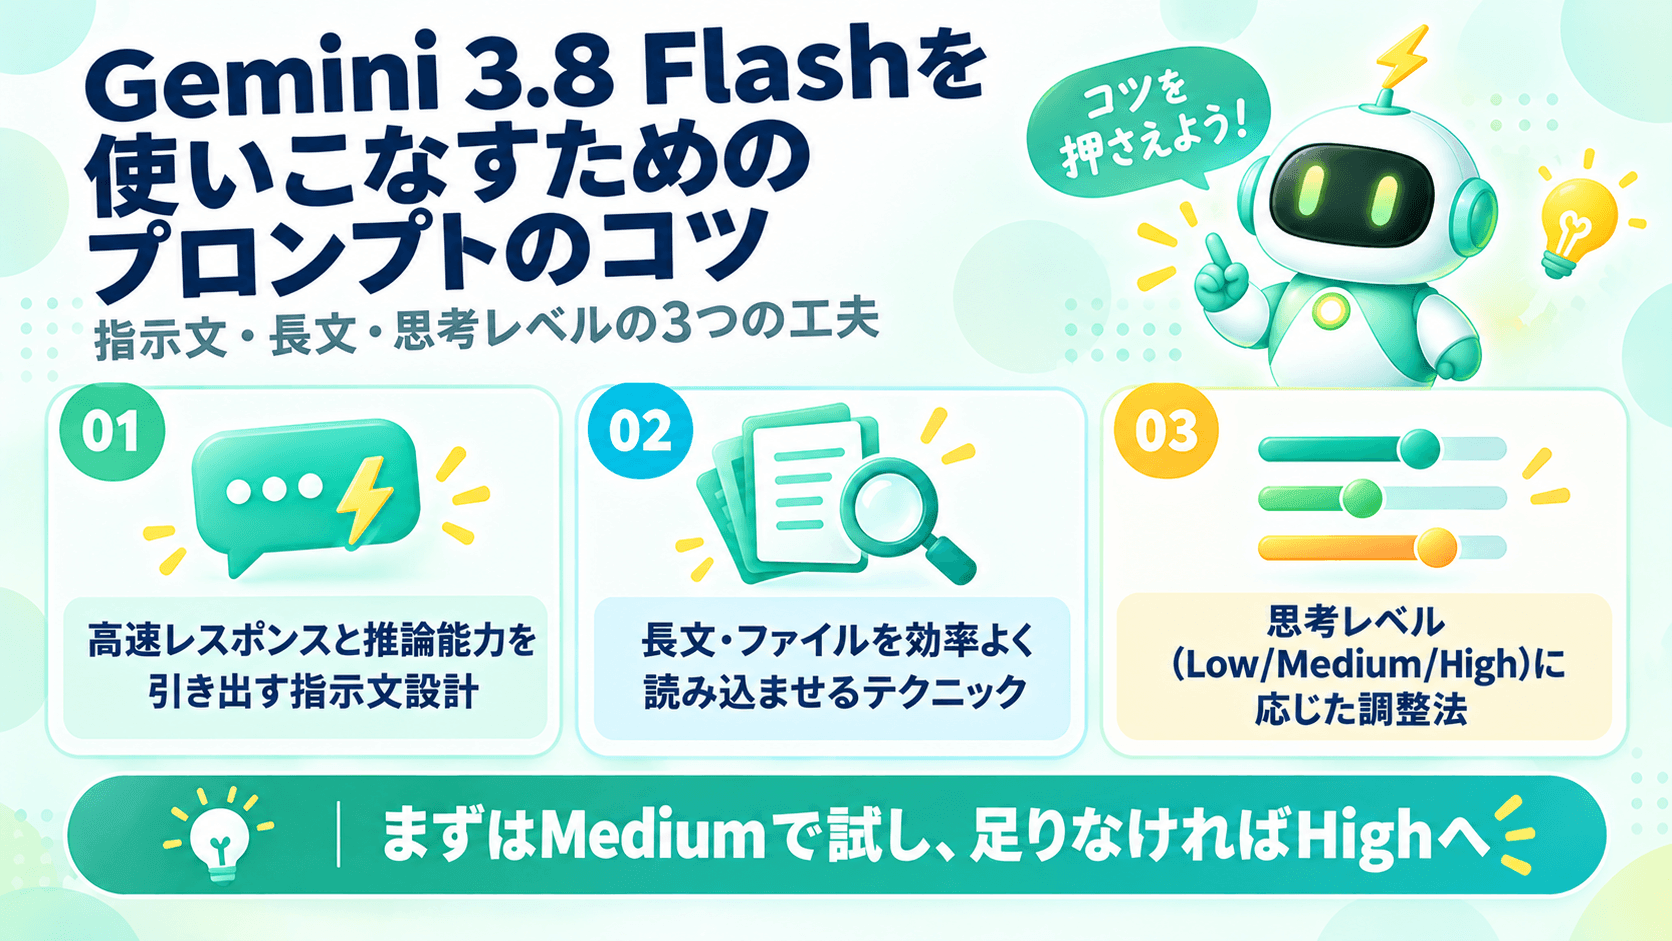
3.8 Flashは「熱心に処理する」設計のため、指示があいまいだと、必要以上に調べたり、考えたりしてしまうことがあります。そこで、次の4点を明確に伝えるのがコツです。
とくに完了条件は、エージェント用途でツールの呼び出しが際限なく増えるのを防ぐうえで有効です。また、サンプリングパラメータ(temperatureなど)は非推奨になっているため、出力の調整はパラメータではなく、プロンプトと思考レベルで行うのが基本です。
100万トークンのコンテキストを使いこなすには、情報の「置き方」がポイントになります。
大きなファイルの扱いには、APIの「Files API」や、同じ資料を繰り返し使う場合に費用を抑える「コンテキストのキャッシュ保存」も活用できます。なお、日本語は英語よりトークン数が多くなりやすいため、事前に「トークンのカウント」機能で量を確認しておくと安心です。
思考レベルによって、プロンプトの書き方も少し変えると効果的です。
| 思考レベル | プロンプトのコツ | 注意点 |
|---|---|---|
| Low | 短く具体的に指示し、出力形式を固定する。判断が不要なタスクに絞る | 複雑な推論には向かないため、精度が足りなければMediumへ |
| Medium | 目的・制約・完了条件をバランスよく書く。コード生成やエージェント用途の基本設定 | まずはここから試す |
| High | 難しい課題を渡し、「前提を整理し、結論を出す前に自分で検算する」などを指示する | トークン消費と待ち時間が増えるため、必要な場面に限定する |
ポイント:最初から常にHighにするのではなく、Mediumで試し、足りないときだけ引き上げるのが、コストと精度のバランスを取る近道です。
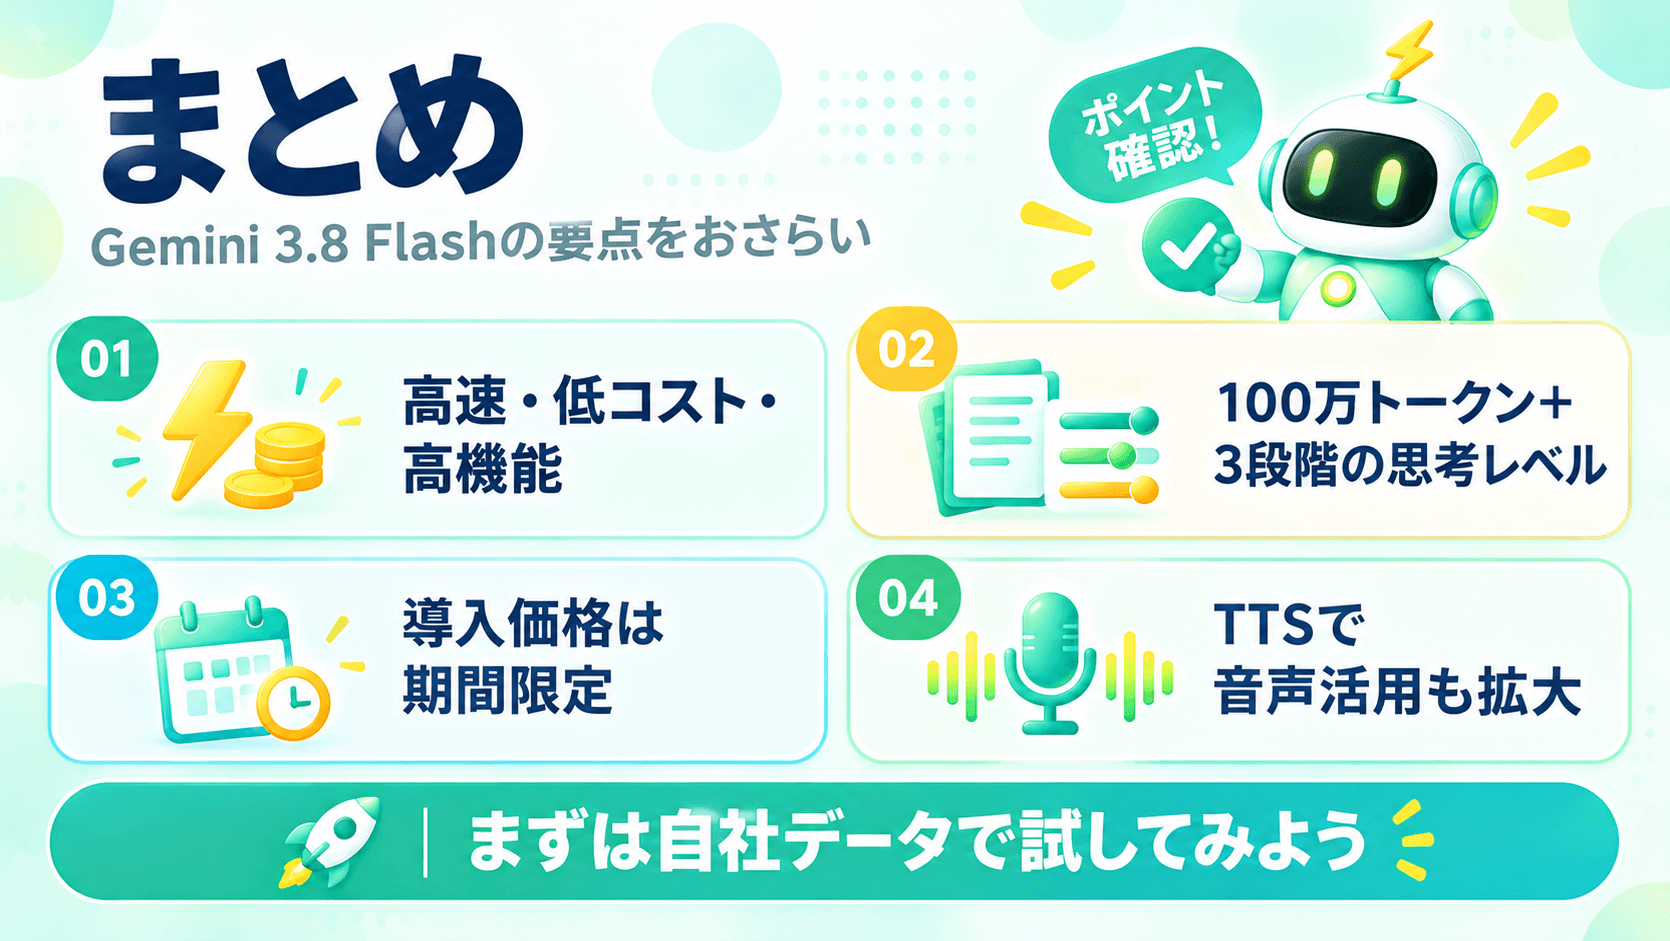
ここまで、Gemini 3.8 Flashの特徴から使い方、プロンプトのコツまで解説してきました。要点を振り返ります。
AIモデルの進化が加速するなか、「高性能なモデルは高い」という常識は変わりつつあります。とくに、導入価格が適用される2026年内は、検証を始める絶好のタイミングです。まずはGoogle AI Studioで自社の業務データを使って試し、思考レベルを調整しながら、費用と精度のバランスを見極めてみてください。そのうえで、問い合わせ対応や文書処理、アプリ開発など、効果の出やすい業務から導入を進めていきましょう。
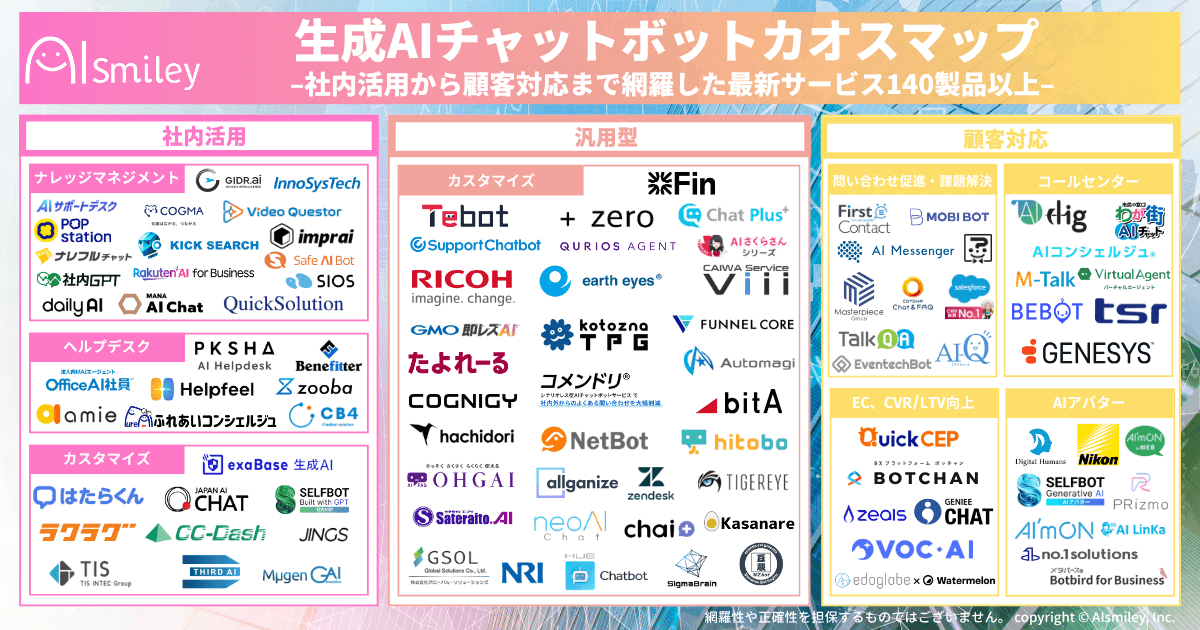
アイスマイリーでは、生成AI のサービス比較と企業一覧を無料配布しています。課題や目的に応じたサービスを比較検討できますので、ぜひこの機会にお問い合わせください。
業務の課題解決に繋がる最新DX・情報をお届けいたします。
メールマガジンの配信をご希望の方は、下記フォームよりご登録ください。登録無料です。


FOLLOW US
SNSをフォローして、最新情報をチェックできます!


AI製品・ソリューションの掲載を
希望される企業様はこちら