


生成AI
最終更新日:2026/10/05
 SLM(小規模言語モデル)とは?
AI技術の進化に伴い、多くの生成AI言語モデルが登場しています。ChatGPTを筆頭とする生成AIツールの多くはLLM(大規模言語モデル)をベースにしていますが、自然言語処理が可能なAIモデルには「SLM(小規模言語モデル)」もあります。LLMとSLMとでは特性が異なり、ビジネスにおける活用では最適なモデルの選定が重要です。
本記事では、SLMの概要からLLMとの違い、小型化の仕組み、メリット・デメリットなどについてわかりやすく解説します。SLMの活用シーンや大手企業の開発事例も紹介しますので、SLMについて理解を深め、自社におけるAI活用を促すためにお役立てください。
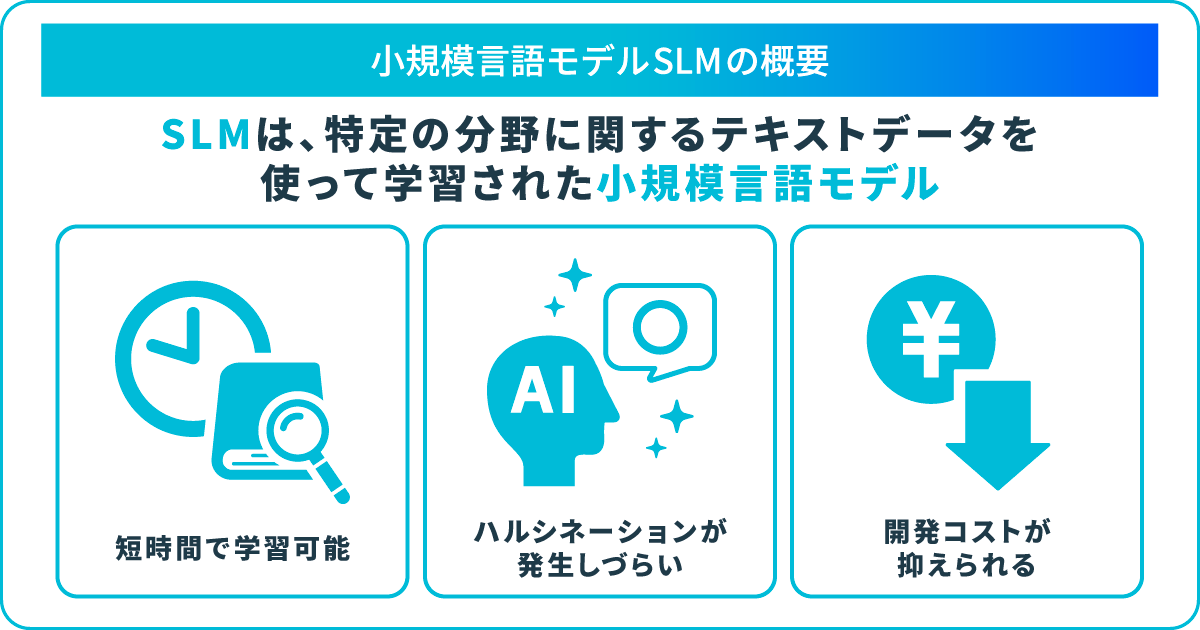
SLM(Small Language Model)とは、日本語で「小規模言語モデル」と訳される言葉です。LLM(大規模言語モデル)と同じく文章の理解や生成を行う言語モデルで、モデルの規模を表すパラメータ数がLLMより少ない点が異なります。
SLMとLLMを分ける明確な基準はなく、一般には数億〜数十億程度のパラメータを持つモデルがSLMと呼ばれます。Microsoft社は、140億パラメータの「Phi-4」もSLMのシリーズの1つとして公開しています。
SLMには、幅広い用途に使える汎用型のモデルと、医療や法律など特定の分野・業務に合わせて追加学習(ファインチューニング)させたモデルがあります。LLMより少ない計算資源で動かせるため、クラウドだけでなく、自社のサーバー・PC・スマートフォンなどの端末上でも利用しやすい点が特徴です。
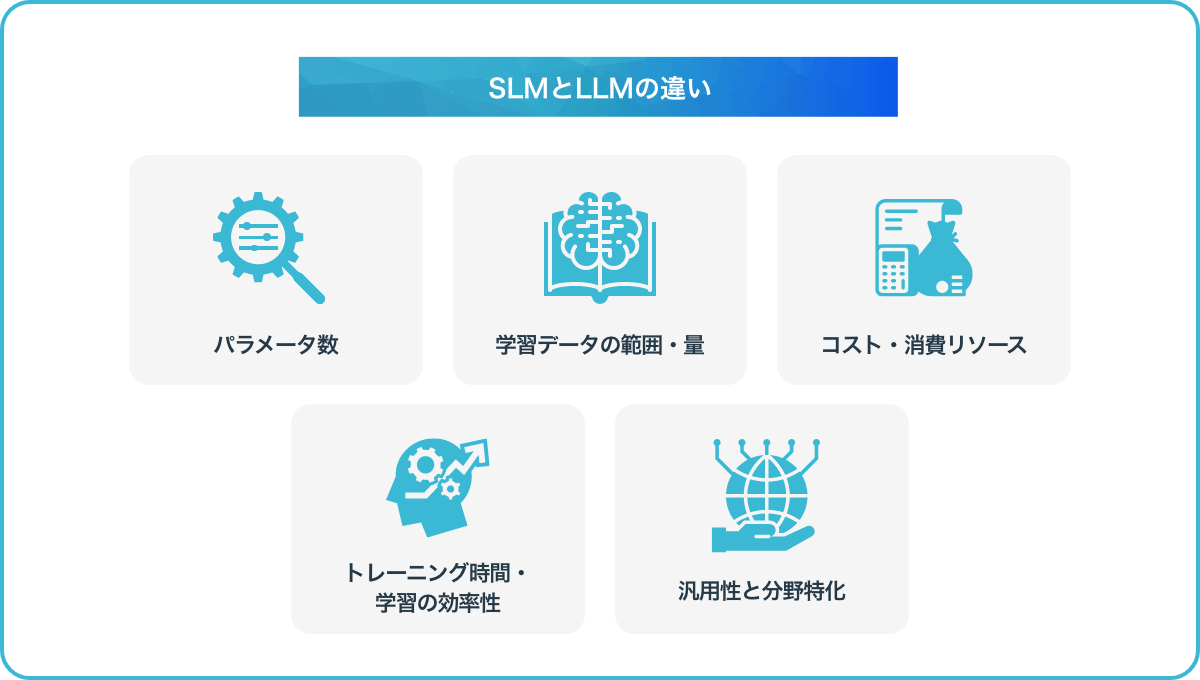
SLMとLLMは、どちらもTransformer(トランスフォーマー)と呼ばれる仕組みをベースにした言語モデルです。同じ仕組みでもモデルの規模が異なるため、学習に必要なデータ・計算資源や、得意とする用途に違いが生まれます。
SLMは、LLMよりも少ないパラメータ数で構成されています。パラメータとは、学習によって調整されるモデル内部の数値(重み)のことで、一般に数が多いほど多くの知識や複雑な処理を扱えるようになります。
例えば、Meta社が2024年7月に公開した「Llama 3.1」の最大モデルは4,050億パラメータ、Microsoft社が2025年2月に公開したSLM「Phi-4-mini」は38億パラメータです。なお、OpenAI社の「GPT-4」のように、パラメータ数を公表していないLLMもあります。
SLMとLLMとでは、AIが学習するデータの範囲や量にも差があります。LLMは、インターネット上の膨大なテキストデータを学習しており、幅広いタスクに対応できる仕様です。例えばLlama 3.1の最大モデルは、15兆を超えるトークン(文章を細かく区切った単位)で学習されています。
一方、SLMの学習データはLLMより少ないものの、Phi-4-miniでも5兆トークンで学習されており、特定の分野だけを学んでいるわけではありません。量で劣る分、質の高い公開文書や教科書のように作成した合成データを選んで学習させ、少ないパラメータでも推論力を保つ工夫が取り入れられています。特定の分野に強いSLMは、汎用のSLMに医学論文や契約書などの専門データを追加学習させてつくることもできます。
SLMは、LLMよりもモデルサイズが小さい分、開発にかかるコストや運用中の消費リソースが少なくて済みます。AIはパラメータ数が多くなるほど、必要な計算リソースが増える傾向にあり、
LLMでは膨大なメモリやエネルギーを消費します。一方のSLMは、求められるGPUの性能やエネルギー消費量が低めです。
パラメータ数が少ないSLMは、学習に必要な計算資源もLLMより大幅に少なくて済みます。Llama 3.1の最大モデルの学習には1万6,000基を超えるGPU(NVIDIA H100)が使われた一方、Phi-4-miniの学習に使われたGPU(NVIDIA A100)は512基です。
ただし、ゼロから学習させる場合は、SLMでも短期間では終わりません。Phi-4-miniの学習に21日間を要しています。企業が自社向けのSLMを用意する場合は、公開済みのSLMをベースに自社データで追加学習させる方法を取れば、学習にかかる時間やコストをさらに抑えられます。
LLMは幅広い知識を持ち、複雑な推論や多様なタスクに対応できます。一方SLMは、知識の幅ではLLMに及ばないものの、対象を絞って追加学習させることで、特定の業務では十分な精度を出しやすくなります。
そのため、どちらか一方だけを選ぶのではなく、両者を組み合わせる使い方もあります。例えば、定型的な問い合わせ対応や文書の要約はSLMで処理し、複雑な分析や判断を伴う依頼だけをLLMに振り分ければ、精度を保ちながらコストを抑えられます。
LLMの基本情報については、下記記事で詳しく解説していますのであわせてご覧ください。
関連記事:大規模言語モデル(LLM)とは?仕組み・種類・活用サービス・課題をわかりやすく解説
SLMは、LLMと同じ構造のまま規模を小さくした言語モデルです。ただし、パラメータ数を減らすだけでは性能も下がりやすいため、開発では、性能をできるだけ保ちながらモデルを小さく軽くする技術が組み合わされています。
知識蒸留は、大きなモデル(教師モデル)の出力を手本にして、小さなモデル(生徒モデル)を学習させる手法です。生徒モデルは教師モデルの回答の傾向をまねることで、自力で学習するよりも高い性能を身につけやすくなります。IBM社は、知識蒸留を多くのSLMで一般的に使われている手法として紹介しています。
例えば、Sakana AI社が2025年1月に公開した日本語のSLM「TinySwallow-1.5B」は、320億パラメータのLLMを教師モデルとした独自の蒸留手法で学習されています。スマートフォンでもオフラインで動作します。
関連記事:Sakana AI、高性能かつ小規模な日本語言語モデルを発表。スマートフォンやPCでも動作可能に
量子化は、モデル内部の数値を表すビット数を減らし、データ量と計算量を抑える手法です。例えば、32ビットの浮動小数点数を8ビットの整数に置き換えると、数値を保存する容量はおよそ4分の1になります。数値の細かさが失われる分、性能の低下を抑えながら量子化する工夫が必要です。
Apple社は、iPhoneなどの端末上で動かす言語モデルを、学習の段階から量子化を前提に訓練し、1パラメータあたり2ビットまで圧縮しています。
プルーニングは、性能への影響が小さいパラメータを取り除き、モデルを軽くする手法です。庭木の不要な枝を切り落とす作業になぞらえて「枝刈り」とも呼ばれます。取り除きすぎると性能が落ちるため、プルーニングの後に追加学習を行い、精度を回復させるのが一般的です。
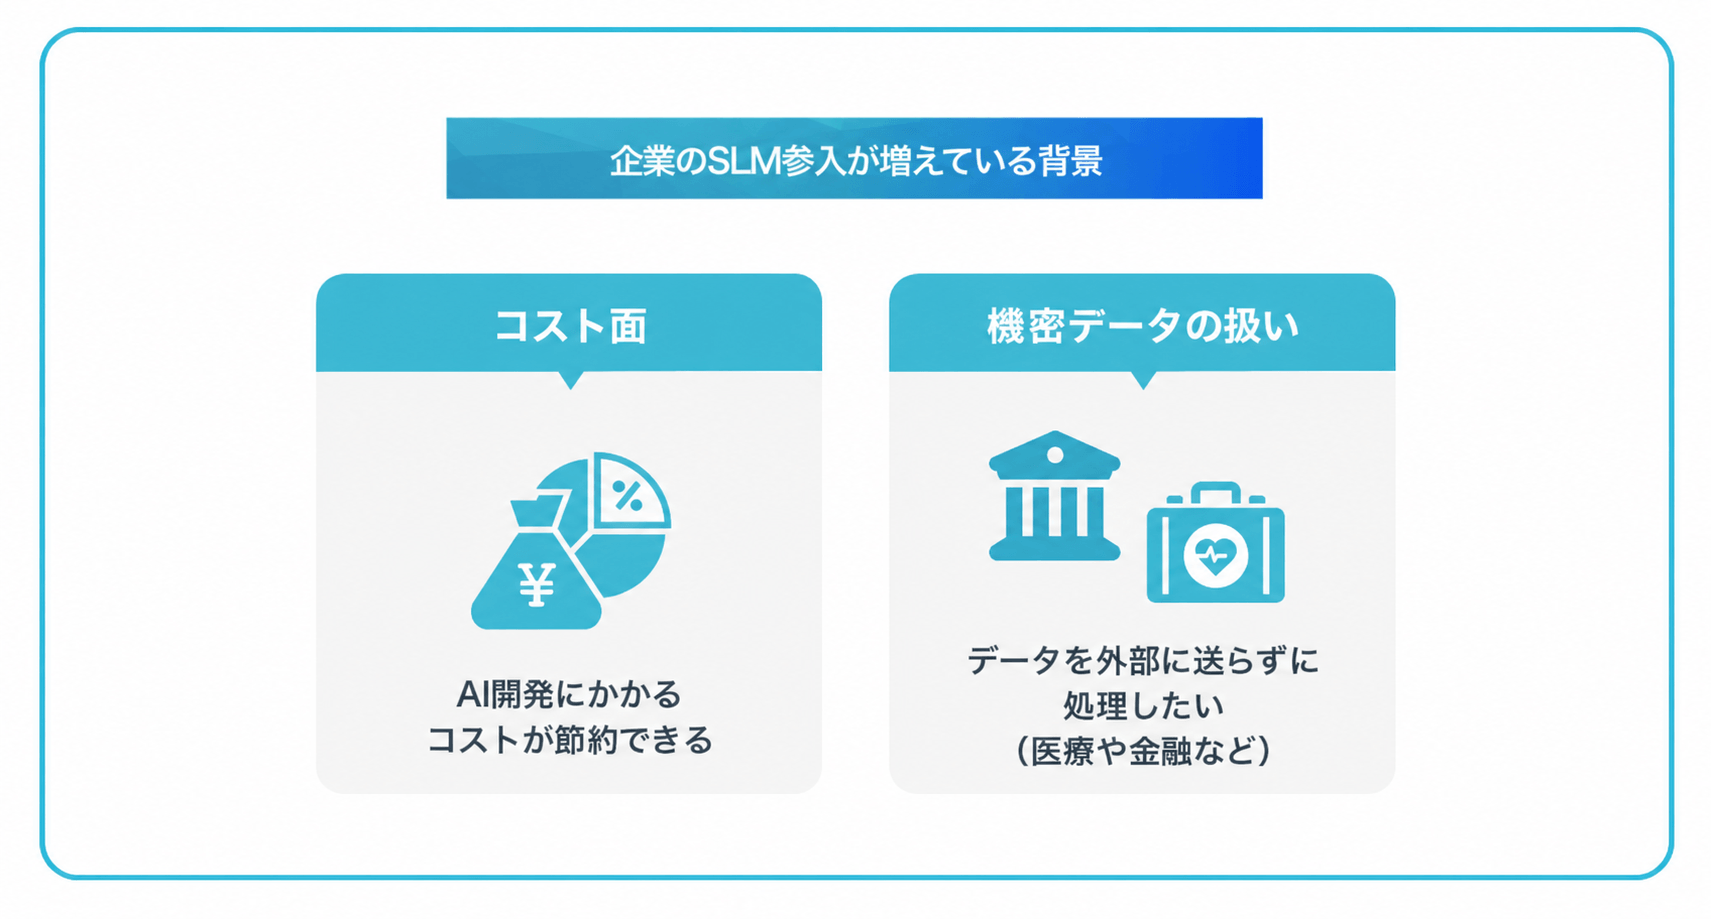
さまざまな企業や業界でSLMの開発や導入が増加している背景には、AIの開発・運用にかかるコストの節約や、業務に特化したAIへの需要、端末上で動くAIへのニーズの高まりなどが挙げられます。
汎用性の高いLLMは急速な進化を遂げ、多くのサービスがひっきりなしに一般公開されています。しかし、LLMを導入する際に膨大なコストがかかる点が企業におけるネックとなっているのも事実です。
AIの開発や導入に必要なコストを用意できる企業は限られる上、AIの費用対効果を重視すると、コストを抑えられるSLMが有力な選択肢になりつつあるのです。実際に、巨大テック企業からスタートアップまでSLMを手掛ける企業は増加しています。
業務に特化したAIへの需要も、SLMが注目される理由の1つです。調査会社のGartner社は2025年4月、2027年までに企業が使う小規模でタスク特化型のAIモデルの使用量が、汎用LLMの少なくとも3倍に達するとの予測を発表しました。汎用LLMは特定の業務領域の文脈を必要とするタスクで回答の正確性が下がる傾向があり、業務や分野ごとのデータで微調整したモデルへの移行が進むとしています。
また、スマートフォン・PCの上で直接AIを動かしたいというニーズも高まっています。端末上で処理すれば通信環境に左右されず、データを外部に送らずに済むため、医療や金融のように機密性の高い情報を扱う領域とも相性が良い方法です。限られたメモリや電力で動かせるSLMは、端末上での処理に適しています。
SLMは、性能の上限ではLLMに及ばない一方、動かすために必要な資源が少ないことから、コスト・応答速度・データの管理といった面で導入しやすさがあります。
SLMは、動かすために必要なGPUやメモリが少なくて済むため、開発や運用にかかるコストを抑えられます。高価なGPUサーバーを用意しなくても、一般的なサーバーやPCで動かせるモデルもあります。
規模の小さいSLMであれば、自社データを使った追加学習を、LLMより少ない計算資源と短い時間で行えます。社内用語や業界特有の表現を覚えさせたり、決まった形式に沿って回答させたりといった調整がしやすく、契約書のチェックや問い合わせへの回答文の作成など、対象を絞った業務に合わせたモデルをつくれます。
調整の負担が小さい分、試しに学習させて精度が足りなければデータを見直して再学習する、といった改善を繰り返しやすい点もメリットです。
SLMは1回の処理に必要な計算量が少ないため、LLMよりも回答を返すまでの時間が短くなります。チャットボットでの問い合わせ対応・音声アシスタント・入力中の文章の補完など、利用者を待たせたくない場面で有利です。端末上で動かす場合は、クラウドとデータをやり取りする通信時間もかかりません。
必要なメモリや電力が少ないSLMは、スマートフォン・PCなどの端末に組み込んで動かせます。AIを端末側で処理する仕組みはエッジAIと呼ばれ、インターネットに接続していない環境でもAIを使える点が特徴です。
Google Pixel 8以降などの一部のAndroid端末には「Gemini Nano」、Windows 11のCopilot+ PCには「Phi Silica」という、端末内で動く小型の言語モデルがすでに搭載されています。Microsoft社によると、Phi SilicaはOutlookのオフラインでの要約機能などに使われています。
自社のサーバーや社内のPCでSLMを動かせば、入力したデータを外部のクラウドサービスに送らずにAIを利用できます。顧客情報・診療記録・社外秘の技術資料など、社外に出せない情報を扱う業務でも生成AIを導入しやすくなります。
クラウド型のLLMでも、入力データを学習に使わない設定や契約によって情報漏えいのリスクは下げられます。ただし、データを社外に送ること自体が社内規程で認められていない場合は、社内で処理が完結するSLMが有力な選択肢になりま
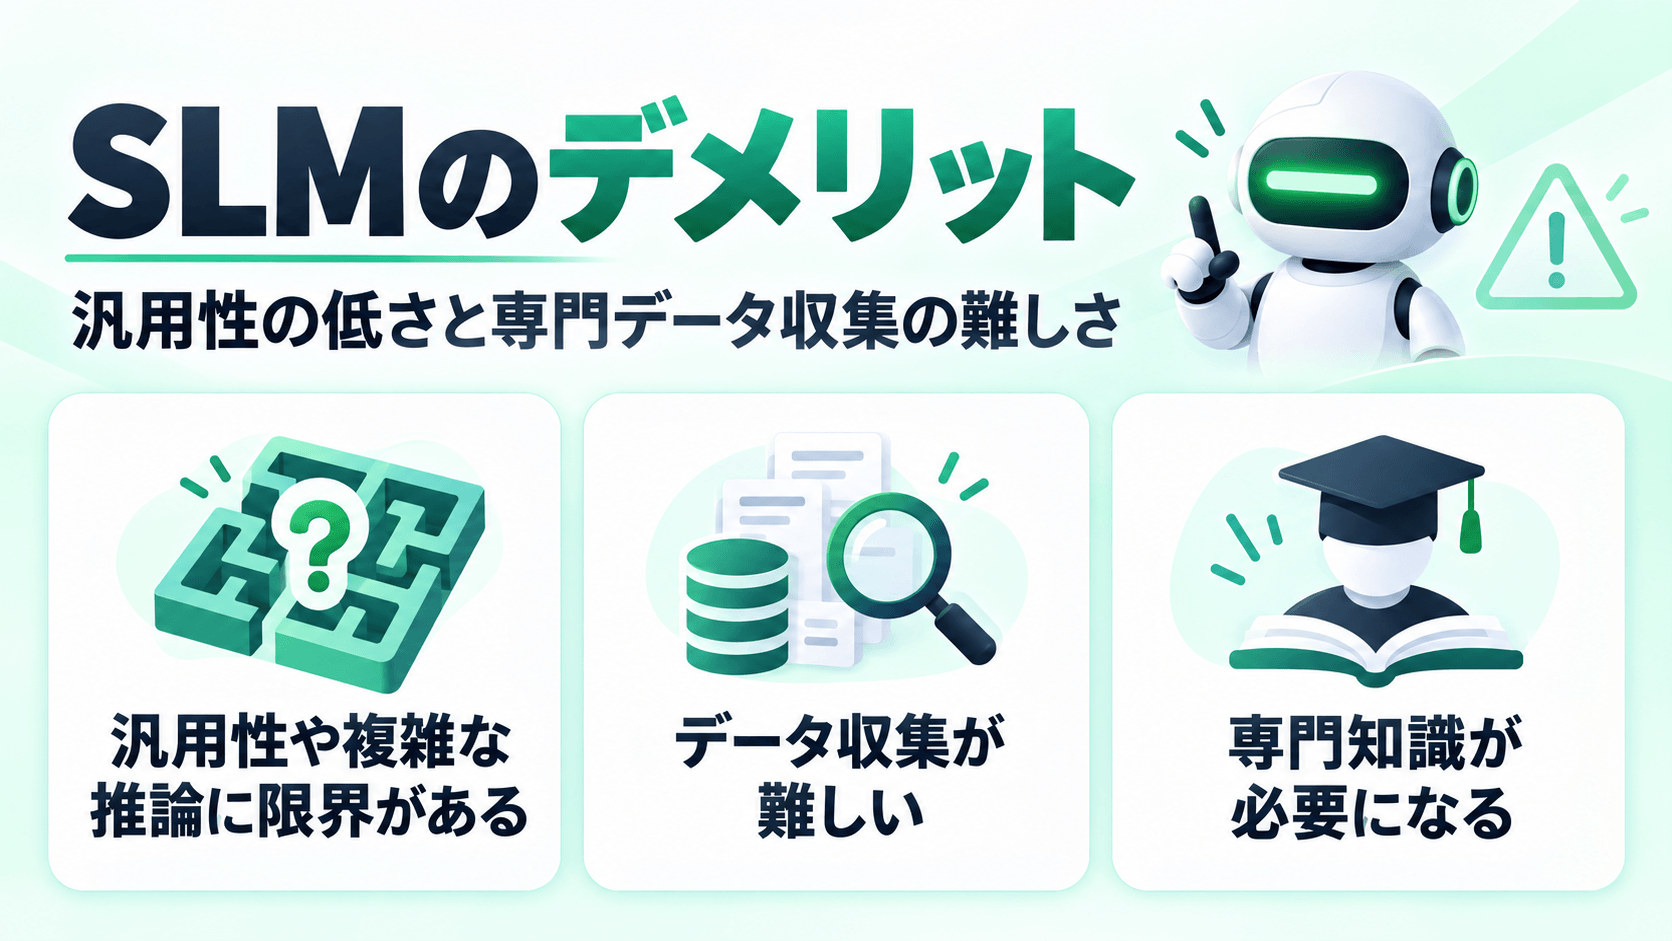
SLMには多くのメリットが期待できる反面、デメリットもあります。導入前に、SLMでは対応が難しい業務がないか、社内で開発・運用できる体制があるかを確認しておく必要があります。
SLMは持っている知識の量がLLMより少ないため、幅広い分野の質問に答えたり、複数の手順を踏む複雑な推論を行ったりするのは苦手です。特定の業務向けに調整したSLMは、学習させた領域以外の質問に正しく回答できない場合があります。
異なるジャンルに対応させたい場合には、別のSLMを用意する必要があります。
SLMを特定の業務に合わせて調整する場合、学習に用いる専門分野のデータを集めるのに苦労する可能性があります。AIは、高品質なトレーニングデータを十分に利用することで、性能が高まりますが、SLMの対象分野のデータを入手することが難しい場合もあり、トレーニングが思うように進まないことが考えられます。
特に、医療や金融といった機密性の高い情報を扱う場合、収集できるデータには限りがあるため、トレーニングに時間を要する場合もあります。
SLMを開発・運用するには、高度な専門知識やスキルを要します。学習データの選定・事前の処理・トレーニング・モデルの評価など、SLMを正式にリリースするまでには専門家の協力が不可欠です。
専門家レベルの担当者がいない場合は、外部に委託するなどの対応が必要となります。
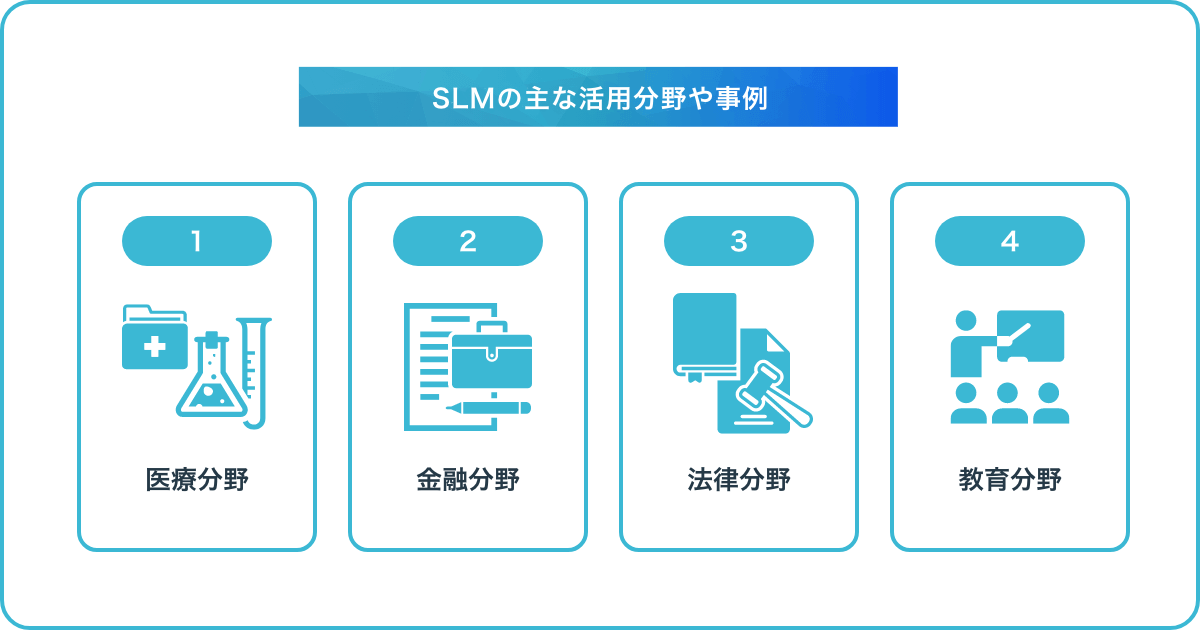
SLMは、すでにさまざまな分野で実用化や研究開発が進んでいます。専門用語や独特の言い回しが多い分野では、汎用のモデルをそのまま使うよりも、分野ごとの文書で学習させたモデルのほうが精度を出しやすいため、業界ごとに専用のモデルが開発されています。
医療分野では、診療記録の要約や医療画像のレポート作成支援などへの言語モデルの活用が研究されています。Google社は2025年、医療向けのテキストと画像の理解に特化したオープンモデル「MedGemma」を公開しました。2026年1月に公開された40億パラメータの「MedGemma 1.5」では、CT・MRIの画像や検査報告書の読み取りにも対応しています。
ただし、MedGemmaは開発者向けのモデルで、Google社は臨床で使う前に用途ごとの検証が必要だと明記しています。医療分野でSLMを使う場合は、最終的な判断を医師が行う前提で導入を検討することになります。
金融分野では、決算資料やニュース記事などの文書分析に、金融の文章で学習させた言語モデルが使われています。代表例が、言語モデル「BERT」(Baseモデルは約1億1,000万パラメータ)を金融分野の文章で追加学習させた「FinBERT」です。
FinBERTは、金融関連の文章がポジティブ・ネガティブ・中立のどれに当たるかを判定できます。企業に関するニュースや決算発表への市場の受け止め方を把握するなど、大量の文書を人手で読む作業の効率化に役立ちます。
法律分野では、法律特有の専門用語や複雑な文章が多い書類のレビューなどへの言語モデルの活用が進んでいます。契約書のように専門用語や特有の言い回しを含む文書を、正しくレビューするためには高度な知識が必要です。
法律分野の代表的なモデルには「LEGAL-BERT」があります。EUと英国の法令に加え、欧州と米国の判例や米国の契約書など、12GB分の英語の法律文書で学習させたモデルで、法律分野の自然言語処理の研究やリーガルテックへの応用を目的に公開されています。日本語の契約書に使う場合は、日本語の法律文書による追加学習が別途必要です。
教育分野では、学習者一人ひとりの理解度に合わせて解説やヒントを返すAIチューターへの活用が期待されています。利用者の多い学習サービスに組み込む場合、1回あたりの処理コストが低いSLMは運用費を抑えやすい選択肢です。
2024年5月には、米国の非営利教育団体Khan AcademyとMicrosoft社が、Phi-3をベースにした数学の個別指導向けSLMの開発を共同で検討すると発表しました。発表の中でMicrosoft社は、Phi-3のようなSLMについて、比較的シンプルなタスクで十分な性能を発揮でき、大きなモデルよりもコスト効率に優れる点を利点に挙げています。
LLMよりも低コストで開発できるSLMは、大手IT企業も力を注ぐ分野です。自社のLLMと並行してSLMを開発し、オープンモデルとして無償公開したり、自社のスマートフォンやPCに組み込んだりする動きが広がっています。
Microsoft社は、SLMの開発に早くから取り組んできた企業の1つです。2023年6月の「Phi-1」に始まり、2024年4月の「Phi-3」を経て、2024年12月には140億パラメータの「Phi-4」を発表しました。現在はPhi-4シリーズとして、用途の異なる複数のモデルが公開されています。
| モデル名 | 公開時期 | パラメータ数 | 主な特徴 |
|---|---|---|---|
| Phi-4 | 2024年12月 | 140億 | 複雑な推論に強いテキストモデル |
| Phi-4-mini | 2025年2月 | 38億 | 日本語を含む23言語に対応した軽量モデル |
| Phi-4-multimodal | 2025年2月 | 56億 | テキスト・画像・音声を1つのモデルで処理 |
| Phi-4-reasoning | 2025年4月 | 140億 | 段階的に考えてから回答する推論モデル |
| Phi-4-mini-reasoning | 2025年4月 | 38億 | 数学の推論に特化した軽量モデル |
| Phi-4-reasoning-vision-15B | 2026年3月 | 150億 | 画像の内容をもとに推論するモデル |
関連記事:Microsoft、小規模言語モデル「Phi-3」ファミリーにマルチモーダルなSLM「Phi-3-vision」を追加
Google社の「Gemma」は、同社の「Gemini」と同じ研究・技術をもとに開発されたオープンモデルのシリーズです。2024年2月に初代が公開された後、Gemma 2・Gemma 3と改良が重ねられ、2026年4月には最新の「Gemma 4」が公開されました。
Gemma 4は当初、スマートフォンなどの端末向けの「E2B」「E4B」と、より高い性能が求められる用途向けの「26B A4B」「31B」の4モデルで構成されていました。2026年6月には、画像や音声などを扱うマルチモーダル処理向けの「12B」も追加されています。E2B・E4Bは処理に使う実効パラメータ数を約20億・約40億に抑えた軽量モデルで、スマートフォンやRaspberry Piといった小型の機器でもオフラインで動作します。
ライセンスはGemma 4からApache 2.0に変わり、商用利用や改変・再配布がしやすくなりました。140を超える言語で学習されており、日本語にも対応しています。
関連記事:Gemma 4とは?性能・アーキテクチャ・使い方を徹底解説
関連記事:DataGemmaとは?ハルシネーション対策モデルの特徴や機能を紹介
Apple社は2024年6月、生成AI機能「Apple Intelligence」を支える独自の基盤モデル「Apple Foundation Models」を発表しました。発表されたモデルには、iPhoneやMacなどの端末上で動く約30億パラメータの言語モデルが含まれます。文章の要約や書き換えといった処理を端末内で行い、より高度な処理はApple社のサーバー(Private Cloud Compute)で行う仕組みで、個人データを保護しながらAIを使える点を重視しています。
2025年6月には、アプリ開発者が端末上のモデルを自社のアプリに組み込める「Foundation Models」フレームワークも発表されました。2026年6月に発表された第3世代では、30億パラメータの「AFM 3 Core」に加え、「AFM 3 Core Advanced」がオンデバイスモデルとして加わりました。AFM 3 Core Advancedは200億パラメータを持ちながら、処理ごとに10億〜40億だけを動かす仕組みです。
関連記事:Apple Intelligenceとは?特徴やできること、今後の動きについて解説
SLMとLLMの主な違いはモデルの規模で、LLMは一般に数百億〜数兆、SLMは数億〜数十億のパラメータで構成されています。SLMは幅広い知識や複雑な推論ではLLMに及ばないものの、少ない計算資源で動かせるため、開発・運用コストを抑えやすく応答も速いのが特徴です。特定の業務に合わせて追加学習させやすい点もSLMの強みです。
企業がSLMを用意する場合は、ゼロから開発するよりも、公開済みのSLMを自社向けに調整する手法方法が取り組みやすく、おおまかな流れは次のとおりです。
費用は、学習や運用に使うGPU環境・データの準備・担当者の人件費などで決まり、対象業務や求める精度によって大きく変わります。ゼロから事前学習する場合は、SLMでも数百基規模のGPUを数週間使った例があり、大規模な計算設備と費用がかかります。
動かせます。OllamaやLM Studioといった無料で使えるツールを利用すれば、PhiやGemmaなどの公開済みSLMをWindowsやMacのPCにダウンロードして利用できます。必要なメモリはモデルの大きさや量子化の程度によって変わるため、利用するモデルの推奨環境を事前に確認してください。
あります。本文で紹介したPhi-4-mini・Gemma 4・TinySwallow-1.5Bは日本語にも対応しています。このほか、ソフトバンク傘下のSB Intuitions社は、日本語の性能を重視したSLM「Sarashina2.2」を2025年3月に公開しています。5億・10億・30億パラメータの3サイズがあり、MITライセンスのため商用利用も可能です。
SLMは、LLMより少ないパラメータで構成された言語モデルです。知識蒸留や量子化などの技術で性能を保ちながら小型化されており、少ない計算資源で動かせるため、コスト・応答速度・データ管理の面でLLMより有利な点があります。業務に合わせた調整もしやすく、医療・金融・法律といった専門性の高い分野や、スマートフォン・PCなどの端末上での活用が広がっています。
ただし、幅広い知識や複雑な推論が求められる業務にはLLMのほうが向いています。用途や目的に応じてSLMとLLMを使い分け、必要に応じて組み合わせることで、費用対効果を高められます。
アイスマイリーでは「生成AIサービスの提供企業一覧」を無料でご請求いただけます。自社の生成AI活用により、業務効率化や生産性の向上を目指すために、ぜひお役立てください。
SLMとLLMとでは、パラメータ数や開発コスト、トレーニング時間などが異なります。SLMはLLMよりもモデルのサイズが小さく、その分開発コストが抑えられています。
また、SLMは特定の分野やタスクに特化しており、計算に必要なリソースやエネルギー消費も少なくて済む点も特徴です。SLMは、専門知識を学習することで特定のジャンルに関して優れた性能を発揮します。
SLM開発のおおまかな流れは、次の通りです。
1.対象分野を選定する
2.学習データの収集・事前処理を行う
3.モデルアーキテクチャを選定、設計する
4.モデルのトレーニングを実施する
5.ファインチューニングで調整する
6.評価と改善を行う
SLMの開発にかかる費用は、対象分野や求められる性能、トレーニングデータの規模などで異なります。中には、専門家の人件費を含めて合計で数千万円かかるケースもあります。
業務の課題解決に繋がる最新DX・情報をお届けいたします。
メールマガジンの配信をご希望の方は、下記フォームよりご登録ください。登録無料です。


FOLLOW US
SNSをフォローして、最新情報をチェックできます!



AI製品・ソリューションの掲載を
希望される企業様はこちら